GPU: RTX 5070 Ti 16GB / WSL2 / Ollama 0.32.15
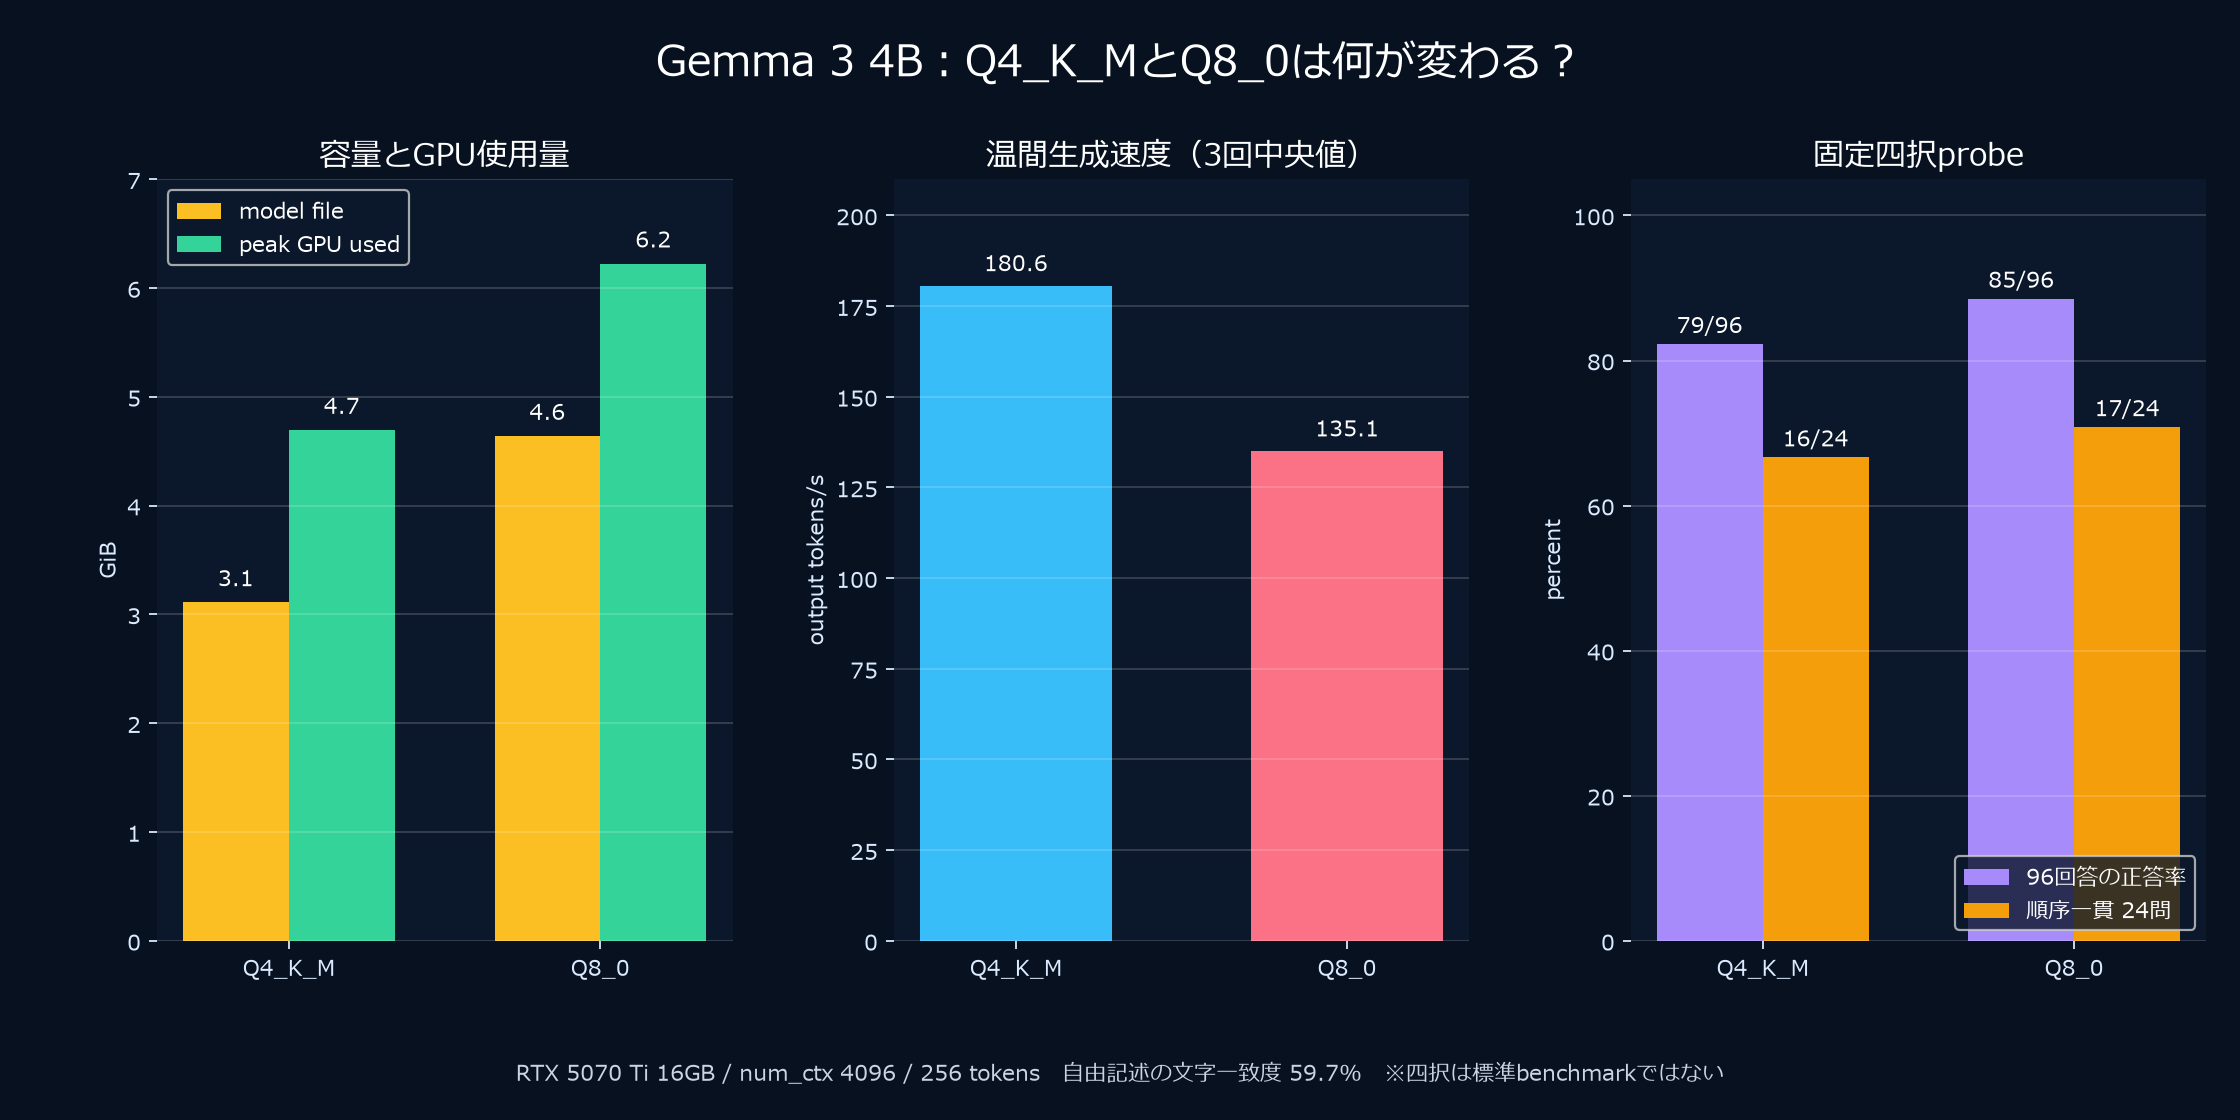
Gemma 3 4BのQ4_K_MとQ8_0を、同じPCで動かして比べました。Q8にするとGPU使用量が約1.5 GiB増え、生成速度は180.6から135.1 tok/sへ落ちました。
回答にも差はありました。自作の四択24問を、選択肢の並びを変えて4回ずつ尋ねたところ、Q4は79/96、Q8は85/96の正解です。同じ問題の繰り返しなので、まずはどの質問で答えが変わったのかを見ます。
Q4とQ8の差
| 指標 | Q4_K_M | Q8_0 | Q8の変化 |
|---|---|---|---|
| モデルファイル | 3.11GiB | 4.64GiB | +49.2% |
| ピーク GPU used | 4,806MiB | 6,372MiB | +32.6% |
| ウォームアップ後生成速度 | 180.6 tok/s | 135.1 tok/s | -25.2% |
| ウォームアップ後 TTFC | 57.0ms | 54.0ms | ほぼ同じ |
| 再読み込み | 2.02秒 | 2.01秒 | ほぼ同じ |
| 固定四択試験 | 79/96 | 85/96 | +6回答 |
| 順序一貫の問題 | 16/24 | 17/24 | +1問 |
このPCなら通常はQ4_K_Mから始めます。180 tok/sと高速で、Q8より約1.5GiB少ないVRAMで動くからです。四択試験のような課題でQ4の誤りが実害になると確認できた場合にQ8へ上げます。
量子化は何を削っているのか
ニューラルネットの重みは実数です。高精度なfloatで保存すると多くのbitが必要です。量子化では、重みを限られた離散値へ写像して少ないbitで表します。
単純化した対称量子化なら、ブロック内の重み wをスケール sで割って整数へ丸めます。
q = round(w / s)
w_hat = s × q
qのbit数を減らすほど保存容量は減りますが、復元値w_hatと元のwの差、つまり量子化誤差は一般に大きくなります。
今回の種類です。
gemma3:4b-it-q4_K_M  → Q4_K_M
gemma3:4b-it-q8_0    → Q8_0
どちらも同じGemma 3 4B instruction-tuned モデルです。/api/showで構造、4.3B パラメータ、templateを確認し、量子化段階だけが異なる組を使いました。
Ollama公式のGemma 3 tagsでは、4BのQ4_K_Mが3.3GB、Q8_0が5.0GB、FP16が8.6GBとして配布されています。この記事のGiB表記はAPIが返したbyte数を1024の3乗で割った値なので、公式の10進GB表記より小さく見えます。
なぜQ8はQ4の2倍のファイルではないのか
実測ファイルサイズです。
Q4_K_M  3,338,801,804 bytes = 3.11 GiB
Q8_0    4,979,946,122 bytes = 4.64 GiB
Q8はQ4の1.49倍でした。名前だけを見ると8 bit対4 bitで2倍に思えますが、GGUF全体が一律4 bitまたは8 bitではありません。
- テンソルによって保存形式が異なる
- ブロックごとのスケールなど付加情報がある
- normalizationなど高精度で残るテンソルがある
- 単語分割器、プロンプト template、vision encoderなども含む
したがって「bit数の比=ファイル容量の比」ではありません。比較するときはモデル名から暗算せず、実際のmanifest サイズを読みます。
実験条件
GPU             NVIDIA GeForce RTX 5070 Ti 16GB
Ollama          0.32.15(WSL側)
model           Gemma 3 4B instruction tuned
context         4,096
output limit    256 tokens
temperature     0
seed            42
thinking        false
モデルを取得します。
ollama pull gemma3:4b-it-q4_K_M
ollama pull gemma3:4b-it-q8_0
ollama list
性能測定では同じデータ leakage解説プロンプトを使いました。以下は主要要件で、完全な入力は未加工の JSONに保存しています。
data leakageを説明してください。
訓練・validation・testの役割、典型例、検出方法、予防策を
見出し付きで700字以上にまとめてください。
各種類で次を3 cycle繰り返しました。
keep_alive=0でunload
  → cold generate 256 tokens
  → 同じmodelを残してwarm generate 256 tokens
OllamaのGenerate APIが返すeval_count / eval_durationからtoken/sを計算しました。streamingの最初の本文到着はPythonのwall clockでTTFCとして測定しました。リクエスト中は50msごとにnvidia-smiでGPU全体のメモリをサンプルしています。
Q4は180.6 tok/s、Q8は135.1 tok/s
ウォームアップ後 3回の結果です。
Q4_K_M  180.0 ~ 180.7 tok/s  中央値 180.6
Q8_0    134.7 ~ 135.3 tok/s  中央値 135.1
Q8はQ4より約25.2%遅くなりました。同じ4.3B パラメータでも、8 bit 重みは読み出すデータ量が大きくなります。LLMのトークン生成では各ステップで重みを繰り返し読むため、メモリ bandwidthの影響を受けます。
ただし、この説明は今回のGPUとOllama実装に対する解釈です。GPU 構造、カーネル、バッチ、プロンプト長、オフロード率が変われば比率も変わります。
ウォームアップ後 TTFCはQ4 57.0ms、Q8 54.0msでほぼ同じでした。最初の1 トークン付近の短い処理では、256 トークン全体の復号速度差ほど明確に離れませんでした。
GPU使用量は約1.5GiB増えた
ピークのGPU全体使用量です。
Q4_K_M  4,806 MiB ≒ 4.69 GiB
Q8_0    6,372 MiB ≒ 6.22 GiB
差       1,566 MiB ≒ 1.53 GiB
Q8は約32.6%増です。モデルファイルの増加率49.2%より小さくなりました。nvidia-smiの総使用量には共通のランタイム、KV キャッシュ、desktop側使用分が含まれ、それらすべてが量子化bit数に比例するわけではないためです。
どちらも16GBへ100% GPU オフロードできました。4K コンテキストならQ8でも約9.9GiBの余裕がありますが、長コンテキストではKV キャッシュが増えます。「Q8が6.2GiBだから残りは自由」とは考えません。
再読み込みは両方約2.02秒だった
unload後のAPI load_duration中央値です。
Q4_K_M  2.019 s
Q8_0    2.015 s
Q8 ファイルは1.5GiB大きいのに、3回の中央値はほぼ同じでした。これは完全cold disk readではありません。直前に使ったpageがOS キャッシュへ残り、runner初期化やGPUメモリ allocationも混ざります。
普段のモデル切替待ち時間としては有用ですが、SSDの純粋な読込ベンチマークにはなりません。ダウンロード直後の初回値も除外しています。
品質差を1つの自由記述だけで決めない
同じプロンプト、temperature 0、乱数シード 42でも、Q4とQ8の自由記述は完全一致しませんでした。256 トークン出力の文字列類似度は59.7%です。
Q4とQ8は冒頭の見出しから異なり、Q8は訓練・検証・テストの役割と対策を明示する構成でした。完全な出力は未加工の JSONで比較できます。
量子化誤差でロジットが少し変わると、greedy decodingでも途中で別トークンを選び、その後の文脈が分岐します。しかし文字列が違うことは、Q8の意味品質が高い証拠ではありません。片方だけ正しい事実、構成の完結性、課題達成率などを別に評価する必要があります。
両方ともnum_predict=256へ達し、回答は途中で切れました。700字以上というプロンプト要求より生成上限が優先されています。この自由記述は速度測定用であり、完成度の採点には使いません。
四択は選択肢順を4回変えた
最初は24問を1配置だけで測りました。しかし正解位置がA/Bへ偏り、モデルがAを選びやすいだけでも高得点になります。
そこで各問題の選択肢をcyclicに4回回しました。1問につき正解がA、B、C、Dへ1回ずつ現れます。
for question in questions:
    for rotation in range(4):
        rotated = choices[rotation:] + choices[:rotation]
        answer = ask_model(rotated)
問題は機械学習、algorithm、ネットワーク、OS、データベース、floating pointなど情報科学基礎の24問です。回答はA/B/C/Dの1文字に制約しました。
24 questions × 4 choice orders = 96 responses / quantization
この設計なら、同じ知識を選択肢位置だけ変えて再検査できます。
Q4は79/96、Q8は85/96
Q4_K_M  79 / 96 = 82.3%
Q8_0    85 / 96 = 88.5%
Q4とQ8の回答が異なったのは6配置で、すべてQ8だけが正解でした。差が出たtopicは3問です。
- 学習損失低下・検証損失上昇をoverfittingと判断
- 見逃しを減らすとき再現率を重視
- Bayesの定理で
P(B|A)P(A)を選ぶ
ただし「Q8は6.25ポイント高品質」と一般化してはいけません。96回答は24問を繰り返したpaired データで、独立な96問ではありません。差はわずか3 topicに集中し、問題も筆者作成の小規模試験です。
ここから言えるのは、この具体的試験ではQ8がQ4より6回答多く正解した、という範囲です。標準ベンチマークや実際の研究課題でも再現するかは未確認です。
選択肢順に頑健だったのは16問と17問
同じ問題の4配置すべてで、同じ選択肢テキストを選んだ問題数です。
Q4_K_M  16 / 24 questions
Q8_0    17 / 24 questions
Q8も7問では選択肢の順序により選ぶ内容が変わりました。正解率が高い方でも、プロンプト上の順序に敏感です。
これはLLMでmultiple-choice評価をするときの落とし穴です。1つの選択肢の順序だけでは、知識と選択肢位置への偏りを混同します。少なくとも選択肢を並べ替えまたは回転し、結果が安定するか確認すべきです。
Q8を選ぶべき場合
Q8が合理的なのは次の場合です。
- 実課題の評価setでQ4より一貫して改善した
- 約1.5GiBの追加VRAMを許容できる
- 180.6から135.1 tok/sへの低下が問題にならない
- 他のGPU プロセスや長コンテキストと同居してもメモリに余裕がある
逆に、chat UI、プロンプト開発、簡単な要約、何度も回すagent loopではQ4の速度が大きな利点です。Q4で課題スコアが十分なら、Q8へ上げても待ち時間とメモリだけ増える可能性があります。
自分のPCで再現する
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments
python3 work/ai_lab/experiment_gemma_q4_q8.py
スクリプトはPython標準ライブラリだけを使い、前記事のOllama streaming/GPU monitor helperを読み込みします。
出力です。
work/ai_lab/results/gemma_q4_q8.json
JSONには次を保存します。
- モデルファイルのbyte数と量子化付加情報
- cold/warm各回のAPI timing
- 50ms間隔のGPU memory/utilization サンプル
- 256 トークンの自由記述全文
- 24問×4順序のプロンプト、応答全文、解析結果、正誤
- Q4/Q8 disagreement
- 選択肢の順序に対する質問単位の一貫性
再現時はOllama バージョン、モデル ID、GPU、コンテキスト、temperatureを必ず一緒に記録してください。同じQ4という呼び方でもモデルと量子化方式が違えば結果は変わります。
今回の限界
- 四択は標準ベンチマークではなく筆者作成24問
- 4回転は同じ問題の反復で、96 independent サンプルではない
- Gemma 3 4Bだけを比較し、他系列へ一般化できない
- 日本語プロンプトだけで、英語やコード生成は未評価
- コンテキストは4Kだけ
- QAT、FP16、Q5、Q6は未比較
- 自由記述は256 トークンで打ち切り
Q8で変わった質問を見る
Q8で増えた正解は6回答でしたが、差は3つの話題に集中していました。選択肢を並べ替えても正解する問題数は、Q4の16問に対してQ8が17問です。今回の24問だけでは、回答全般が大きく改善したとは判断しにくい結果でした。
約1.5 GiBの追加VRAMと25%の速度低下を受け入れるかは、使いたい質問での違いを見て決めるのがよさそうです。
