GPU: NVIDIA GeForce RTX 5070 Ti 16GB / WSL2 Ubuntu / Ollama 0.32.15
RTX 5070 Tiの16 GBで、Gemma 3 4B、Qwen 3 8B、Gemma 3 12Bを動かしました。Q4_K_M、コンテキスト4,096トークンの条件では、3つとも全層をGPUへ載せられました。
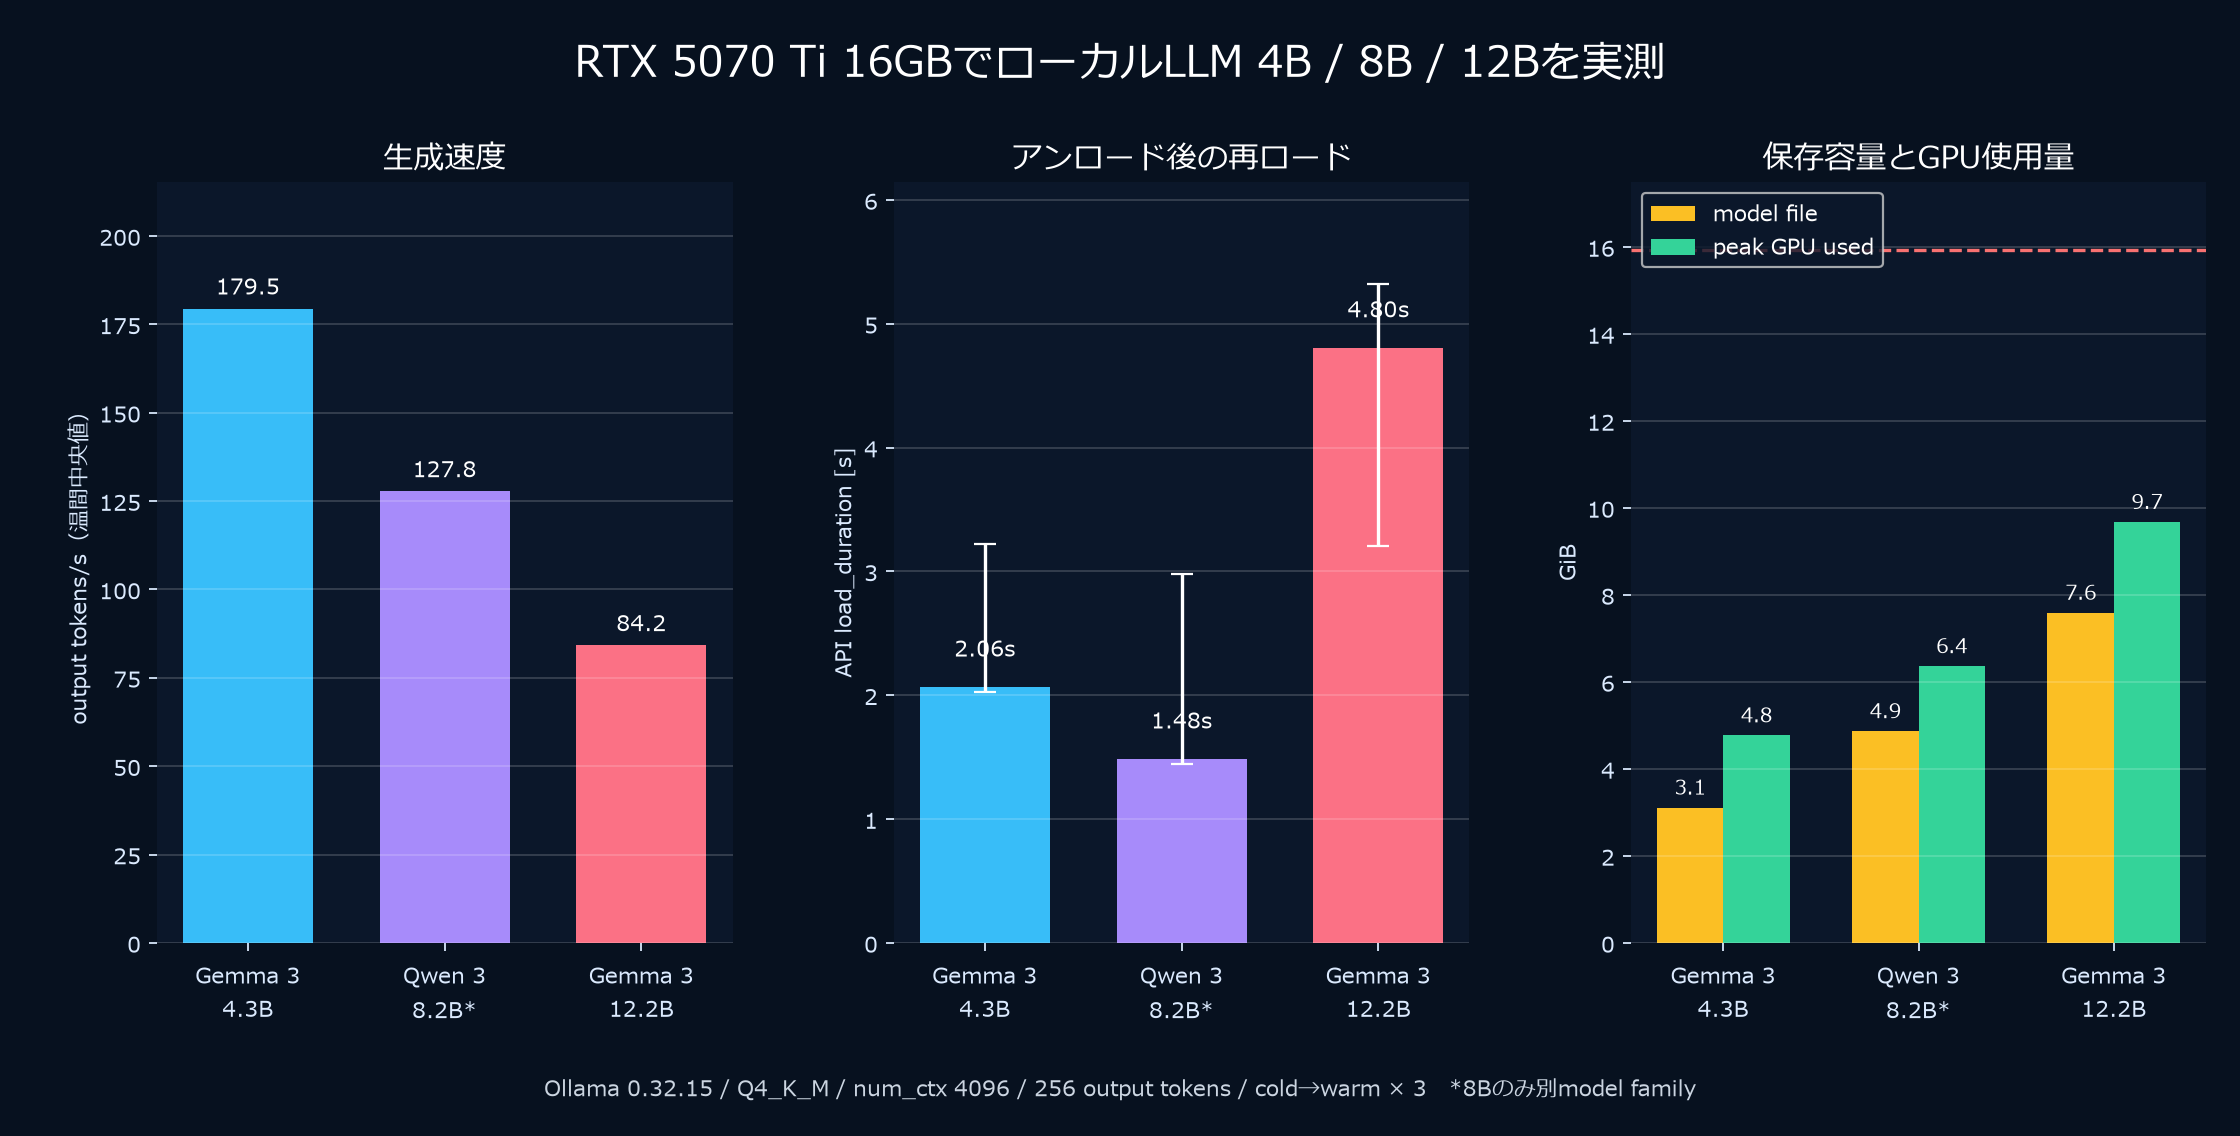
12BのGPU使用量はピーク約9.7 GiB、読み込み後の生成速度は84.2 tok/sでした。4B・8Bも同じ条件で測り、モデルを読み込む待ち時間と、読み込んだ後の速さを比べます。
4B・8B・12Bを載せた結果
速度と待ち時間
| モデル | 再読み込み | ウォームアップ後 TTFC | ウォームアップ後生成速度 |
|---|---|---|---|
| Gemma 3 4B | 2.06秒 | 65.7ms | 179.5 tok/s |
| Qwen 3 8B | 1.48秒 | 44.7ms | 127.8 tok/s |
| Gemma 3 12B | 4.80秒 | 126.2ms | 84.2 tok/s |
規模とメモリ
| モデル | 実パラメータ | モデルファイル | ピーク GPU used |
|---|---|---|---|
| Gemma 3 4B | 4.3B | 3.1GiB | 4.8GiB |
| Qwen 3 8B | 8.2B | 4.9GiB | 6.4GiB |
| Gemma 3 12B | 12.2B | 7.6GiB | 9.7GiB |
このPCでの実用上の選び方です。
- 応答速度と余裕を優先するなら4B
- 速度と規模の中間を試すなら8B
- 16GB内でより大きいモデルを全GPU オフロードしたいなら12B
- 長いコンテキストを使う場合は、この表だけで判断せずKV キャッシュ込みで再測定する
重要な注意があります。4Bと12BはGemma 3ですが、8BだけQwen 3です。したがって8Bの差にはパラメータ数だけでなく、構造、単語分割器、学習データなどの違いが混ざります。「8Bだからこの速度」と一般化できる比較ではありません。
「4B」「8B」は何を表すのか
Bはbillion、10億です。4B モデルならパラメータがおよそ40億あります。パラメータは学習で得た重みで、入力トークンから次のトークンの確率を計算するために使われます。
ただしモデル名の丸めと実値は一致しません。Ollamaの/api/showで今回のGGUF 付加情報を読むと、実値は次の通りでした。
gemma3:4b   4.3B parameters
qwen3:8b    8.2B parameters
gemma3:12b 12.2B parameters
パラメータ数が増えると一般には表現力が増える可能性がありますが、品質はパラメータ数だけでは決まりません。学習データ、学習方法、構造、量子化、プロンプトとの相性も効きます。
Ollama公式ライブラリではGemma 3に4B・12Bなど、Qwen 3に8Bなどの種類が用意されています。公式ページ上の配布容量はGemma 3 4Bが3.3GB、Qwen 3 8Bが5.2GB、Gemma 3 12Bが8.1GBです。
なぜ12Bが約7.6GiBのファイルになるのか
12.2B個のパラメータをFP32、つまり1個4 byteで保存すると、概算は約45.4GiBです。
12.2 × 10^9 parameters × 4 bytes ≒ 48.8 GB ≒ 45.4 GiB
しかし今回の12B モデルファイルは約7.6GiBです。理由はQ4_K_M量子化です。重みを平均4 bit程度の低いbit幅へ圧縮し、ブロックごとのスケールなどを追加して保存します。
実際の付加情報は全モデルで次の値でした。
format: gguf
quantization_level: Q4_K_M
「4 bitだからFP32の厳密に8分の1」とはなりません。スケール、付加情報、一部の高精度テンソルなどの追加コストがあるためです。また、これは主に重みの話です。実行時VRAMはモデルファイルより大きくなります。
実行時VRAMはモデルファイルより大きい
今回のモデルファイルとピークGPU使用量です。
                 model file   peak GPU used   差
Gemma 3 4B          3.1 GiB        4.8 GiB    +1.7 GiB
Qwen 3 8B           4.9 GiB        6.4 GiB    +1.5 GiB
Gemma 3 12B         7.6 GiB        9.7 GiB    +2.1 GiB
実行時には少なくとも重みに加えて次が必要です。
- 入出力テンソルと各層の作業バッファ
- attentionのKV キャッシュ
- Ollama/CUDA ランタイムが確保する領域
- desktop表示など、別プロセスが使うGPUメモリ
ここで測ったpeak GPU usedはnvidia-smiが返すGPU全体の使用量です。Ollama プロセスだけの割当量ではありません。一方、Ollamaの/api/psでは全モデルが100% GPUへ載ったことを確認しました。
12Bのピークは9,909MiBで、GPU総量16,303MiBに対して約6.2GiB残りました。ただし「残りで128K コンテキストも必ず動く」という意味ではありません。KV キャッシュはコンテキスト長、層数、head構成、キャッシュ量子化によって増えます。この記事では比較を揃えるためnum_ctx=4096に固定しています。
実験環境
OS             Windows 11 + WSL2 Ubuntu
GPU            NVIDIA GeForce RTX 5070 Ti
VRAM           16,303 MiB
driver         595.71
Ollama         0.32.15(WSL側)
model format   GGUF
quantization   Q4_K_M
モデルはWSLで取得しました。
ollama pull gemma3:4b
ollama pull qwen3:8b
ollama pull gemma3:12b
ollama list
取得後のollama listです。
NAME          SIZE
gemma3:4b     3.3 GB
qwen3:8b      5.2 GB
gemma3:12b    8.1 GB
条件を固定する
速度比較に使ったプロンプトの主要要件です。完全な入力は未加工の JSONに保存しています。
勾配降下法で学習率が大きすぎると学習が不安定になる理由を説明してください。
損失曲面、更新式、発散の兆候、
切り分け手順、改善策の5項目を見出し付きで扱い、具体例を含めて700字以上で書いてください。
API optionを揃えました。
payload = {
    "model": model,
    "prompt": prompt,
    "stream": True,
    "think": False,
    "keep_alive": "10m",
    "options": {
        "temperature": 0,
        "seed": 42,
        "num_ctx": 4096,
        "num_predict": 256,
    },
}
temperature=0と固定乱数シードでsamplingの揺れを抑えました。Qwen 3のthinking トークンが速度へ混ざらないようthink=falseです。全モデルがnum_predict=256へ達したので、出力トークン数も揃っています。
Ollama Generate APIはstreaming 応答の最後にload_duration、prompt_eval_count、prompt_eval_duration、eval_count、eval_durationをnanosecond単位で返します。生成速度は次で計算しました。
tokens_per_second = eval_count / (eval_duration / 10^9)
coldとウォームアップ後を分ける
モデルがGPUに残っているかで待ち時間が変わります。
cold: keep_alive=0でunload → 次のgenerateで再ロード
warm: 直前と同じmodelをGPUへ残したままgenerate
各モデルでcold→ウォームアップ後を3 cycle行いました。ストリームで最初の本文が届くまでをTTFC(time to first content)としてwall clockでも測っています。同時に50ms間隔でnvidia-smiを呼び、GPUメモリと使用率を記録しました。
ここでいうcoldは「OSを再起動し、disk キャッシュも空にした完全cold」ではありません。モデルをOllamaからunloadした再ロードです。普段モデルを切り替えたときの待ち時間に近い指標です。
温間では4Bが179.5 tok/s、12Bが84.2 tok/s
温間生成速度の3回の範囲です。
Gemma 3 4B   179.2 ~ 180.2 tok/s  中央値 179.5
Qwen 3 8B    127.3 ~ 127.9 tok/s  中央値 127.8
Gemma 3 12B   83.4 ~  84.5 tok/s  中央値  84.2
12Bは4Bの約46.9%の速度です。それでも84 tok/sなら、対話用途では人の読書速度より十分速く出力が流れます。短いコード補完を繰り返す用途では4Bの低待ち時間が効き、長めの回答を待てる用途では12Bも現実的です。
ウォームアップ後 TTFCは4B 65.7ms、8B 44.7ms、12B 126.2msでした。この値はストリーム上の最初の本文チャンクであり、ネットワーク越しのcloud APIにおけるTTFTと完全に同じ定義ではありません。
再ロード時間はモデルサイズと単純比例しなかった
再読み込みのload_duration中央値です。
Gemma 3 4B   2.06 s  (2.03 ~ 3.22)
Qwen 3 8B    1.48 s  (1.45 ~ 2.98)
Gemma 3 12B  4.80 s  (3.21 ~ 5.32)
8Bのreloadは4Bより速く、モデルファイルサイズだけでは順序を説明できません。OS page キャッシュ、メモリ allocation、runnerの準備、モデル系列の違いが混ざります。測定は各3回でばらつきもあり、reload時間からモデルの能力差は判断できません。
さらに、Qwen 3 8Bをダウンロード直後に初めて実行した1回だけはTTFC 17.54秒、API上の読み込み 12.01秒でした。その後のreloadではTTFC中央値1.58秒です。初回固有の準備コストを、毎回発生する待ち時間と混同しないため、正式表から分離しました。
実際にQwen 3 8Bをストリーム生成した
ベンチマークスクリプトだけでなく、同じOllama APIへ接続するローカル画面を作り、browserでストリーム出力を確認しました。外部APIには送っていません。
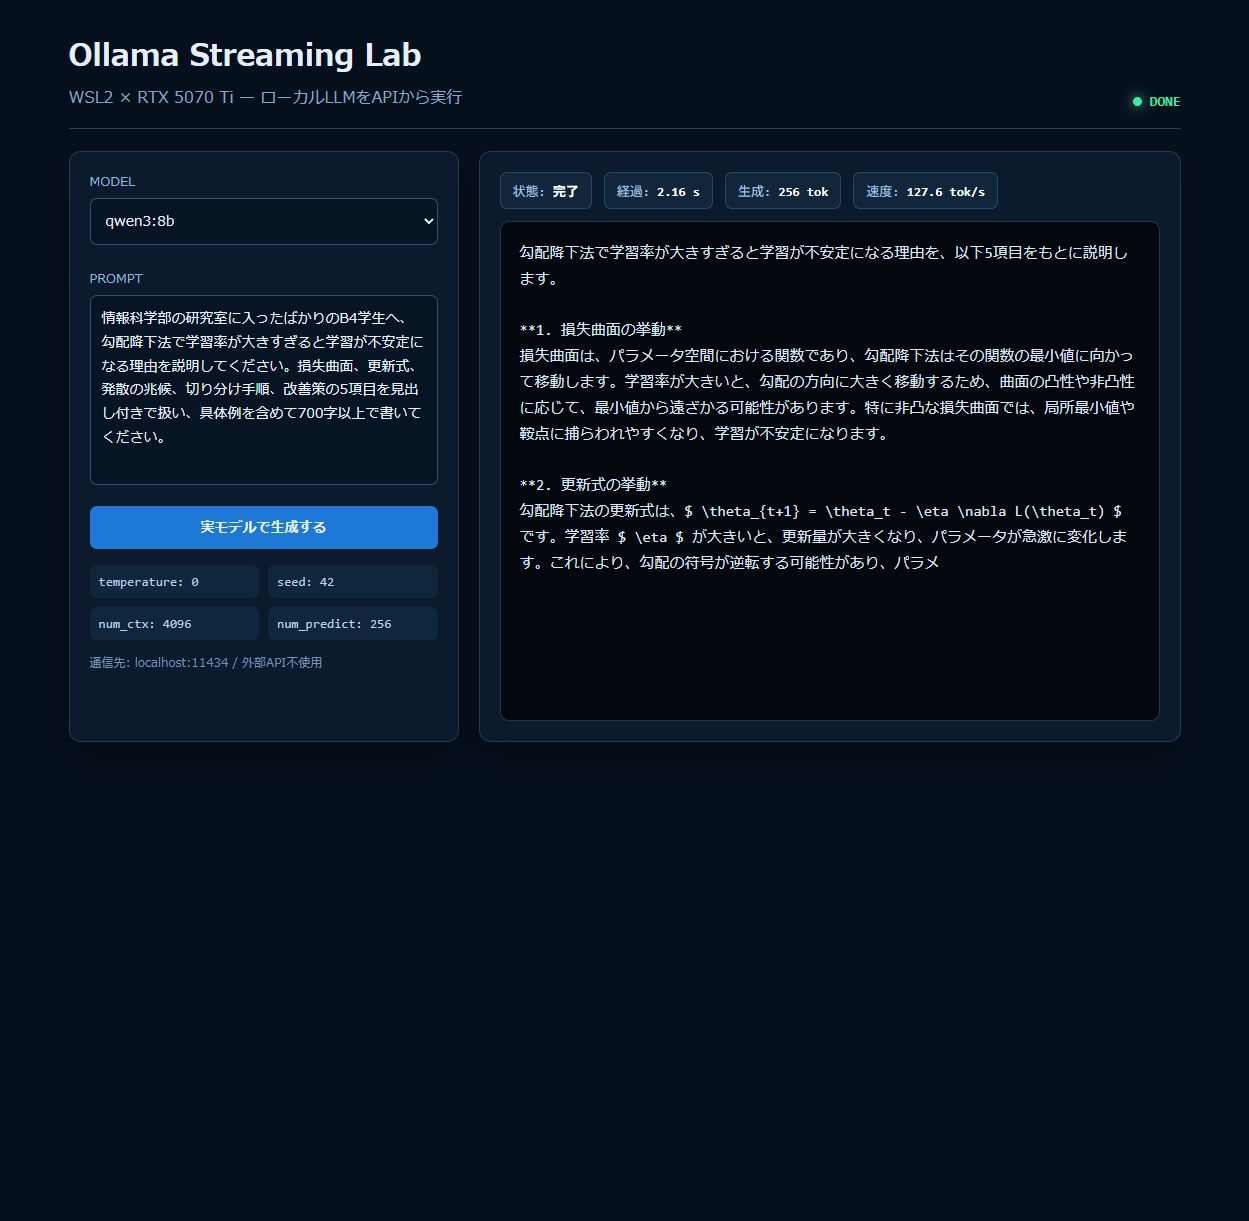
この実行では256 トークンを2.16秒、127.6 tok/sで生成しました。画面の文字は保存済みテキストを貼ったものではなく、stream=trueで到着したresponse fragmentを順番にDOMへ追加したものです。
出力を人間が読むと問題も見える
速度だけなら成功ですが、回答品質を読むと少なくとも2つ注意点があります。
1つ目は、3モデルすべてが256 トークンで回答途中に切れたことです。プロンプトでは700字以上を要求しましたが、num_predict=256という生成上限が優先されました。長い回答が必要なら上限を増やす必要があります。その代わり待ち時間とKV キャッシュ使用量も増えます。
2つ目は、もっともらしい説明にも検証が必要なことです。今回の4B出力には「平坦な領域は損失が小さい」と読める説明がありましたが、平坦さは勾配の小ささであって、損失値の低さを保証しません。8B出力の「大きい学習率だと局所最小値や鞍点に捕らわれやすい」という説明も、発散の中心理由としては不正確です。
1次元二次関数なら、overshootを式で確認できます。
L(w) = 1/2 × a × w²
gradient = a × w

w_(t+1) = w_t - ηa w_t
          = (1 - ηa) w_t
収束には概ね|1 - ηa| < 1、つまり0 < ηa < 2が必要です。ηa > 2では絶対値が1を超え、符号を反転しながら原点から離れます。「ステップが大きすぎて谷を飛び越え、振幅が増える」が核心です。
LLMの規模を選ぶときはtok/sだけでなく、別に正答率・引用・コードテストなどの課題評価が必要です。この記事の1 プロンプトは品質ベンチマークではありません。
自分のPCで再現する
実験スクリプトはPython標準ライブラリだけで動きます。
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments
python3 work/ai_lab/experiment_ollama_model_sizes.py
主な処理です。
for model in ["gemma3:4b", "qwen3:8b", "gemma3:12b"]:
    for repeat in range(1, 4):
        unload(model)                    # keep_alive=0
        run_streamed(model, "cold")
        run_streamed(model, "warm")
結果はJSONへ保存します。
work/ai_lab/results/ollama_model_sizes.json
最低限確認するfieldです。
load_duration_s: モデル読み込みtime_to_first_content_s: ストリーム先頭本文までeval_count: 出力トークン数eval_duration_s: トークン生成時間tokens_per_s: 出力速度gpu_peak_used_mib: リクエスト中の総GPU使用量ピークresponse: 実際の出力全文
12Bまで載ったが、回答の質は別に比べる
この条件なら12Bも16 GBに収まり、読み込み後は84.2 tok/sで生成できました。4Bはさらに速く、GPUメモリにも余裕があります。
ただし、この速度測定では出力を256トークンで切っており、回答はすべて途中で終わっています。正答率を比べた結果ではありません。また8BだけQwen 3なので、モデルの大きさだけの効果とも言えません。
回答の違いはTruthfulQAでの比較、長い入力を渡した場合は4K・8K・16Kの測定に載せています。複数人からの同時利用や、27BをCPUと分担させる構成は試していません。
