環境: RTX 5070 Ti 16GB / WSL2 / PyTorch 2.13.0+cu130 / Diffusers 0.40.0
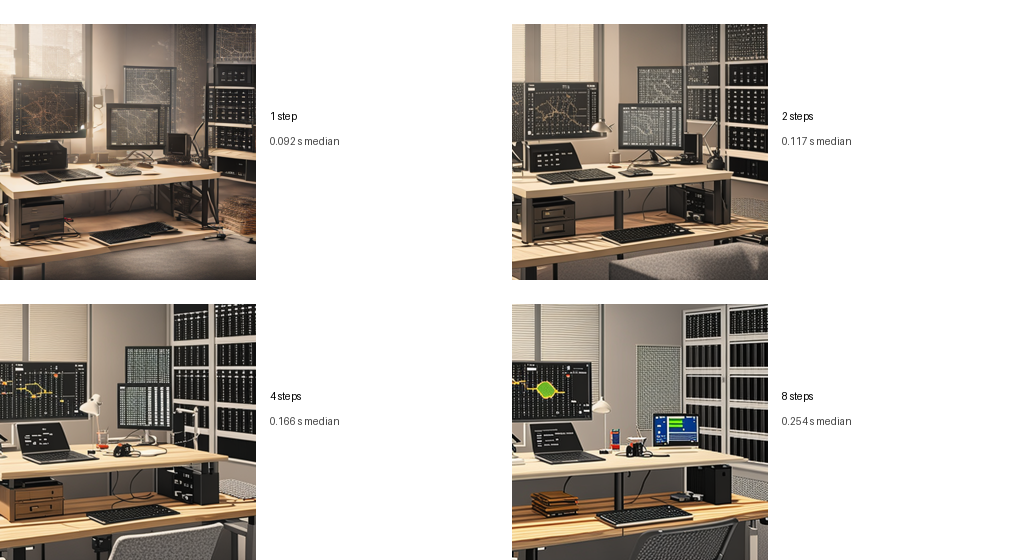
SD-TurboをRTX 5070 Tiで動かしました。512×512画像の生成は、読み込みとウォームアップを済ませた状態で約0.09〜0.25秒でした。
同じプロンプトと乱数シードで、ノイズを取り除く処理の回数を1・2・4・8へ変えています。回数を増やすと時間は延びますが、出てきた画像が順番によくなるわけではありませんでした。生成画像を並べて確認します。
1・2・4・8ステップの結果
| ステップ | 中央値 | 5回範囲 | ピーク allocated |
|---|---|---|---|
| 1 | 0.092秒 | 0.088~0.096秒 | 3,120.5 MiB |
| 2 | 0.117秒 | 0.112~0.117秒 | 3,120.5 MiB |
| 4 | 0.166秒 | 0.155~0.188秒 | 3,120.5 MiB |
| 8 | 0.254秒 | 0.249~0.257秒 | 3,120.5 MiB |
4ステップの生成結果です。
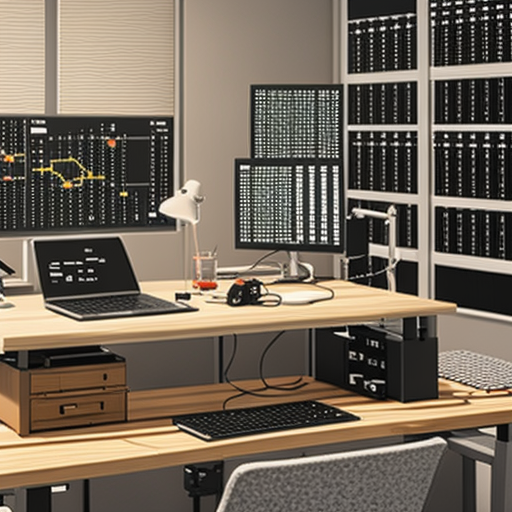
画像を目視すると、ステップを増やすほど単調に品質が上がるとは言えません。SD-Turboは少ステップ向けにdistillされたモデルで、8ステップは「高品質設定」と同義ではありません。
実際にダウンロードしたもの
Python パッケージをWSL venvへ入れました。
source /opt/ai-lab/venv/bin/activate
pip install diffusers transformers accelerate safetensors sentencepiece
実行バージョンです。
diffusers     0.40.0
transformers  5.15.1
accelerate    1.14.0
safetensors   0.8.0
torch         2.13.0+cu130
モデルはDiffusersがstabilityai/sd-turboから取得し、Hugging Face キャッシュへ保存しました。初回は12 ファイルの取得に約31秒、処理の流れ読み込みを含むスクリプト上の読み込み時間は33.9秒でした。
2回目はキャッシュから読み、読み込み時間2.63秒です。画像1枚の0.1~0.3秒だけを見ても、初回ダウンロードとモデル読み込みを含むuser experienceは説明できません。
処理の流れをGPUへ載せる
pipe = AutoPipelineForText2Image.from_pretrained(
    "stabilityai/sd-turbo",
    torch_dtype=torch.float16,
    variant="fp16",
)
pipe = pipe.to("cuda")
FP16を使うとFP32より重みメモリを減らせます。今回のtorch_dtype引数には将来dtypeへ変更するdeprecation 警告が出ました。警告を記録し、バージョンを固定しています。
DiffusersのAutoPipelineはモデル configから適切なtext-to-image 処理の流れを選びます。この実行ではStableDiffusionPipelineが構成されました。
プロンプトを固定する
全条件で同じ英語プロンプトを使いました。
A small university AI laboratory desk,
a black GPU workstation beside notebooks with neural network diagrams,
warm morning light, realistic editorial photograph,
no text, no logo
比較中にプロンプトを変えると、ステップ差とプロンプト差を分離できません。negative プロンプトは使っていません。
no text, no logoと書いても完全な保証にはなりません。実際の比較画像にはmonitor上に文字のような模様があります。生成モデルは指示を論理constraintとして実行するわけではありません。
guidance スケールを0にする
生成callです。
image = pipe(
    prompt,
    num_inference_steps=4,
    guidance_scale=0.0,
    height=512,
    width=512,
    generator=generator,
).images[0]
SD-Turboのモデル cardは1~4ステップの高速生成とguidance_scale=0.0を例示しています。普通のStable Diffusionでよく見る7.5をそのまま使わず、モデル固有の推奨条件へ合わせました。
モデル系列が違えば適切なスケジューラ、ステップ、guidanceも変わります。「Stable Diffusionの設定」を一括りにできません。
乱数シードはCUDA Generatorへ渡す
generator = torch.Generator(device="cuda").manual_seed(42)
diffusion モデルはrandom noiseから生成を始めます。乱数シードを固定すると初期noiseを固定でき、ステップ数だけを変える比較がしやすくなります。
global torch.manual_seedだけに頼らず、生成call専用Generatorを作りました。各測定replicateでも乱数シード 42から作り直しています。
ウォームアップを測定から外す
最初の動作確認回では1ステップが0.790秒、2ステップが0.127秒でした。1ステップの方が大幅に遅いのは不自然です。
原因は最初のcallにCUDA initializationやカーネル setupが含まれたためです。そこで乱数シード 999で1回ウォームアップし、その後各ステップを5回測り直しました。
pipe(prompt, num_inference_steps=1, generator=warmup_generator)

for _ in range(5):
    torch.cuda.synchronize()
    started = time.perf_counter()
    image = pipe(...)
    torch.cuda.synchronize()
    samples.append(time.perf_counter() - started)
この修正で1ステップ中央値は0.092秒になりました。GPU ベンチマークではウォームアップとsynchronize()が不可欠です。CUDA operationは非同期なので、同期せずCPU clockだけ測ると処理完了前にtimerが止まります。
ステップ数と時間はほぼ増える
1 step  0.092 s
2 steps 0.117 s
4 steps 0.166 s
8 steps 0.254 s
1→8ステップでUNet 評価回数は8倍ですが、処理全体時間は2.76倍でした。テキスト encoding、VAE 復号、Python callなどステップ数に依存しない固定コストがあるためです。
画像/秒へ単純換算すると次です。
1 step  約10.84 images/s
2 steps  約 8.56 images/s
4 steps  約 6.04 images/s
8 steps  約 3.93 images/s
これはバッチ 1、512×512、同じ処理の流れを読み込み済みの処理速度です。モデル読み込み、PNG保存、web deliveryは含みません。
ピークメモリがステップ数で変わらなかった理由
全条件のtorch.cuda.max_memory_allocated()は約3,120.5 MiBでした。
denoising ステップを増やしても、同じ配列の形のlatentとモデル重みを順番に再利用します。計算回数は増えても、同時に保持するテンソルの最大構成が同じならピークは増えません。
一方、resolutionやバッチを増やすと中間出力テンソルが大きくなり、ピークメモリは増えます。ステップ数は主にtime、resolutionとバッチはtimeとメモリの両方へ効く、という違いです。
この3,120 MiBはPyTorch allocatorのallocated ピークです。ドライバコンテキストや他プロセスを含むnvidia-smi値とは一致しません。
1・2・4・8ステップを目視比較する
全画像は同じ乱数シード 42ですが、スケジューラ trajectoryがステップ数で変わるため別画素になります。
1ステップでもdesk、monitor、rackらしい構図は出ています。2~4ステップではobjectの輪郭や配置が変わり、8ステップでは色の強いmonitorや本が増えました。
ただし「8ステップが最高」と客観評価していません。プロンプト adherence、美観、生成ファイルは人によって判断が変わります。1 プロンプト×1 乱数シードだけではquality ベンチマークになりません。
定量化するなら次が必要です。
- 複数プロンプトカテゴリ
- 各プロンプト複数乱数シード
- human preference blind テスト
- CLIPなどのtext-image 配置の整列
- 生成ファイルや文字崩れのannotation
- 生成失敗率
この記事の画像は、実行条件差を人間が確認するqualitative 根拠です。
同じ乱数シードは画素単位で一致した
4ステップ、乱数シード 42を同じプロセスで再実行しました。PIL imageの画素 byte列へSHA-256を計算します。
hashlib.sha256(image.tobytes()).hexdigest()
2回とも次のhashでした。
deb671cd10d3abd2a64944305de5011efbec9ba74efefd161c2eb704f2f62d9e
画素単位で完全一致です。PNG ファイルサイズも両方409,308 bytesでした。
乱数シード 43は別hashになりました。
30959d7387faa9fcc42bb055a8f59702a0bac98b742983c17a2769078f3ca058
ただしPyTorch、Diffusers、CUDA、スケジューラ、GPU 構造を変えると、同じ乱数シードでも同一画素にならない可能性があります。乱数シードは実験条件の一部であり、普遍的な画像IDではありません。
safety checker 警告をどう扱ったか
処理の流れ読み込み時、safety checkerが無効であるという警告が出ました。公開serviceでunfiltered resultをそのまま配信しないようDiffusersが注意しています。
今回は自分のoffline experimentで、プロンプトは研究室の机です。生成6枚を保存後に目視確認し、公開する比較gridと4-step画像に不適切内容や実在人物の描写がないことを確認しました。
不特定userのプロンプトを受けるserviceなら、content policy、input/output フィルタ、rate limit、audit ログ、人間確認、モデルライセンス確認が必要です。
ダウンロード元とライセンスを記録する
ローカルで動くことと、自由に再配布できることは同じではありません。モデル cardとライセンスを確認し、モデル IDを結果JSONへ保存しました。
{
  "model": "stabilityai/sd-turbo",
  "dtype": "float16",
  "resolution": [512, 512],
  "guidance_scale": 0.0
}
研究成果へ画像を使う場合は、モデルライセンスだけでなくデータセット由来のrisk、生成物の扱い、所属機関のruleも確認します。
再現手順
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
source /opt/ai-lab/venv/bin/activate

cd ~/ai-experiments/work/ai_lab
python -u experiment_local_image_generation.py
生成されるファイルは次のとおりです。
work/ai_lab/experiment_local_image_generation.py
work/ai_lab/results/local_image_generation.json
work/ai_lab/generated_images/sd_turbo_steps1_seed42.png
work/ai_lab/generated_images/sd_turbo_steps2_seed42.png
work/ai_lab/generated_images/sd_turbo_steps4_seed42.png
work/ai_lab/generated_images/sd_turbo_steps8_seed42.png
work/ai_lab/generated_images/sd_turbo_steps4_seed42_repeat.png
work/ai_lab/generated_images/sd_turbo_steps4_seed43_different_seed.png
work/figures/sd-turbo-local-steps.png
JSONには読み込み時間、プロンプト、バージョン、GPU、各5回の未加工の秒、中央値、ピーク allocated、画素 hash、PNG サイズを保存しています。
生成は速いが、最初の1枚は待つ
読み込み後の生成は短時間でしたが、初回ダウンロードには31秒、キャッシュ済みでもモデルの読み込みに2.63秒かかりました。少数の画像だけを作るなら、こちらの待ち時間も効きます。
同じ環境・乱数シードでは画素単位の一致を確認できました。ステップ数を増やした画像は、細部が変わる一方で一様によくなるわけではありません。使う画像を見ながら回数を選べる速さではありました。