PyTorch 2.13.0+cu130
CPU: Core i7-14700F(28 論理CPU)/ GPU: RTX 5070 Ti / WSL2
FashionMNISTのCNNは、DataLoaderの設定だけでも学習時間がかなり変わりました。画像を切り抜いたり回転させたりする処理をCPUに加えると、num_workers=0では約8,830 images/s、12〜16プロセスでは反復測定の中央値が約62,100〜63,800 images/sです。
ただし、増やせば増やすほど速くなるわけではありません。最初のエポックにはプロセスの起動時間もかかります。画像変換の軽い場合と重い場合を分け、0〜16まで試しました。
ワーカー数の結論
軽い前処理(ToTensorのみ)
- 0ワーカー:30,268 images/s
- 2ワーカー:60,881 images/s
- 4ワーカー:108,782 images/s
- 8ワーカー:116,828 images/s
- 12ワーカー:119,045 images/s
- 16ワーカー:117,262 images/s
- この一通りの測定では12付近で頭打ち
CPU 画像拡張あり
- 0ワーカー:8,830 images/s
- 2ワーカー:20,626 images/s
- 4ワーカー:41,292 images/s
- 8 / 12 / 16ワーカーは追加で各5回測定
- 反復中央値:8は55,196、12は62,103、16は63,753 images/s
- 12→16の差は約2.7%。12~16を頭打ち領域と判断
pin_memory、画像拡張、4ワーカー、各5回
- OFF:中央値1.634秒(1.611~1.649秒)
- ON:中央値1.635秒(1.599~1.669秒)
- 範囲が大きく重なり、処理全体差なし
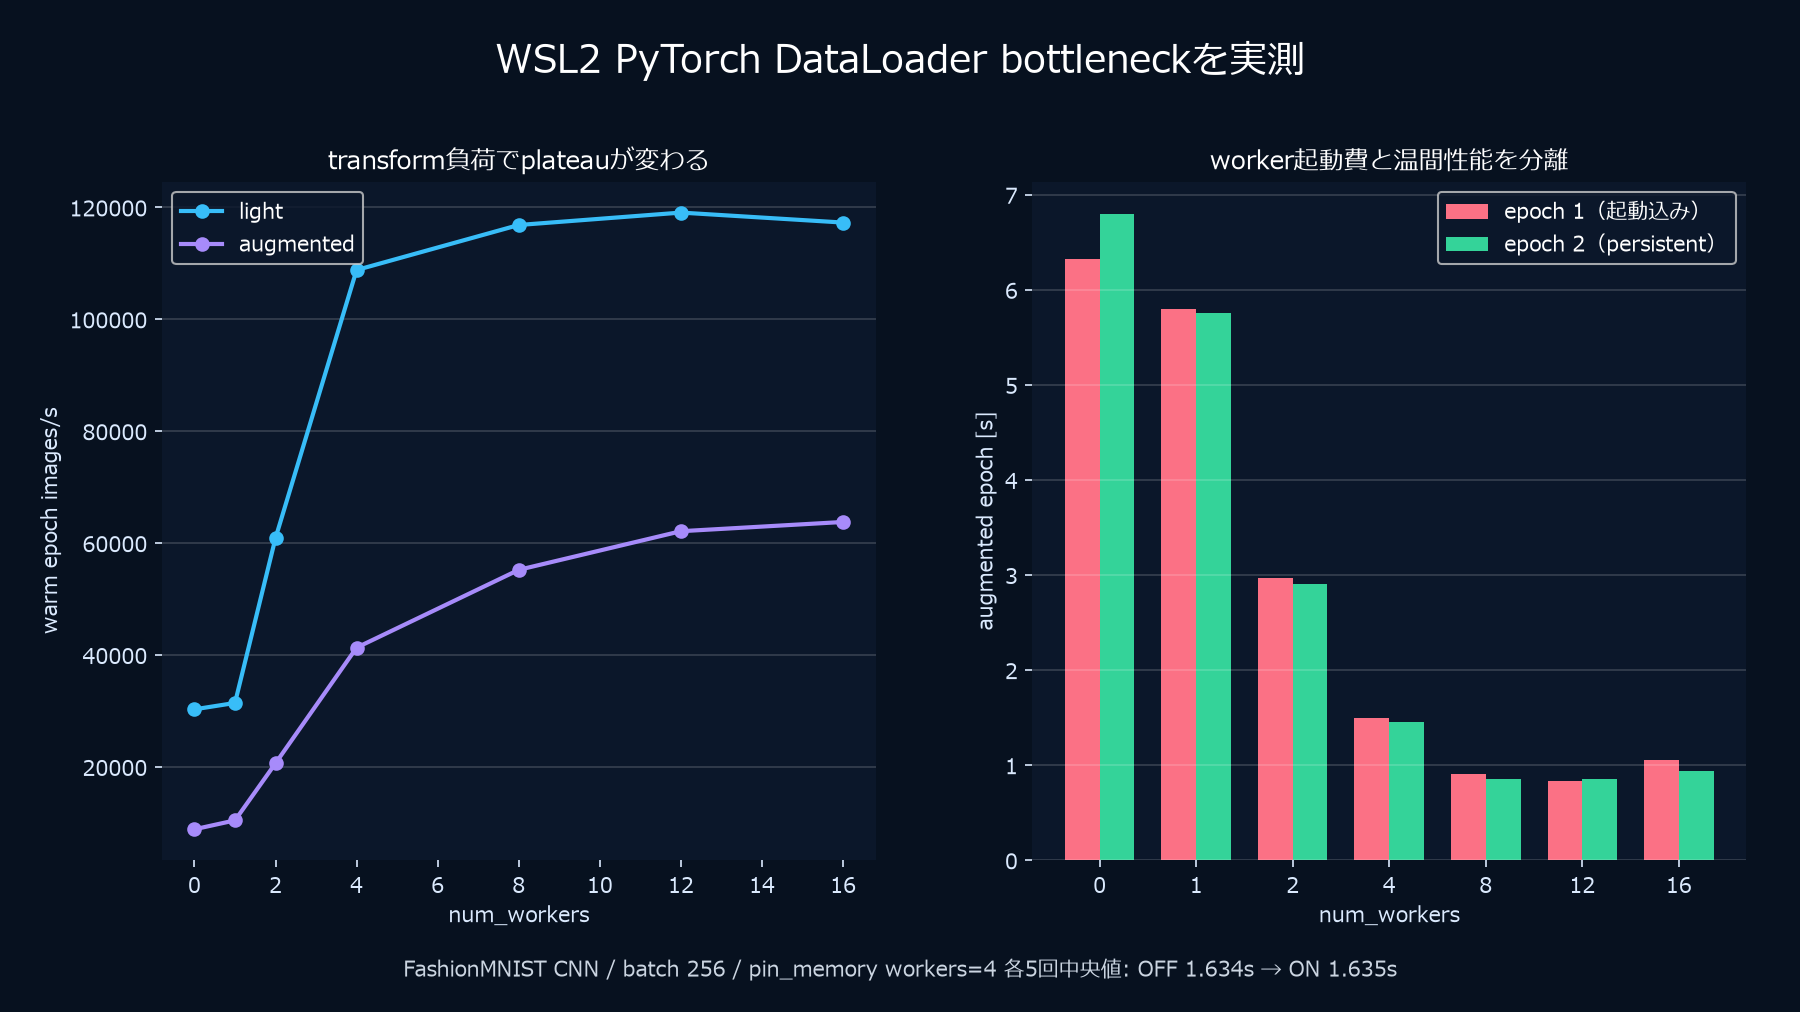
図の左側は温間エポックです。画像拡張の8/12/16だけは各5回の中央値、その他は全条件一通りの測定の値です。右側は同じ一通りの測定で、最初のエポックとpersistent ワーカーを使った2回目を比較しています。
DataLoaderは何を並列化するのか
Dataset.__getitem__()は、インデックスを受け取って1サンプルを返します。画像ファイルの読み込み、復号、切り抜き、回転、Tensor化などは通常ここで実行されます。
num_workers=0では、main プロセスが学習loopとデータ準備の両方を順番に行います。
main: [load/transform] → [GPU training] → [load/transform] → [GPU training]
num_workers>0では、子プロセスが次のバッチを準備し、main プロセスがGPU計算を進めます。
worker 0: [prepare batch A] ───── [prepare batch C]
worker 1: [prepare batch B] ───── [prepare batch D]
main/GPU:        [train A][train B][train C][train D]
理想的にはデータ準備とGPU計算が重なります。ただしプロセス作成、プロセス間通信(IPC)、キュー、メモリコピーにもコストがあります。ワーカーを増やせば常に速いわけではありません。
PyTorch公式のPerformance Tuning Guideも、num_workers>0でasynchronous loadingと画像拡張を重ねられる一方、処理内容、CPU、GPU、データ保存場所に応じて調整すべきだと説明しています。
2種類の処理内容を用意した理由
ワーカー数の効果はDatasetが行う仕事で変わります。
軽い条件です。
transform = transforms.ToTensor()
画像拡張条件です。
transform = transforms.Compose([
    transforms.RandomResizedCrop(28, scale=(0.75, 1.0)),
    transforms.RandomRotation(15),
    transforms.ToTensor(),
])
FashionMNISTは小さい28×28画像で、ファイルもローカル SSD上にあります。それでも回転と切り抜きを60,000枚へ毎エポック適用するとCPU側の比率が増えます。
「DataLoaderは4ワーカーが最適」と一般化するのではなく、自分の復号・前処理・ストレージを含む処理の流れを測る必要があります。
実験条件
- FashionMNIST学習画像60,000枚
- CNN 105,866パラメータ
- バッチ 256、Adam、FP32、TF32無効
num_workers:0 / 1 / 2 / 4 / 8 / 12 / 16prefetch_factor=2(ワーカーありの場合)persistent_workers=True(ワーカーありの場合)pin_memory=Trueを基本条件- 同一loaderで2エポック
- エポック 1:ワーカープロセス起動とinitial prefetchを含む
- エポック 2:ワーカーを維持した温間
- DataLoader、host→デバイス転送、順伝播、逆伝播、Adamをすべて計測
- GPU/libraryは事前に合成1ステップでウォームアップ
- CUDA計測の前後で
synchronize()
loader = DataLoader(
    dataset,
    batch_size=256,
    shuffle=True,
    num_workers=workers,
    pin_memory=True,
    persistent_workers=workers > 0,
    prefetch_factor=2 if workers > 0 else None,
)
persistent_workersとprefetch_factorはワーカー=0では使えません。実装時は条件分岐が必要です。
軽い前処理でも4ワーカーまで大きく伸びた
ToTensorだけの温間処理速度は、0ワーカーの30,268から4ワーカーの108,782 images/sへ約3.59倍になりました。
FashionMNISTは小さくても、Pythonでサンプルを1件ずつ取り出し、PIL imageをTensorへ変換し、バッチへcollateする処理があります。小型CNNのGPU計算が速いため、CPU側のわずかな仕事が相対的にボトルネックになりました。
8ワーカーは116,828、12は119,045、16は117,262 images/sです。4→12の増加は約9.4%ですが、12→16では少し低下しました。
したがって軽い条件では4が処理量と負荷の釣り合いのよい候補、最高処理速度を狙うなら8~12付近です。16 プロセスを常時維持する利益はありませんでした。
画像拡張ありでは並列化の効果がさらに大きい
画像拡張条件の一通りの測定です。
| ワーカー | エポック 1秒 | ウォームアップ後秒 | ウォームアップ後 images/s |
|---|---|---|---|
| 0 | 6.327 | 6.795 | 8,830 |
| 1 | 5.792 | 5.757 | 10,422 |
| 2 | 2.967 | 2.909 | 20,626 |
| 4 | 1.493 | 1.453 | 41,292 |
| 8 | 0.903 | 0.852 | 70,398 |
| 12 | 0.830 | 0.853 | 70,322 |
| 16 | 1.055 | 0.937 | 64,050 |
単発一通りの測定では8と12がほぼ同じで、16は低下しました。しかしエポックが1秒未満になるとOS スケジューラやプロセス状態の揺らぎが順位へ影響します。別の一通りの測定では12が最高になりました。
そこで8、12、16だけを順序ローテーションして各5回追加測定しました。
- 8ワーカー:55,196 images/s(54,306~55,660)
- 12ワーカー:62,103 images/s(61,716~62,660)
- 16ワーカー:63,753 images/s(62,614~63,974)
絶対値は一通りの測定と追加反復で変わりましたが、0~4から大きく改善し、12~16で伸びが小さくなる傾向は共通です。16は12より約2.7%速いだけなので、このPCでは12付近を実用的な頭打ち開始点と判断しました。
なぜワーカー=1の最初だけ遅いのか
軽い条件のワーカー=1は、エポック 1が3.371秒、温間エポックが1.910秒でした。0ワーカーの約1.97秒より初回だけ大幅に遅くなっています。
1ワーカーではデータ準備をmain プロセスから分離できますが、並列度は増えず、最初に次のコストを払います。
- 子プロセス作成
- Python モジュールとDataset状態の準備
- キューとshared-memory経路の準備
- 最初のバッチのprefetch
persistent_workers=Trueにすると、Datasetを1周した後もワーカーを終了しません。2エポック目以降はプロセス起動を繰り返さずに済みます。
ただしワーカーを維持するとプロセスとDatasetのメモリも維持されます。エポック間に長時間止まるjobや、巨大なDataset objectではトレードオフになります。
prefetch_factor=2は何を意味するか
ワーカーがあるとき、各ワーカーは先のバッチをキューへ準備します。prefetch_factor=2なら概念上、ワーカーごとに最大2 バッチを先読みします。
16ワーカーなら最大32 バッチ分が処理の流れ上に存在し得ます。バッチ 256の高解像度画像ならCPU側のメモリや共有メモリを多く使います。
ワーカーを増やしてBus error、共有メモリ不足、RAM圧迫が起きる場合は、ワーカー数、バッチサイズ、prefetch_factorを下げます。処理速度だけでなく/dev/shmとRAMも観測対象です。
pin_memoryは速くならなかった
pin_memory=TrueはDataLoaderがページ固定されたCPUメモリへバッチを置く設定です。pinned メモリからGPUへのコピーは、non_blocking=Trueと組み合わせてasynchronousにできます。
images = images.cuda(non_blocking=True)
labels = labels.cuda(non_blocking=True)
PyTorch公式のpin メモリ / non_blocking guideも、DataLoader側でpinningし、non-blocking transferを使う方法を解説しています。
しかし今回の画像拡張・4ワーカー・各5回では次の結果でした。
- OFF:1.634秒(1.611~1.649)
- ON:1.635秒(1.599~1.669)
中央値はほぼ同じで範囲も重なります。28×28×1 チャネル、バッチ 256は転送量が小さく、CPU 前処理と学習計算の方が支配的です。また専用CUDA ストリームで明示的にprefetchしていないため、転送と計算のoverlap余地も限定的です。
これはpin_memoryが無意味という結論ではありません。高解像度・大バッチでH2D転送が大きい場合は効果が変わります。pinned メモリはswapできないため、過剰使用はhost RAMへ圧力をかける点にも注意します。
このPCでは12付近から伸びが小さくなった
論理CPUは28個ありますが、前処理が軽い条件は8〜12、切り抜きと回転を加えた条件は12付近から速度の伸びが小さくなりました。論理CPU数と同じだけプロセスを起動する必要はなさそうです。
画像が大きくなると、先読みして保持するデータも増えます。並列数を増やして共有メモリ不足が出る場合は、/dev/shmとRAMを確認し、バッチサイズやprefetch_factorも下げます。
再現方法
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments/work/ai_lab

/opt/ai-lab/venv/bin/python experiment_dataloader_bottleneck.py \
  --data-dir /opt/ai-lab/data \
  --output results/dataloader_bottleneck.json \
  --figure ../../outputs/dataloader-bottleneck-workers16.png
図だけ再作成する場合です。
/opt/ai-lab/venv/bin/python plot_dataloader_bottleneck.py \
  results/dataloader_bottleneck.json \
  ../../outputs/dataloader-bottleneck-workers16.png
JSONには全ワーカー一通りの測定、pin_memory各5回、高ワーカー各5回の未集計値を保存しています。
起動時間込みで使い分ける
同じデータを何周も学習するなら、persistent_workers=Trueで起動コストを払う回数を減らせます。短い試行を何度も始め直す場合は、2エポック目の速さだけでは選びにくい設定です。
今回、画像の切り抜きと回転を入れた条件では並列化がよく効きました。どこで待っているかは、profilerでDataLoaderの待ち時間を追った記事にも載せています。
