実験機: Core i7-14700F、RTX 5070 Ti 16 GB、RAM 32 GB
環境: Windows 11、WSL 2、Ubuntu 26.04 LTS、Python 3.12.14、PyTorch 2.12.1+cu130(予測)/2.11.0+cu130(異常検知)
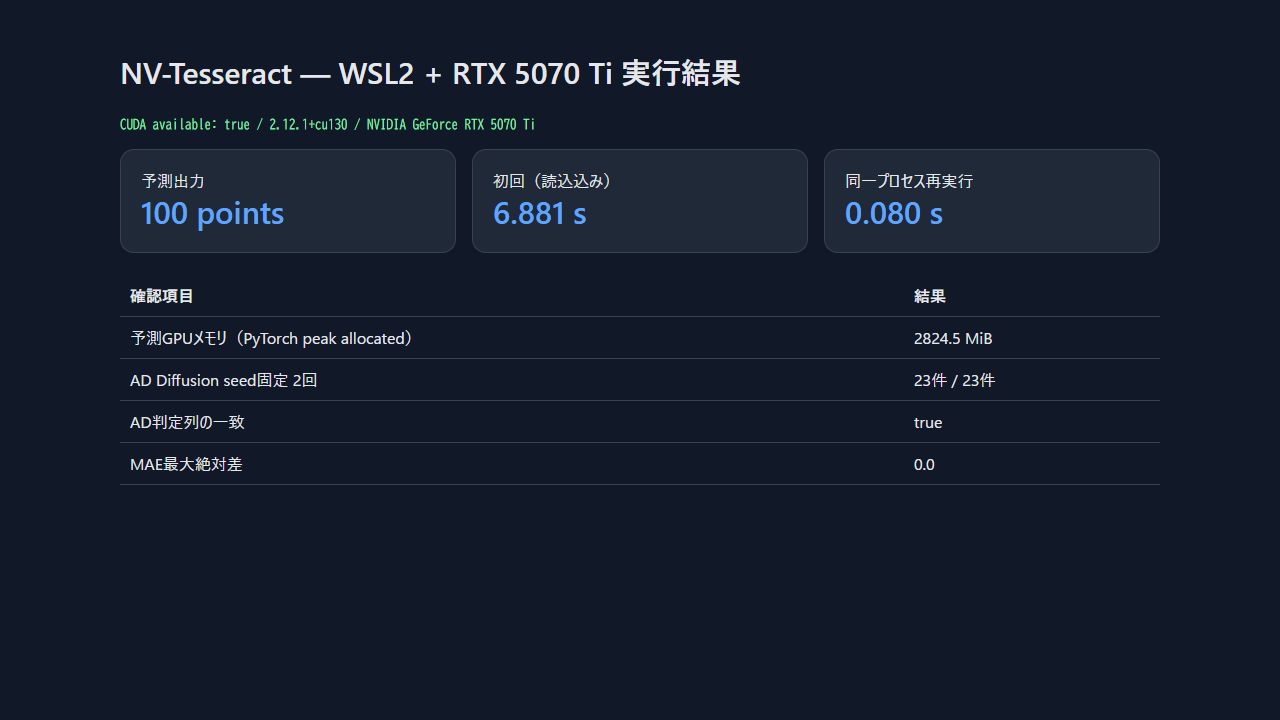
NV-Tesseractの公式サンプルを、WSL 2とRTX 5070 Tiで動かしました。時系列の100点予測と、500点のデータから異常箇所を探す処理まで実行できています。
名前は似ていますが、文字認識のTesseractとは別物です。こちらはNVIDIAの時系列データ用ライブラリで、予測と異常検知のモデルを使えます。導入ではチェックポイントの形状エラーに当たり、異常検知では乱数シードによって検出数が変わりました。
| 確認項目 | 結果 |
|---|---|
| WSL 2からCUDAを認識 | 成功 |
| ETThサンプルの100点予測 | 成功 |
| 予測1回目(モデル読込込み、重み取得済み) | 6.881秒 |
| 同一プロセスの予測2回目 | 0.080秒 |
| 予測時のPyTorch ピーク allocated | 2,824.5 MiB |
| AD Diffusionの500点異常検知 | 成功 |
| 異常検知のGPU使用率(200 ms間隔の最大値) | 81% |
異常検知のGPUメモリ(nvidia-smi最大値) |
1,483 MiB |
動きました。
異常検知の公式サンプルは、そのまま2回実行すると検出数が変わりました。PyTorch側の乱数も固定すると、2回の出力は完全に一致しました。
NV-Tesseractは何をするものか
NVIDIA公式リポジトリには、次の2モジュールが含まれています。
forecasting/: 過去の時系列から未来の値を予測するad_diffusion/: 複数センサーなどの時系列から異常候補を検出する
予測とは、たとえば直前512時間の負荷から、その後72時間や100時間の値を推定する処理です。異常検知は、入力をモデルで再構成し、元データとの差が大きい点を異常候補として扱います。今回の異常度はMAE(Mean Absolute Error、平均絶対誤差)で表されます。
公式要件はPython 3.12以上、PyTorch 2.7以上、pandas、NumPyです。GPUが推奨されていますが、CUDAが無い場合はCPUへフォールバックする設計です。今回はGPUで動くことを確かめるため、実行前にCUDAの認識まで確認しました。
必要なものと空き容量
必須
- Windows 11とWSL 2
- WSL側のUbuntu
- WSLから利用できるNVIDIA GPUドライバ
- Git
- インターネット接続
- 15 GB以上の空き容量(予測モジュールだけの目安)
あると確認しやすいもの
nvidia-smi- RTX系GPU
- 16 GB程度のGPUメモリ
16 GBのVRAMを使い切ったわけではありません。予測のPyTorch ピーク allocatedは約2.76 GiBでした。ただし、この1条件だけから「すべての8 GB GPUで必ず動く」とまでは言えません。入力チャンネル数、バッチサイズ、説明機能、別チェックポイントで必要量は変わります。
ディスク側はやや重めです。このPCでは予測用.venvが約5.0 GB、NVIDIAの予測チェックポイントが約1.40 GB、MOMENT backboneが約1.39 GBでした。uvのダウンロードキャッシュも残るため、ぎりぎりの空き容量で始めない方が安全です。
管理者権限とWindows再起動は、すでにWSLとGPUドライバが動いていれば不要でした。WSLからCUDAを使える状態がまだ無い場合は、先に「Windows 11+WSL 2でPyTorchからRTX 5070 Tiを使う」の確認手順を通すと切り分けやすくなります。
WSL 2からGPUを確認する
まずUbuntuを開き、GPUとPythonを確認します。
/usr/lib/wsl/lib/nvidia-smi
python3 --version
git --version
このPCでは次を確認できました。
NVIDIA GeForce RTX 5070 Ti
Driver Version: 595.71
GPU Memory: 16303 MiB
Python 3.14.4
git version 2.53.0
システムPythonは3.14でしたが、NV-Tesseract用には3.12の隔離環境を作ります。プロジェクトごとにPythonとパッケージを分けると、別のPyTorch環境を壊しにくくなります。
uvとNV-Tesseractを導入する
このPCにはuvが無かったため、小さなbootstrap用venvへ入れました。
python3 -m venv ~/.venvs/nv-tesseract-bootstrap
~/.venvs/nv-tesseract-bootstrap/bin/python -m pip install --upgrade pip uv
~/.venvs/nv-tesseract-bootstrap/bin/uv --version
確認できたバージョンはuv 0.12.8です。続いて公式リポジトリを取得し、予測用環境を同期します。
git clone https://github.com/NVIDIA/NV-Tesseract.git
cd NV-Tesseract/forecasting
~/.venvs/nv-tesseract-bootstrap/bin/uv sync --python 3.12
初回はPyTorchとCUDA関連パッケージをまとめてダウンロードします。このPCでは91 パッケージが入りました。
リポジトリを/mnt/c配下へ置き、キャッシュをWSL filesystemへ置いたところ、uvはhardlinkを作れずコピーへ切り替わりました。処理自体は成功しますが、展開に約2分45秒かかりました。次の警告は失敗ではありません。
warning: Failed to hardlink files; falling back to full copy.
If the cache and target directories are on different filesystems,
hardlinking may not be supported.
Windowsから原稿やCSVを直接開きたかったので今回は/mnt/cを使いました。速度を優先する場合は、リポジトリとキャッシュを同じWSL filesystem側へ置く構成も検討できます。
PyTorchからRTX 5070 Tiが見えているか
予測を始める前に、作成されたPythonでCUDAを確認します。
.venv/bin/python -c "import torch; print(torch.__version__); print(torch.version.cuda); print(torch.cuda.is_available()); print(torch.cuda.get_device_name(0)); print(torch.cuda.get_device_capability(0))"
実際の出力です。
2.12.1+cu130
13.0
True
NVIDIA GeForce RTX 5070 Ti
(12, 0)
torch.cuda.is_available()がTrueで、GPU名も一致しています。(12, 0)はcompute capabilityです。ここまで通れば、少なくとも「CPU版PyTorchを入れてしまった」「WSLからGPUが見えない」という段階は抜けています。
ETThの512点から100点を予測する
予測にはリポジトリ同梱のETTh_single_feature.csvを使いました。ETThは電力変圧器温度の時系列で、今回はLULL列の最後512点を入力し、その先100点を出します。
固定した条件は次のとおりです。
| 項目 | 設定 |
|---|---|
| 入力 | 公式ETTh single-feature サンプル |
| target | LULL |
入力長 seq_len |
512 |
出力長 forecast_horizon |
100 |
| モデル native horizon | 72 |
| バッチサイズ | 1 |
| 乱数シード | 42 |
| cross-channel | 無効 |
最小構成は次のようになります。model_horizonは公開チェックポイントに合わせて72のままにします。
from pathlib import Path
import pandas as pd
from sdk.forecasting import ForecastingConfig, perform_forecasting

csv_path = Path("sdk/tests/datasets/ETTh_single_feature.csv")
df = pd.read_csv(csv_path).tail(512)

config = ForecastingConfig(
    timestamp_column="timestamp",
    target_column="LULL",
    seq_len=512,
    forecast_horizon=100,
    model_horizon=72,
    batch_size=1,
    num_workers=0,
    seed=42,
    use_cross_channel=False,
)

forecast = perform_forecasting(df=df, config=config)
forecast.to_csv("forecast.csv", index=False)
print(forecast.head(10))
初回はHugging Faceから重みを自動取得します。予測チェックポイントは約1.40 GB、MOMENT backboneは約1.39 GBでした。認証なしで取得できましたが、未認証リクエストのrate limit 警告は表示されました。
出力はtimestampとLULL_forecastを持つ100行のDataFrameです。先頭10点は次の値でした。
1.2353706, 1.3113322, 1.4206676, 1.4212670, 1.3020000,
1.4943643, 1.4871302, 1.5049992, 1.4743977, 1.4228201
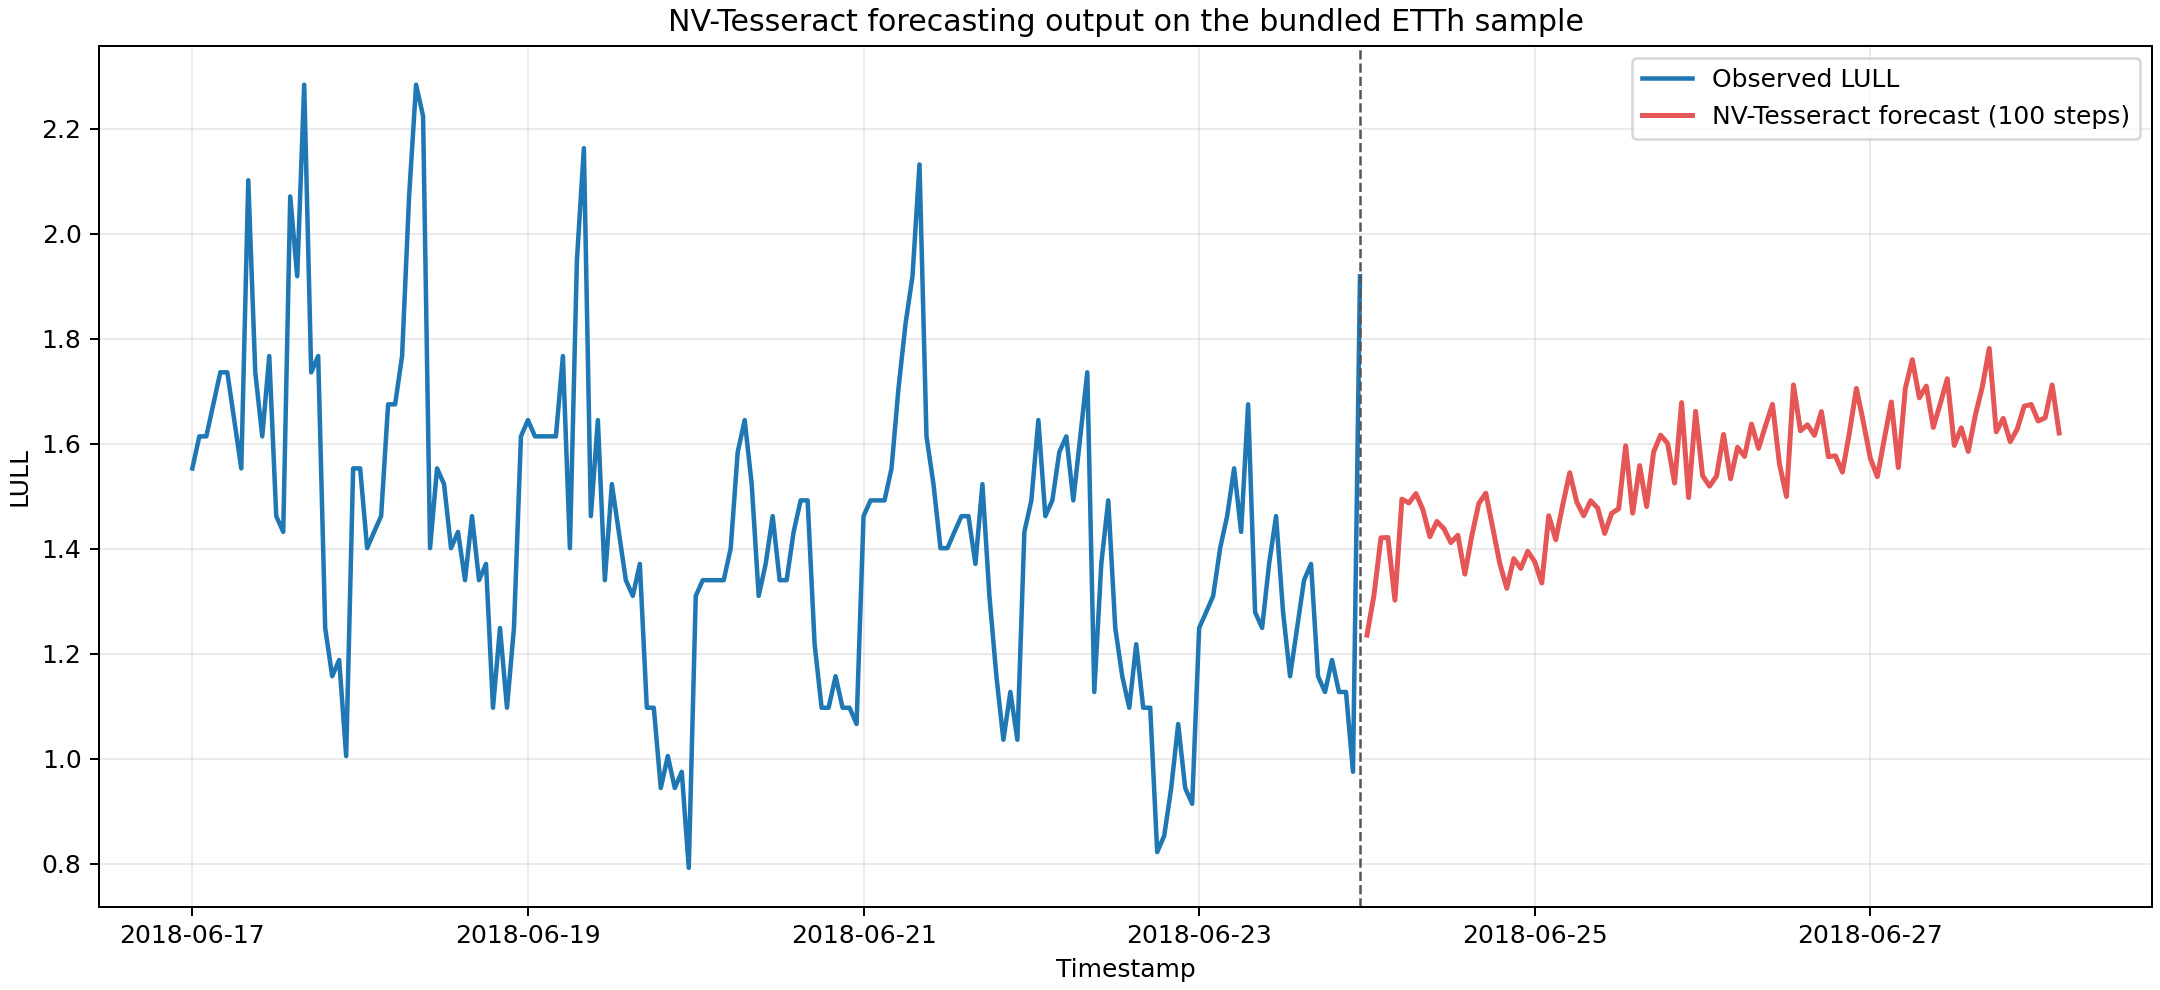
この図は「未来を正しく当てた」ことの証明ではありません。今回は実行可否と出力形状を確認する試験であり、予測区間の正解データとMAEを比較していないためです。精度評価では入力末尾をさらに手前へずらし、隠した100点と予測を比較する必要があります。
100点予測で起きたチェックポイント形状エラー
最初はforecast_horizon=100に合わせ、model_horizonも100へ変更しました。するとチェックポイント読込時に止まりました。
RuntimeError: Error(s) in loading state_dict for BackbonePipeline:
size mismatch for head.linear.weight:
checkpoint torch.Size([72, 65536])
current model torch.Size([100, 65536])
公開チェックポイントの予測headは72出力です。一方で100に作り替えたモデルは100出力を要求するため、重みの形が合いません。
修正はmodel_horizon=72へ戻し、forecast_horizon=100だけを指定することでした。SDKはnative horizonを超えた残り28点を自己回帰で延長します。NVIDIAのモデル cardにも、native capabilityを超えるhorizonはautoregressive extensionに対応すると記載されています。
正直、100点欲しいから両方100にする、という設定はそれっぽく見えます。チェックポイントの出力層まで変わるのが厄介です。
モデル読込込みとウォームアップ後回を分けて測る
同じ入力を同一プロセス内で2回実行しました。どちらも重みファイルはダウンロード済みです。
| 回 | 含まれる処理 | 時間 | PyTorch ピーク allocated | ピーク reserved |
|---|---|---|---|---|
| 1 | チェックポイント読込+モデル構築+推論 | 6.881秒 | 2,824.5 MiB | 2,828 MiB |
| 2 | キャッシュ済みモデル+推論 | 0.080秒 | 2,060.9 MiB | 2,082 MiB |
1回目を「純粋な推論速度」と呼ぶのは不正確です。モデルの読込とGPUへの配置が含まれています。2回目はSDK内のモデルキャッシュを再利用しており、100点の出力は1回目と一致しました。
また、初回重みダウンロードはこの表に含めていません。回線速度で大きく変わるため、ダウンロード、モデル読み込み、ウォームアップ後推論は分けて扱う方が結果を読みやすくなります。
AD Diffusionで500点の異常検知を動かす
異常検知側は別の依存関係を持つため、ad_diffusionにも独立した環境を作りました。
cd ../ad_diffusion
~/.venvs/nv-tesseract-bootstrap/bin/uv sync --python 3.12
.venv/bin/python examples/quick_example.py --download-weights
.venv/bin/python examples/quick_example.py
異常検知チェックポイントのfinal_model.pthは約29.6 MBです。公式quick 例は乱数シード 42で500点・3 sensorの合成時系列を作り、spike、dip、段階 shift、noiseを混ぜます。推論はDPM-Solver 20ステップ、nsample=15でした。
最初の実行は約13.58秒で推論し、21点を異常として検出しました。precision 1.000、再現率 0.171、F1 0.292です。
precisionが1.000なので、検出した点にfalse positiveはありません。一方、再現率 0.171なので、正解ラベルの多くを拾えていません。少数の強い異常だけを選んだ状態です。公式サンプルが完走したことと、運用に十分な検出性能であることは分けて考える必要があります。
同じ公式サンプルなのに検出数が変わる
GPU使用量を200 ms間隔で記録しながら公式例を2回実行すると、結果は次のように変わりました。
| 回 | 検出数 | TP | FP | FN | precision | 再現率 | F1 | total elapsed |
|---|---|---|---|---|---|---|---|---|
| 1 | 18 | 18 | 0 | 105 | 1.000 | 0.146 | 0.255 | 27.575秒 |
| 2 | 24 | 24 | 0 | 99 | 1.000 | 0.195 | 0.327 | 28.105秒 |
入力データは同じです。公式例は合成データ生成用のnp.random.seed(42)を設定していますが、拡散モデルが使うPyTorchの乱数までは固定していません。
そこで、各回前に次を追加しました。
import numpy as np
import torch

np.random.seed(42)
torch.manual_seed(42)
torch.cuda.manual_seed_all(42)
乱数シード固定後は2回とも23点を検出し、Anomaly列は完全一致、MAEの最大絶対差も0でした。実行時間は14.082秒と12.792秒です。
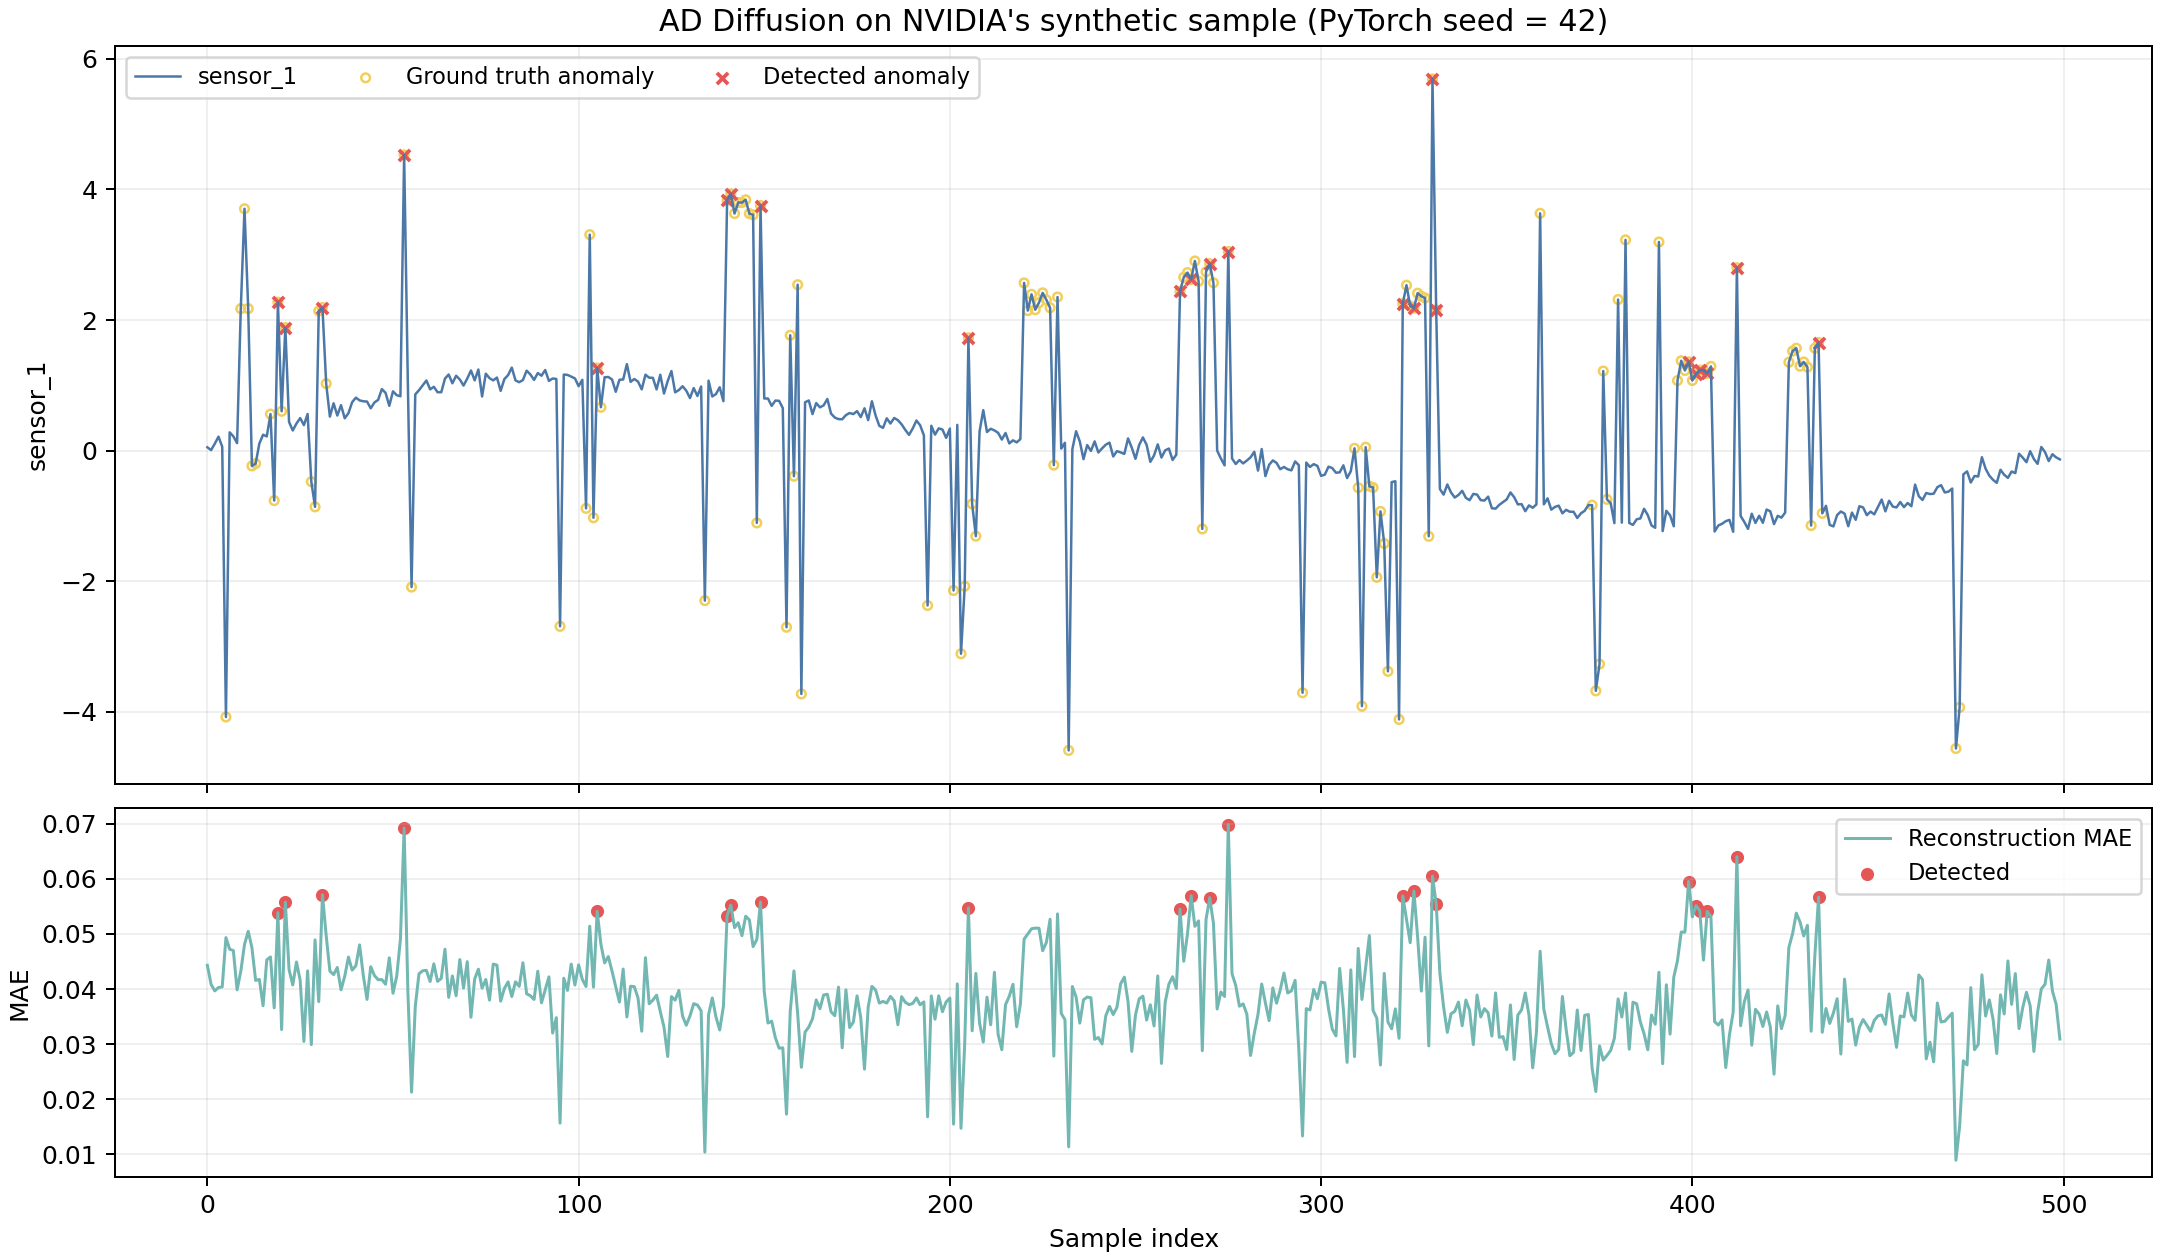
乱数シード固定後の混同行列はTP 23、FP 0、FN 100、TN 377でした。precision 1.000、再現率 0.187、F1 0.315です。
ここから分かるのは、乱数シードを固定すれば同じ環境・同じ入力で結果を再現できることです。検出精度が高いという意味ではありません。threshold strategy、nsample、前処理、実データへの追加学習は別途評価が必要です。
GPUが本当に使われたか
AD Diffusion実行中にnvidia-smiを200 ms間隔で取得しました。
| 指標 | 観測した最大値 |
|---|---|
| GPU 使用率 | 81% |
| GPUメモリ used | 1,483 MiB |
| power draw | 219.3 W |
torch.cuda.is_available()だけでなく、推論中にGPU使用率と消費電力が上がったため、実計算がGPUへ渡ったことを確認できます。ただし200 ms間隔のサンプルなので、サンプル間にある瞬間的なピークを取り逃す可能性があります。
予測側の2,824.5 MiBはPyTorch allocatorがプロセス内で記録したピーク allocated、異常検知側の1,483 MiBはnvidia-smiが見たデバイス全体の使用量です。測り方が違うため、両者をそのままモデル間のVRAM比較には使えません。
よく止まりそうな箇所
torch.cuda.is_available()がFalse
NV-Tesseractより手前の問題です。Windows側ドライバ、WSL update、CUDA版PyTorchの順に確認します。WSL内へ通常のLinux用NVIDIA ドライバを重ねて入れる前に、Windows側ドライバがWSLへ公開されているかを確認した方が安全です。
100出力チェックポイントのサイズ mismatch
forecast_horizon=100でもmodel_horizonは公開チェックポイントの72へ合わせます。100へ変えるのは出力要求側だけです。
Hugging Faceの401/403
今回は認証なしでダウンロードできました。401や403が出る場合は、モデル pageの利用条件、Hugging Face側のライセンス acceptance、トークン設定を公式READMEに沿って確認します。トークンは記事やログへ貼らないでください。
diskが急に減る
予測environment、CUDA パッケージ、NVIDIA チェックポイント、MOMENT backbone、ダウンロードキャッシュが別々に存在します。du -sh .venvとキャッシュディレクトリを確認します。削除前に、どのenvironmentが参照しているかを確かめてください。
実行ごとに異常数が変わる
合成データ用のNumPy 乱数シードだけでは足りません。PyTorchとCUDA側の乱数シードも固定します。それでもGPU演算によっては完全決定的にならない演算子があるため、出力差を測って確認するのが確実です。今回はMAE最大絶対差0まで確認しました。
この結果から判断できること
WSL 2、RTX 5070 Ti、CUDA 13.0系PyTorchの組み合わせで、NV-Tesseractの時系列予測とAD Diffusionは動作しました。予測は公式ETTh サンプルから100点を返し、異常検知は公式の500点サンプルをGPUで処理できています。
導入上の注意は、VRAMより先にダウンロード容量とPython環境の分離です。予測は公開重みだけで約2.8 GBあり、CUDA dependencyを含むvenvも約5 GBになりました。一方、今回の予測時PyTorch ピーク allocatedは約2.76 GiBでした。
また、公式quick 例の数値をベンチマーク表へそのまま転記するのは危険です。異常検知はPyTorch 乱数シードを固定しないと検出数が変わり、precision 1.0でも再現率は0.2未満でした。少なくとも乱数シード、入力、sampling条件、threshold、計測方法を固定してから比較する必要があります。
今回動作を確認できたのは、このPCでのリポジトリ同梱サンプルです。実センサーの異常を十分に検出できるか、別GPUでも同じ速度が出るか、CPU 切り替えが実用的な速度かは、この結果からは判断できません。
再現に使った生成ファイル
検証スクリプトでは、次を生データとして保存しました。
- 予測100点のCSVを2回分
- Python、PyTorch、CUDA、GPU、commit hash、条件を含むJSON
- GPUメモリ、使用率、powerの200 ms サンプル
- AD Diffusionの結果CSVと正解ラベル
- 乱数シード固定前後の混同行列
- console ログと未丸めのelapsed time
リポジトリはcommit b68ea6f946b9b299d48f91673fd722366c150e99を使用しました。NV-Tesseractは更新が続いているため、結果が変わった場合はcommit hashとlock ファイルから先に確認すると追いやすくなります。
参考資料
- NVIDIA/NV-Tesseract(GitHub)
- NV-Tesseract Forecasting モデル card(Hugging Face)
- NV-Tesseract AD Diffusion モデル card(Hugging Face)
- CUDA GPU Compute Capability(NVIDIA Developer)
関連するGPU測定方法は、バッチサイズと処理速度・VRAM・CUDA OOMの実測でも条件を分けて整理しています。