PyTorch 2.13.0+cu130
GPU: NVIDIA GeForce RTX 5070 Ti 16 GB / WSL2 Ubuntu 26.04
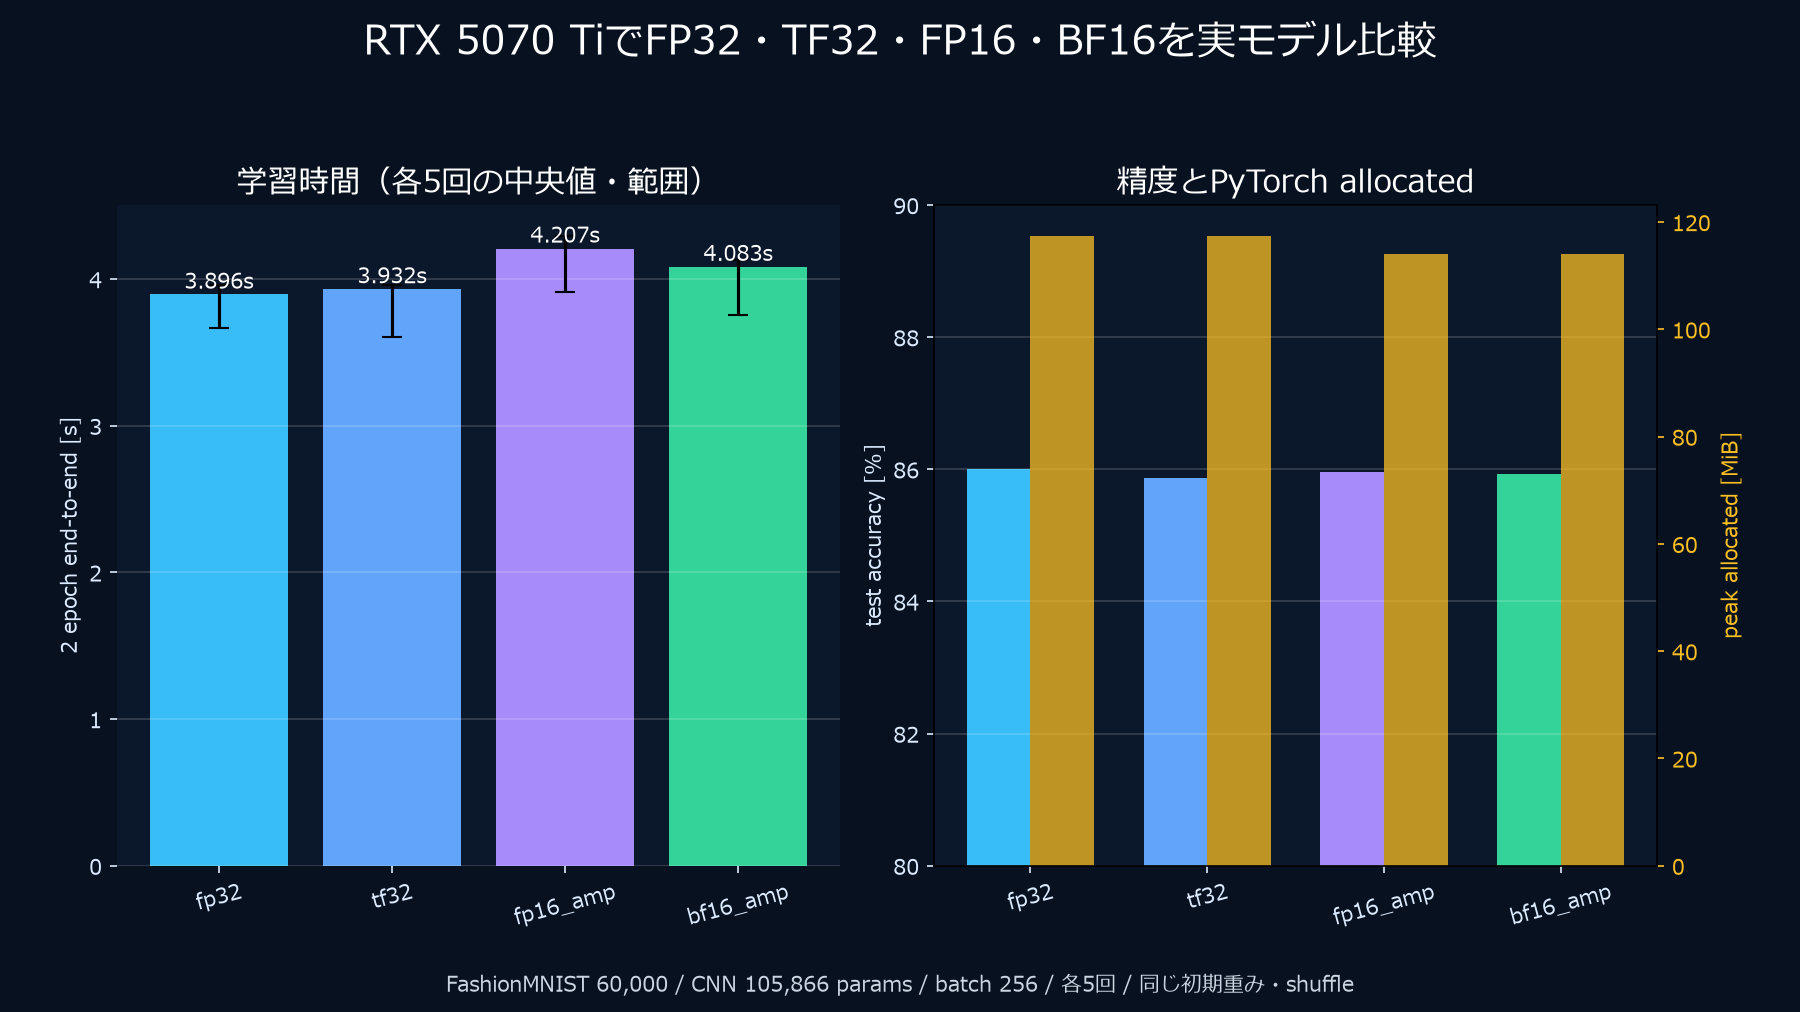
FashionMNISTのCNNに混合精度学習のAMPを入れてみました。このモデルではFP16がFP32より約8%、BF16が約4.8%遅くなりました。GPUはRTX 5070 Tiです。
一度だけ測ったときはTF32も速く見えたのですが、順番を変えながら各5回測ると、その差ははっきりしませんでした。速度とGPUメモリの結果を、FP32・TF32・FP16・BF16で比べます。
AMPが少し遅かった
FP32(TF32無効)
3.896秒(3.664~3.959秒)/ テスト 86.00% / allocated 117.3 MiB / reserved 170.0 MiB
TF32
3.932秒(3.607~3.961秒)/ FP32比0.9%遅い / テスト 85.87% / allocated 117.3 MiB / reserved 170.0 MiB
FP16 AMP
4.207秒(3.911~4.290秒)/ FP32比8.0%遅い / テスト 85.96% / allocated 114.0 MiB / reserved 138.0 MiB
BF16 AMP
4.083秒(3.753~4.129秒)/ FP32比4.8%遅い / テスト 85.93% / allocated 114.0 MiB / reserved 138.0 MiB
- TF32とFP32の時間範囲は大きく重なり、この実験では実質的な差を確認できませんでした。
- FP16 AMPとBF16 AMPは速くなりませんでした。
- AMPはピーク allocatedを約2.8%、ピーク reservedを約18.8%減らしました。
- 精度差は最大0.13ポイントです。2エポック・初期値1種類なので、優劣とは解釈しません。
4つの「精度」は同じ種類の設定ではない
最初に、用語を分けます。
| 形式 | 指数部 | 仮数部 | 主な特徴 |
|---|---|---|---|
| FP32 | 8 bit | 23 bit | 広い範囲と比較的高い精度。通常のモデル・重みの基準 |
| TF32 | 8 bit | 10 bit | FP32 Tensorを保存したまま、対応する行列積・畳み込み内部で使われる形式 |
| FP16 | 5 bit | 10 bit | 狭い数値範囲。高速・省メモリだが小さい勾配のunderflowに注意 |
| BF16 | 8 bit | 7 bit | FP32と同じ指数幅。精度は粗いが広い数値範囲を保つ |
TF32はtorch.float32とは別の保存dtypeではありません。FP32の入力を受けた行列積や畳み込みについて、対応GPUが内部計算へTF32 Tensor Coreを使うことを許す設定です。入力の仮数を10 bit相当へ丸め、積和の累積はFP32で行います。
一方、AMP(Automatic Mixed Precision)は、全演算を一律に16 bitへ変える仕組みではありません。autocastが演算ごとの性質に応じてFP16/BF16またはFP32を選びます。PyTorch公式のAutomatic Mixed Precision recipeも、畳み込みや全結合は低精度が速い場合がある一方、reductionなどはFP32の動的範囲を必要とすると説明しています。
なぜFP16ではGradScalerを使うのか
FP16は指数部が5 bitしかなく、表現できる小さい値の範囲が狭い形式です。逆伝播で生じた微小な勾配が0へ丸められると、重みを更新できません。
そこで損失を一時的に大きくしてから逆伝播します。
scaler = torch.amp.GradScaler("cuda")

with torch.autocast(device_type="cuda", dtype=torch.float16):
    logits = model(images)
    loss = loss_function(logits, labels)

scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()
scaler.step()は勾配を元のスケールへ戻し、infやNaNがあれば最適化器更新をskipします。今回の最終スケールは32,768でした。
BF16はFP32と同じ8 bitの指数部を持ち、FP16よりunderflowしにくいため、今回はGradScalerを使いませんでした。ただし「BF16なら数値問題が絶対に起きない」という意味ではありません。
TF32は現行PyTorch APIで明示的に切り替える
PyTorch 2.9以降は精度をバックエンド別に指定できます。今回のPyTorch 2.13では次のようにしました。
def set_tf32(enabled: bool) -> None:
    precision = "tf32" if enabled else "ieee"
    torch.backends.cuda.matmul.fp32_precision = precision
    torch.backends.cudnn.fp32_precision = precision
古い記事で見かけるtorch.backends.cuda.matmul.allow_tf32とtorch.backends.cudnn.allow_tf32は非推奨化予定です。詳細はPyTorch公式のCUDA 意味: TensorFloat-32を参照してください。
実験条件:比較で変えたのは精度モードだけ
モデルは前回と同じ105,866パラメータのCNNです。
1×28×28
  → Conv(1→16, 3×3) → ReLU → MaxPool
  → Conv(16→32, 3×3) → ReLU → MaxPool
  → Flatten(1568)
  → Linear(1568→64) → ReLU → Linear(64→10)
比較条件は次のように統制しました。
- FashionMNIST:学習60,000枚、テスト10,000枚
- バッチサイズ:256
- 最適化器:Adam、学習率 0.001
- エポック:2
- 同一の初期重みを各回へコピー
- DataLoaderの並べ替え乱数シード:42
num_workers=0、pin_memory=True- 各回の前に合成バッチで3 学習ステップをウォームアップし、時間から除外
- 時間にDataLoader、host→デバイス転送、順伝播、逆伝播、Adam更新を含める
- テスト評価時間は除外
- CUDAの非同期実行を考慮し、計測前後に
torch.cuda.synchronize() - 各モード5回。モード順を反復ごとに巡回し、初回起動や温度の順序バイアスを軽減
たとえば、最初の反復はFP32→TF32→FP16→BF16、次はTF32→FP16→BF16→FP32です。全条件を完全にrandom化したわけではありませんが、「FP32だけ必ず最初」という偏りは避けました。
1回の測定では結論が逆転した
最初の単発測定ではTF32がFP32より約6%速く見えました。しかし、現行APIへ直して各5回測ると、中央値はFP32が3.896秒、TF32が3.932秒です。しかも測定範囲は大きく重なっています。
今回の小型CNNでは、TF32の速度差は実行時間の揺らぎに埋もれ、向上を確認できませんでした。 遅くなったとも判断できません。
この程度の差だと、1回測っただけでは順位が変わります。表にはウォームアップ後の5回の範囲も載せました。
なぜTensor CoreがあるのにAMPは遅くなったのか
小さな処理を繰り返す際の追加コストが影響した可能性があります。ただし、今回は演算ごとの時間を分解していないため、主因までは特定できていません。
今回の入力は28×28の1 チャネル画像、モデルは約10.6万パラメータです。バッチ 256でも、1ステップの畳み込み・行列積はRTX 5070 Tiにとって小さい仕事です。その一方でAMPには次の固定費があります。
autocastが演算ごとのdtypeを選ぶ- 必要なTensorをcastする
- FP16では損失をスケール / unscaleする
inf/NaNを確認して最適化器更新を判断する- 小さなカーネルを何度もlaunchする
低精度演算で短縮できる時間より、この固定費が大きければ全体は遅くなります。PyTorch公式recipeのtroubleshootingにも、ネットワークがGPUを飽和させずCPU boundならAMPのspeedupが小さい場合があると記載されています。
大きなCNNやTransformer、バッチでは計算量と中間出力メモリが増えるため、AMPの速度やメモリ面の効果も変わる可能性があります。バッチサイズを変えて測れば、傾向がどこで変わるか確認できます。
allocatedとreservedは別のメモリ指標
PyTorchのCUDA caching allocatorには、少なくとも2つの見方があります。
max_memory_allocated():Tensorが実際に占有したメモリのピークmax_memory_reserved():PyTorch allocatorが再利用のためGPUから確保した領域のピーク
torch.cuda.reset_peak_memory_stats()
# training
allocated = torch.cuda.max_memory_allocated() / 1024**2
reserved = torch.cuda.max_memory_reserved() / 1024**2
今回、allocatedは117.3→114.0 MiBと約2.8%減、reservedは170→138 MiBと約18.8%減でした。小型モデルなので絶対量はわずかですが、速度が上がらなくてもメモリ面の効果は確認できました。
nvidia-smiのプロセスメモリとは一致しません。CUDA コンテキスト、ライブラリ、PyTorch外のallocationなど、見ている範囲が違うためです。定義はPyTorch公式のCUDA メモリ managementで確認できます。
精度が高かったモードを「勝ち」としない理由
テスト精度中央値は85.87~86.00%でした。FP32が0.13ポイント高いものの、この差だけで数値形式の優劣は判断できません。
今回は初期重みと並べ替えを固定した比較であり、独立した複数乱数シードによる汎化性能の比較ではないからです。またGPU カーネルには非決定的な実装が含まれる場合があり、同条件のFP32でも85.93~86.02%の幅が出ました。
精度の差を詳しく調べるには、初期値を変えた学習も必要です。ここでは同じ初期値での所要時間とメモリ使用量を比較しています。
再現方法
実験コードはexperiment_fashion_precision.pyです。WSL側のvenvで次のように実行しました。
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments/work/ai_lab

/opt/ai-lab/venv/bin/python experiment_fashion_precision.py \
  --repeats 5 \
  --data-dir /opt/ai-lab/data \
  --output results/fashion_precision.json \
  --figure ../../outputs/fashion-precision-comparison.png
JSONには全20回のエポック時間、損失、train/test精度、images/s、allocated/reserved、GradScalerの最終スケールを保存しています。グラフだけでなく生データを残すと、集計ミスを後から検証できます。
速度よりメモリに差が出た
今回のCNNでは、AMPによる速度向上はありませんでした。一方、PyTorchが予約したメモリは170 MiBから138 MiBへ減っています。速度だけを見ていると、この差は見落とします。
大きなモデルやバッチでも同じ結果になるかは未確認です。AMPを使う際は、FP32での結果を残したうえで、損失が正常に下がるか、学習全体の時間とメモリがどう変わるかを見比べます。
