FPGA

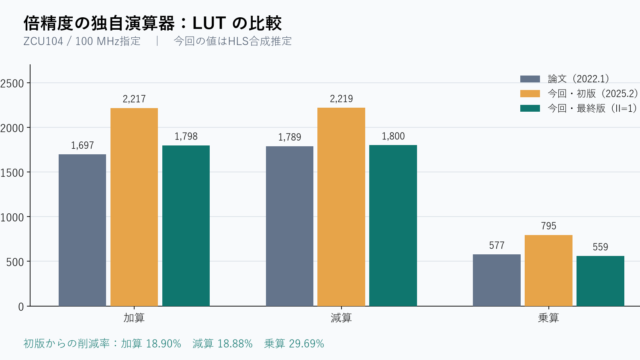
倍精度浮動小数点演算器をVitis HLS 2025.2で再実装する:FIT2024 C-003の検証と資源最適化

FIT2024 C-003を題材に、ZCU104・100 MHzで倍精度加減乗算を独立再実装しました。丸めと例外処理を維持してLUTを19〜30%削減し、AMD公式モデルと連続入力RTLでII=1を検証。論文との資源比較、Gauss–Jordanへの適用、実装時の確認点をまとめます。
AI・機械学習

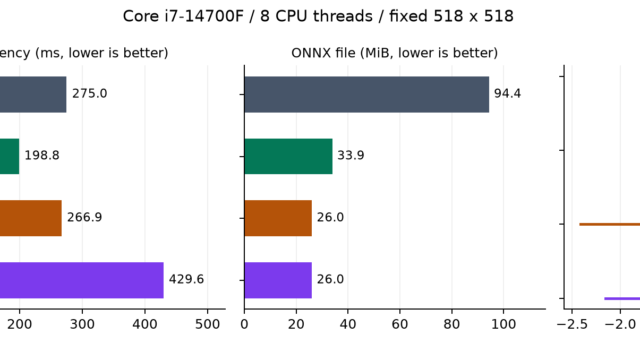
Depth Anything V2 SmallにFP32は必要か。CPU・GPUでINT8・INT4・FP8を比べた

Depth Anything V2 SmallをCPUとRTX 5070 Tiで実測。INT8・INT4・FP8の容量と速度、NYUv2・Sintelの正解深度で精度を比較。FP8は容量を減らせましたが、このORT実装ではFP16より遅くなりました。
AI・機械学習

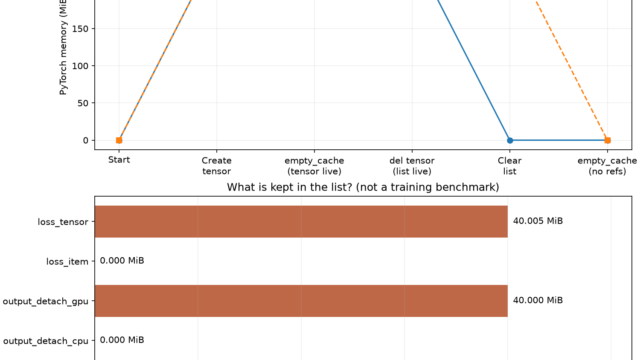
PyTorchでempty_cacheしてもGPUメモリが減らない。delとdetachの違いを実測する

torch.cuda.empty_cache()を呼んでも、まだ使っているテンソルは消えません。256 MiBのテンソルで試すと、変数をdelした後もリストに同じテンソルが残っていれば、使用量は256 MiBのままでした。リストを空にすると...
English

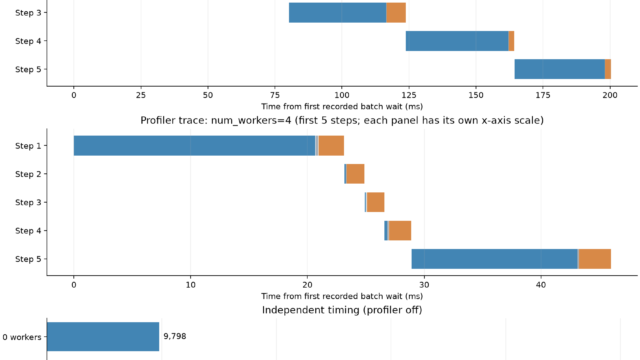
Is PyTorch waiting for data? Comparing DataLoader workers with torch.profiler

Increasing DataLoader workers made this FashionMNIST training loop faster. I used torch.profiler to see where the time w...
English

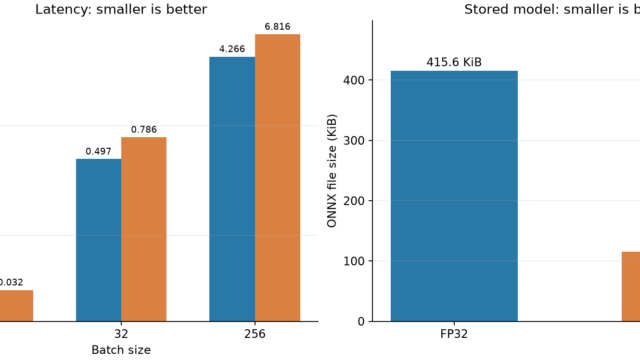
ONNX INT8 quantization made this CNN smaller—but slower on the CPU

I converted a FashionMNIST CNN to INT8 with ONNX Runtime and ran it on the CPU. The model file became about 72% smaller,...
English

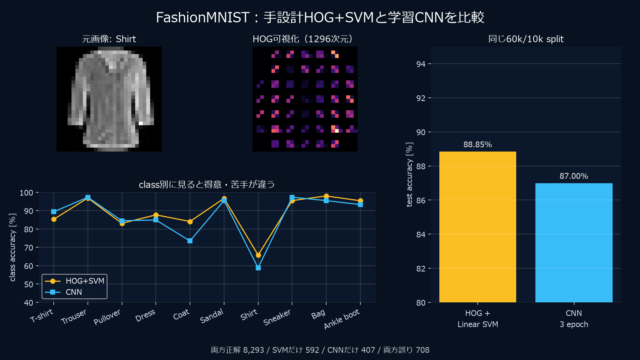
HOG + SVM versus a small CNN on FashionMNIST: accuracy, runtime and different mistakes

HOG features with a linear SVM reached 88.85% accuracy on FashionMNIST, ahead of 87.00% for a small CNN trained for thre...
AI・機械学習

ONNXのCNNを実際にINT8量子化したら速くなる?精度・容量・CPU推論を比較

English version重みを丸める実験に続いて、今度はONNX RuntimeでINT8のモデルを作り、CPUで実行しました。ファイルは約72%小さくなりましたが、推論は試した3種類のバッチサイズすべてで遅くなりました。正解率は86...
AI・機械学習

PyTorch学習が遅いのはDataLoaderかGPUか?profilerで待ち時間を切り分ける

English versionDataLoaderの並列数を変えると学習が速くなったので、torch.profilerで処理の内訳を見ました。画像に切り抜きと回転を加えた条件では、num_workers=0の学習ループは次の画像群を受け取る...
AI・機械学習

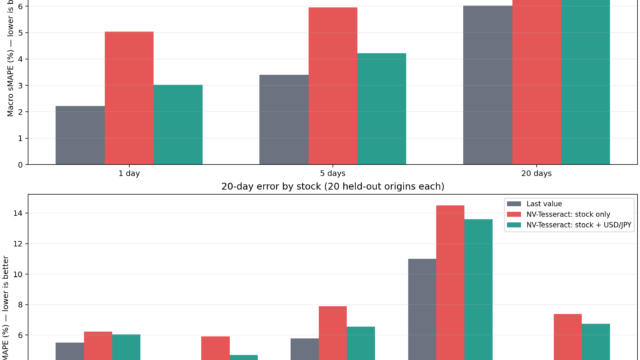
NV-Tesseractは株価を当てられる?ソニー・トヨタなど5銘柄とUSD/JPYで検証

実験機: Core i7-14700F、RTX 5070 Ti 16 GB、RAM 32 GB環境: Windows 11、WSL 2、Ubuntu 26.04 LTS、Python 3.12.14、PyTorch 2.12.1+cu130...
AI・機械学習

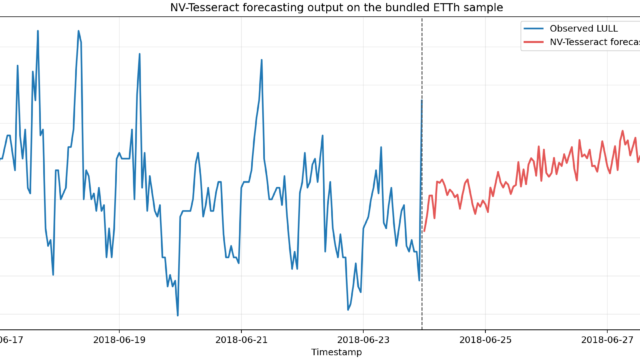
NV-TesseractはWSL2+RTX 5070 Tiで動く?時系列予測と異常検知を実測

実験機: Core i7-14700F、RTX 5070 Ti 16 GB、RAM 32 GB環境: Windows 11、WSL 2、Ubuntu 26.04 LTS、Python 3.12.14、PyTorch 2.12.1+cu130...