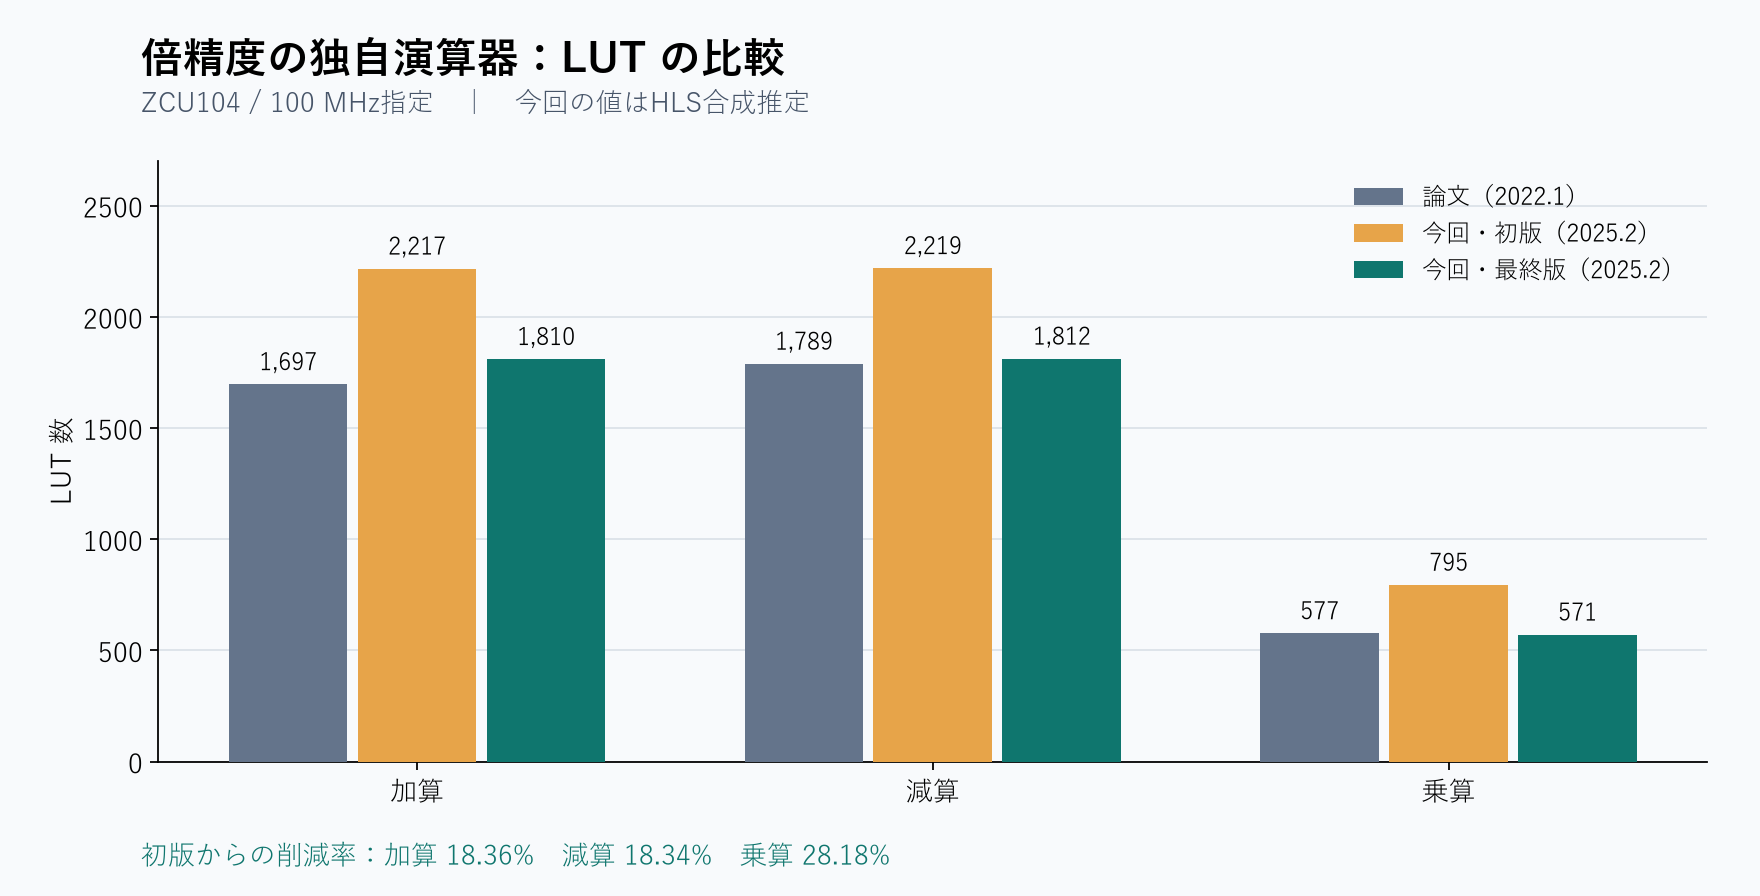
FIT2024 C-003「高位合成を用いて記述したFPGA上の倍精度浮動小数点演算器の論理合成最適化と性能評価」を題材に、倍精度の加算・減算・乗算をVitis HLS 2025.2で再実装しました。ZCU104、100 MHzを共通条件とし、ビット単位の演算記述から合成される回路を整理することで、初版に対してLUTを約18〜28%削減しました。
| 独自演算器 | 論文のLUT | 今回の初版LUT | 今回の最終LUT | 初版からの削減率 | 最終版と論文の差 |
|---|---|---|---|---|---|
| 加算 | 1,697 | 2,217 | 1,810 | 18.36% | +6.66% |
| 減算 | 1,789 | 2,219 | 1,812 | 18.34% | +1.29% |
| 乗算 | 577 | 795 | 571 | 28.18% | −1.04% |
この記事で扱うのは、論文の構成と評価項目を手掛かりにした独立再実装です。原実装のソースコードは入手していません。資源量とFmaxはHLS合成の推定値で、動作確認にはCシミュレーションとRTL協調シミュレーションを用いました。配置配線後の評価とボード上の実測は含みません。
比較条件をそろえる
対象論文は、Vitis HLS 2022.1で倍精度演算器を実装し、標準の浮動小数点演算、BIND_OPによる実装指定、独自演算器を比較しています。さらに、10元連立一次方程式を解くGauss–Jordan消去法に演算器を組み込み、処理全体への効果を評価しています。今回はこの比較軸を2025.2環境で構成しました。
| 項目 | 今回の設定 |
|---|---|
| ツール | AMD Vitis / Vivado 2025.2、Windows |
| 対象デバイス | ZCU104、xczu7ev-ffvc1156-2-e |
| クロック | 10 ns(100 MHz) |
| clock uncertainty | 27%(2.7 ns)を明示 |
| 合成設定 | Vivado IP flow、C++14、unsafe math無効、浮動小数点演算の融合無効 |
| 単体インターフェース | 入力ap_none、制御ap_ctrl_hs |
| 評価数 | 単体演算17条件、Gauss–Jordan 10条件、計27条件 |
標準演算はC++のa + b、a - b、a * bをそのまま合成します。BIND_OP版では加減算を3サイクル、乗算を2サイクルに指定し、fabricやDSPの実装を比較します。独自版はap_uintによる整数のビット演算でbinary64を構成します。比較中にクロックやインターフェースを変えないことが、コード変更の効果を読む前提です。
数値仕様と回路構成
例外値を先に分類する
binary64の符号1 bit、指数11 bit、仮数部52 bitを取り出し、通常値と例外値を分類します。原実装にそろえ、今回もゼロ・NaN・Inf・非正規化数を例外経路で処理する構成としました。
今回の通常演算はround-to-nearest、ties-to-evenです。非正規化入力は符号付きゼロとして扱い、非正規化出力もゼロへ落とします。丸めは正規化した53 bit精度で行ってからアンダーフローを判定します。NaNはcanonical quiet NaNにそろえ、payloadや符号は保存せず、例外フラグは出力しません。この挙動をAMDのFloating-Point Operatorのビット正確Cモデルと照合します。原実装との例外分類の共通性は確認できていますが、返却ビット列や判定の優先順位まで同一であるとは確認していません。
加算で一方がゼロ、他方が有限の正規化数なら他方の値を返します。両方がゼロ扱いなら、両符号が負のときのみ−0を返します。減算は第2オペランドの符号を反転して加算器へ渡します。有限値とゼロの乗算は符号付きゼロを返します。NaNとInfの判定はこれらに先行します。C++の早期returnは結果を選ぶ分岐として記述しており、生成RTLではゼロだけ早く完了する構成にはなっていません。
加減算は桁合わせ・正規化・丸めに分ける
通常値の加減算では、まず絶対値が大きいオペランドを先に置きます。指数差に合わせて小さい方の仮数を右シフトし、同符号なら加算、異符号なら減算します。53 bitの有効仮数にはguard、round、stickyの3 bitを付け、捨てた下位ビットの情報を丸めまで保持します。減算で上位の1が消えた場合は、先頭ゼロ数に応じて左シフトし、指数を補正します。
この構成で削減する対象は、正規化のために重複した選択回路と、丸め後に不要となる幅広いシフトです。演算精度や例外対応は維持します。
HLSが扱いやすい幅と式に整理する
先頭ゼロ検出は幅を伝えたintrinsicを使う
減算結果の正規化に使う先頭ゼロ検出は、56 bitのap_uintが提供するcountLeadingZeros()で記述しました。結果が厳密にゼロになる場合は呼び出し前に処理します。
inline unsigned leading_zeros_56(ap_uint<56> value) {
#pragma HLS INLINE
    return value.countLeadingZeros();
}

if (ext == 0) return detail::pack(false, 0, 0);
const unsigned shift = detail::leading_zeros_56(ext);
ext <<= shift;
exponent -= int(shift);
手書きで全幅のシフトを繰り返す検出器は、検出回路の内部にも正規化に似た選択網を作ります。その後に最終的な可変シフトを置くと、同種の処理が重なります。intrinsicへ置き換え、必要な演算を型の幅とともにHLSへ渡す方針にしました。
絶対値比較を63 bitの比較にまとめる
有限の正規化数では、符号を除いたビット列を整数として比較すると、指数、仮数の順による絶対値比較になります。例外を処理した後なら、指数の大小と一致判定、その先の仮数比較を別々に記述する必要がありません。
if (ap_uint<63>(a.range(62, 0)) <
    ap_uint<63>(b.range(62, 0))) {
    // 指数・仮数・符号を交換し、大きい絶対値を先に置く
}
また、53 bitの保持仮数に丸めの1を加えて桁上がりする場合、結果はちょうど2の53乗です。下位52 bitはすべてゼロなので、仮数を条件付きで右シフトしてから出力する必要はありません。指数だけを増やし、下位52 bitをそのまま仮数部へ渡せます。先頭ゼロ検出、一括比較、この丸め処理を組み合わせた版を採用しました。
乗算は106 bitの正確な積から直接丸める
乗算はhidden bitを含む53 bit同士の積を106 bitで保持します。積の最上位bitによって正規化位置は2通りに限られるため、必要な53 bitとguard、stickyを直接抽出できます。積全体をシフトして汎用の丸め関数へ渡す構成を避け、乗算に必要な選択だけを残しました。
const ap_uint<106> product = sig_a * sig_b;
const bool high = product[105];
const ap_uint<53> retained = high
    ? ap_uint<53>(product.range(105, 53))
    : ap_uint<53>(product.range(104, 52));
const bool guard = high ? product[52] : product[51];
const bool sticky = (product.range(50, 0) != 0)
                 || (high && product[51]);
const bool increment = guard && (sticky || retained[0]);
const ap_uint<54> rounded = ap_uint<54>(retained)
+ ap_uint<1>(increment);指数も汎用のintから符号付き13 bitへ限定しました。有限の入力指数和は最大4,092で、バイアス補正と丸めによる更新を含めてもこの幅で表現できます。
ap_int<13> exponent = ap_uint<12>(exp_a)
                    + ap_uint<12>(exp_b);
exponent -= ap_int<13>(1023);
const ap_uint<1> advance = high || rounded[53];
exponent += advance;
ここで、正規化位置を1 bit上げる条件highと、丸めによる桁上がりrounded[53]は同時には発生しません。53 bit整数の最大積でも、highが立つ側の保持仮数は2の53乗−2以下で、丸めの1を加えても桁上がりしないためです。指数を2段階で更新せず、ORした1 bitで更新できます。106 bit積と丸めに必要な情報を保ったまま、周辺回路を削る変更です。
算術モデルと生成RTLの両方を検証する
検証は算術のビット一致と、HLSが生成したRTLの動作に分けました。CPU参照だけでは非正規化数周辺の丸め仕様を取り違えるため、AMD付属の公式Cモデルを主要な照合先にしています。
| 検証 | 比較件数・対象 | 結果 |
|---|---|---|
| CPU参照 | 63,072件 | 成功 |
| AMDモデル・通常試験 | 63,072件 | 成功 |
| AMDモデル・境界試験 | 85,920件 | 成功 |
| AMDモデル・丸め試験 | 32,928件 | 成功 |
| Cシミュレーション・合成 | 全27条件 | 成功 |
| RTL協調シミュレーション | 独自加減乗算、Gauss–Jordanの標準・独自・inline版の6条件 | 成功 |
算術比較は合計244,992件です。丸め試験にはhalfwayの偶奇、桁合わせ、近接した値の減算、乗算のstickyと桁上がりを含めました。単体演算器のRTL検証はそれぞれ1,168回の呼び出しを行い、ゼロや特殊値を含む結果を照合しています。有限値、Inf、符号付きゼロはビット単位で比較し、NaNはpayloadや符号を一致条件にしません。これは試験集合での一致であり、全入力に対する形式的証明ではありません。
最終版の資源量とレイテンシ
| 独自演算器 | FF 論文→今回 |
DSP 論文→今回 |
推定Fmax[MHz] 論文→今回 |
|---|---|---|---|
| 加算 | 347→206 | 0→0 | 137.58→144.28 |
| 減算 | 460→206 | 0→0 | 137.17→144.28 |
| 乗算 | 123→80 | 8→9 | 142.63→149.16 |
LUTの論文値との差は減算で+1.29%、乗算で−1.04%、加算で+6.66%となりました。乗算のDSPは論文より1個多い9個です。一方、標準IP版のDSP・FF・LUTは、加減算が3・450・813、乗算が11・304・234となり、論文値と一致しました。独自版に残る差を、ツール更新だけで説明することはできません。
単体のサイクル数は開始サイクルを含めて比較する
HLSのlatency 0は、開始したサイクル内で処理が完了することを表します。この記事では、開始サイクルC0を含め、完了サイクルCnまでをn+1個のサイクル枠として数えます。例えば、latency 0なら1サイクル内、latency 1ならC0・C1の2サイクル枠です。今回の非パイプライン単体topは、この比較用の数え方とHLSレポートの生値を分けて記載します。AMDのLatency定義にも、latency 0で同一サイクル内の処理を指定する例があります。
| 演算器 | 論文 サイクル数 |
初版 HLS値→比較用 |
最終版 HLS値→比較用 |
最終版 受付間隔 |
|---|---|---|---|---|
| 標準加算・減算・乗算 | 5 | 4→5 | 4→5 | 5 |
| 独自加算 | 3 | 2→3 | 1→2 | 2 |
| 独自減算 | 3 | 2→3 | 1→2 | 2 |
| 独自乗算 | 2 | 1→2 | 1→2 | 2 |
この数え方では、標準IP版と初版の独自加減乗算はすべて論文値に一致します。最終版は独自加減算・乗算とも2サイクルとなり、論文に対して乗算は同じ、加減算は1サイクル少ない結果です。最終版の独自演算器は、RTL協調シミュレーションでもHLS生値のtop latency 1、interval 2を確認しました。入力は2クロック間隔で、II=1(毎クロック受付)は未達です。
生成RTLを確認すると、標準IP版は開始を含む5状態、最終版の独自演算器は2状態で、上の数え方と整合します。ただし、原論文本文には開始・終了サイクルの数え方の明記がないため、表は開始サイクルを含める比較規約による整理です。これは制御ステップの数え方で、HLSのLatency (absolute)欄の経過時間へ1周期を加算する補正ではありません。また、BIND_OPのlatency指定は演算器内部への制約なので、全条件へ機械的に1を加えることはしません。
Gauss–Jordan消去法に組み込む
処理全体は10×11の拡大係数行列を用い、部分ピボット選択、行交換、ピボット行の正規化、他の行からの消去で構成しました。各ピボットで標準除算を1回使って逆数を求め、11列への乗算で行を正規化します。その後の消去に含まれる乗算と減算を、標準版または独自版へ置き換えます。
全条件で外部ap_memoryインターフェースと非パイプラインのループを共通にし、関数境界を残す版とinline版を比較しました。部分ピボット、逆数を介した正規化、メモリ構成、各pragmaは今回の再構成上の仮定です。原論文の詳細実装や評価行列とは同一と確認できていません。
| 今回の構成 | RTLでの処理サイクル | 100 MHz換算 | DSP | FF | LUT |
|---|---|---|---|---|---|
| 標準演算 | 12,880 | 128.8 μs | 14 | 1,500 | 2,502 |
| 独自乗算・減算、関数境界あり | 8,700 | 87.0 μs | 9 | 1,227 | 3,870 |
| 独自乗算・減算、inline | 6,620 | 66.2 μs | 9 | 1,111 | 4,273 |
同じ4系の非特異な連立方程式を用いたRTL検証では、inline版は標準版の約1.95倍(12,880÷6,620)となりました。既知解、CPU参照解、相対残差、消去後の係数行列が単位行列となることを確認しています。時間は100 MHzで動かした場合の換算値です。BRAM推定は各版とも0ですが、外部メモリの実体は集計に含まれません。
論文の標準版14,138サイクル、独自演算器inline版8,638サイクルによる約1.63倍とは、別の再構成で得た結果です。ここから評価できるのは、今回の共通アルゴリズム内での置換効果です。inlineによって関数境界を越えて処理を組み合わせられる一方、LUTは3,870から4,273へ増えました。処理時間と資源量の両方を見て構成を選ぶ必要があります。
再実行する手順
検証ソースと評価結果(GitHub)に、今回の独立再実装、テスト、実行スクリプト、集計結果、最適化候補を公開しています。リポジトリのREADMEに環境設定と再実行手順を記載しました。AMDのヘッダ・ライブラリと原論文PDFは含めていません。収録レポートのlatency列はHLSの生値で、本文の開始を含むサイクル数とは区別します。
検証用の構成では、src/fp64.hppにビット演算、src/tops.cppに比較対象、tests/に検証、scripts/に実行・集計処理を置きました。プロジェクトのルートから次の順で実行します。Python 3とVitis / Vivado 2025.2が必要です。
python scripts/check_arithmetic.py
python scripts/run_hls.py --cases all --stages csim synth --jobs 3 --resume
python scripts/run_hls.py --cases add_custom sub_custom mul_custom gj_native gj_custom_both gj_inline_both --stages cosim --jobs 2 --resume
python scripts/make_report.py
python scripts/make_optimization_report.pyツールの配置が異なる場合は--tool-rootを指定します。--resumeはソースと設定が一致する成功済み処理を再利用するための指定です。ツールの版を変更した場合は外して再実行します。生成した設定、コマンド、終了値、ソースハッシュを保存し、修正前の結果を最終版の結果と混ぜないようにしました。全条件はresults/summary.json、論文値はresults/paper_reference.json、最適化前後はresults/optimization.jsonへ分けて記録しています。
Q&A:実装と検証で確認した点
Q. CPUのdouble演算を正解にすれば十分ですか?
アンダーフロー境界では十分ではありません。CPUで通常の倍精度演算を行い、出てきた非正規化結果だけを後からゼロにする参照モデルは、AMDモデルと丸めの順番が異なります。今回は正規化した53 bit精度で丸め、その後にFTZを判定します。丸めの桁上がりで最小正規化数へ届く場合もあるため、AMDモデルとの境界試験を設けました。
Q. II=1、つまり毎クロックの入力受付は達成していますか?
今回評価した最終版の単体topでは、II=1は達成していません。独自加算・減算・乗算はいずれも非パイプライン構成で、HLS合成とRTL協調シミュレーションの両方でinterval 2を確認しています。新しい演算を開始できるのは2クロックごとです。標準IP内部の演算器にはII=1の記録がありますが、今回の標準版top全体のintervalは5です。内部演算器の受付能力と外側のtopの受付間隔を分けて評価する必要があります。確認記録はIIの監査結果にまとめています。
Q. HLS latency 0が1サイクル内なら、latencyとintervalはどう区別しますか?
latency 0は同一サイクル内の完了です。開始を含むサイクル枠で数えると1、latency 1なら2となります。一方、intervalは次の入力を受け付ける間隔で、別の指標です。今回の最終単体topはHLS latency 1、開始を含む数は2、intervalも2ですが、この一致は今回の非パイプライン構成での結果です。パイプライン化した回路では、処理が複数サイクルにまたがっていても毎サイクル投入できる場合があります。開始を含む数え方を、intervalへ足し込むことはしません。
Q. 論文に合わせて乗算をDSP 8個にできますか?
53 bit積を26/27 bitの部分積へ分割する候補で8個になりました。ただし964 LUT、162 FFを要し、採用版の571 LUT、80 FFより増えました。DSPだけをそろえると資源全体の改善が小さくなるため、今回はDSP 9個の版を採用しました。
Q. 手書きの回路記述を増やすほど小さくなりますか?
候補比較ではそうなりませんでした。段階的なsticky付きシフトと正規化回路の共有を記述した加算器は、2,111 LUTまで減ったものの437 FFとなり、top latency / intervalも3 / 4へ増えました。手書きの先頭ゼロ検出木では2,021 LUT、321 FFでした。最終版はintrinsicと比較・丸めの整理を組み合わせ、1,810 LUT、206 FF、1 / 2となりました。C++の式が短いかどうかより、HLSが作った選択回路とレジスタを確認します。
Q. WindowsでIP生成が途中で失敗する場合は?
この環境では生成物の深いパスが問題になったため、プロジェクトのルートをsubstで短いドライブへ割り当てて実行しました。例えば空いているRドライブを使うなら、PowerShellでsubst R: (Get-Location).Pathとし、その短いパス側から実行します。ドライブ文字は使用状況に合わせて選びます。
Q. HLSの設定ファイルに書く相対パスの基準は?
生成したコンポーネントや実行時の作業ディレクトリを基準にすると、ソースが見つからないことがあります。実行スクリプトはプロジェクトのルートからソースとテストの絶対パスを生成し、設定ファイルへ書き込みます。記事の実行コマンドは相対パスですが、生成設定の内部は絶対パスです。プロジェクトを移動した後は設定を再生成します。
Q. なぜ論文の資源量と完全には一致しないのですか?
理由は確定していません。独自演算器のビット演算、例外結果の選択、pragma、HLSのスケジューリングや資源共有の判断を原コードと照合できていないためです。例外の種類は共通で、標準IPの資源数は一致しています。したがって単一の要因へ帰属させず、残る差は独立再実装と原論文の合成結果の差として扱います。
参考資料
- 周東裕也、大本裕真、窪田昌史、弘中哲夫「高位合成を用いて記述したFPGA上の倍精度浮動小数点演算器の論理合成最適化と性能評価」、FIT2024 C-003、第1分冊、pp.185–186。IEICE概要、情報処理学会の公式本文PDF。
- AMD、Vitis HLS 2025.2:vitis / v++ / vitis-runのコマンド。
- AMD、2025.2:コマンドラインからのHLSコンポーネント作成。
- AMD、Floating-Point Operator v7.1 Product Guide(PG060)。