重みを丸める実験に続いて、今度はONNX RuntimeでINT8のモデルを作り、CPUで実行しました。ファイルは約72%小さくなりましたが、推論は試した3種類のバッチサイズすべてで遅くなりました。
正解率は86.50%から86.37%へ下がり、答えが変わった画像は1万枚中78枚でした。このCNNでは、容量の削減がそのまま速度向上にはつながりませんでした。
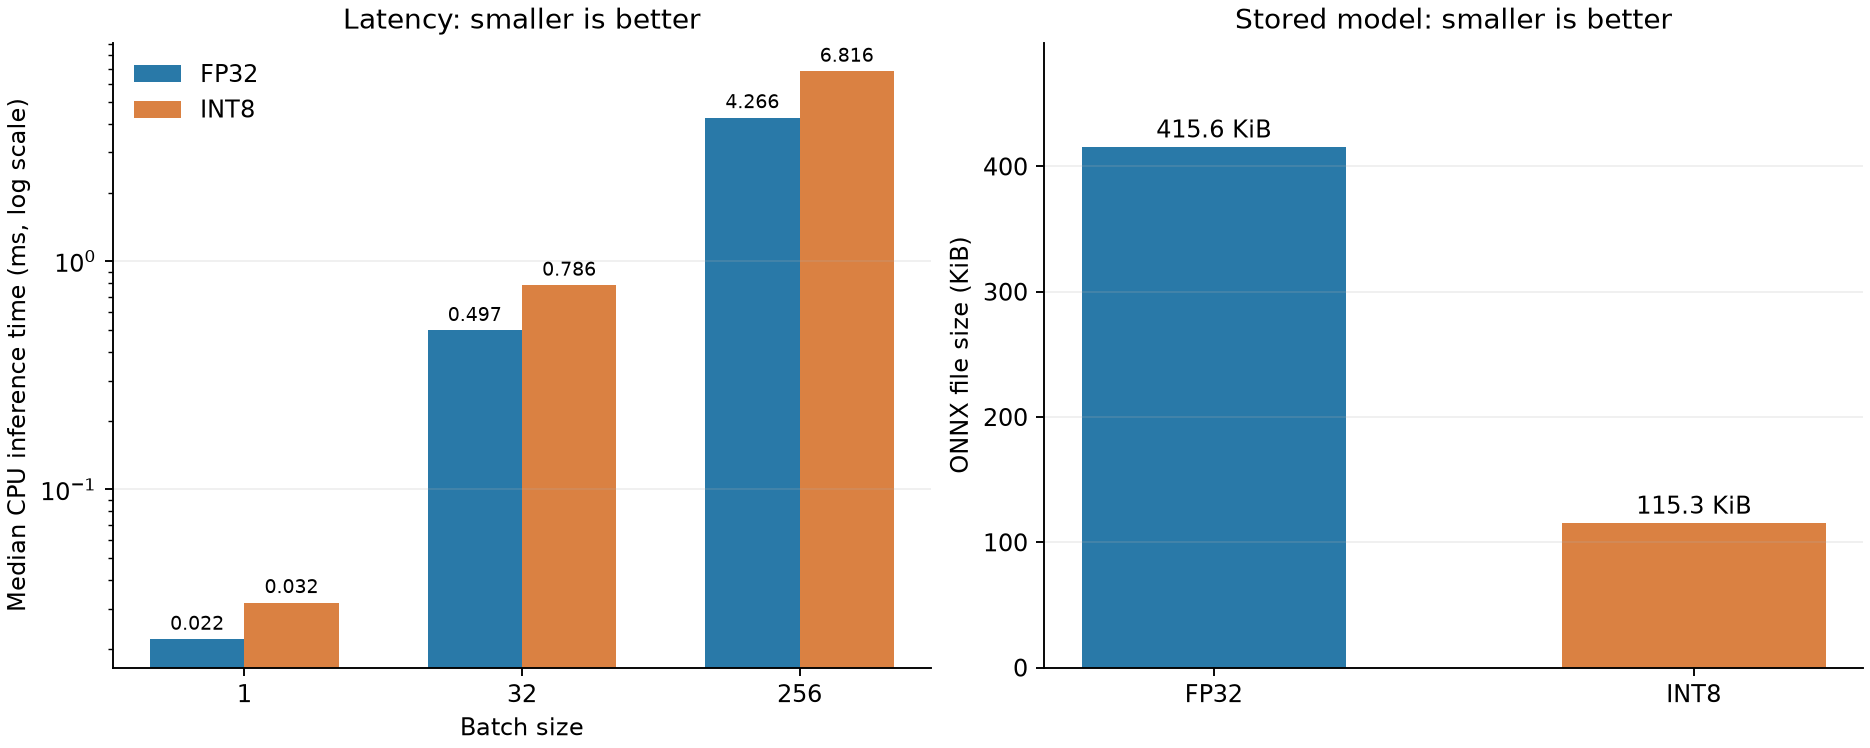
結果:容量は減り、正解率はほぼ維持、速度は低下
| 確認項目 | FP32 | INT8 |
|---|---|---|
| ONNXファイル | 425,562 bytes(415.6 KiB) | 118,105 bytes(115.3 KiB) |
| FashionMNISTテスト1万枚の正解率 | 86.50% | 86.37% |
| FP32から予測が変わった画像 | ― | 78枚 |
| バッチ 1、CPU推論中央値 | 0.0220 ms | 0.0319 ms |
| バッチ 32、CPU推論中央値 | 0.4974 ms | 0.7861 ms |
| バッチ 256、CPU推論中央値 | 4.2658 ms | 6.8155 ms |
推論時間はINT8がFP32の約1.45~1.60倍でした。正解率の差だけを見ると小さく見えますが、予測は78枚変わっています。40枚はFP32で正解・INT8で不正解、27枚は逆、残る11枚は両方不正解ながら予測したクラスが違いました。
この速度はメモリ上にある入力を1回推論する時間です。モデルの読み込み、画像ファイルの読み込み、前処理、表示は含めません。また、以前のPyTorchからONNXへの変換記事とはCPUスレッド設定と測定手順が違うため、そちらの数値を横並びにして倍率を計算しません。
用意するもの
必須なのはPython、PyTorch・torchvision、ONNX、ONNX Runtime、NumPyです。GPUは使いません。こちらの実験はWindows 11上のWSL 2(Ubuntu 26.04 LTS)、Core i7-14700F、Python 3.14.4、PyTorch 2.13.0+cu130、torchvision 0.28.0+cu130、ONNX 1.22.0、ONNX Runtime 1.29.0、NumPy 2.5.2で実施しました。CUDA版PyTorchが入っていますが、実行に指定したのはCPUExecutionProviderだけです。
既にPythonとPyTorchが動くなら、追加のダウンロードはFashionMNISTの圧縮データ約31 MB、GitHubの再現コードとモデル、足りないPythonパッケージです。データと生成物のため、100 MB程度の空き容量を見込んでください。初回ダウンロードを除いた実験本体はこのPCで数十秒でした。既存環境を使うなら管理者権限も再起動も不要です。Python環境を新しく作る場合は、OS側のvenvパッケージ導入に管理者権限が必要になることがあります。
モデルは前のONNX変換実験で学習したFashionMNIST CNNをGitHub上の再現用リポジトリへ含めました。FashionMNISTそのものは含めず、初回実行時にtorchvisionが取得します。追加検証に便利ですが必須ではないものは、生成グラフを閲覧するONNXビューアと、測定中のCPU負荷を確認するタスクマネージャーです。
最短手順:GitHubから取得して実行する
- 再現用リポジトリを
git cloneで取得します。GitがなければGitHubの「Code」→「Download ZIP」から取得しても構いません。取得後はai_lab/フォルダーとその中のmodels/fashion_cnn_dynamic.onnxが必要です。作業場所は以下では~/ai-experimentsと表記します。 - PyTorchとtorchvisionが入ったPython環境で、足りないパッケージを追加します。PyTorch自体がない場合は公式のインストール案内でOSとPythonに合う組み合わせを選びます。
ai_lab/を含むフォルダーで次を実行します。
git clone https://github.com/matrizea/yuyuyuroom-ai-experiments.git ~/ai-experiments
cd ~/ai-experiments
python -m pip install onnx==1.22.0 onnxruntime==1.29.0 numpy==2.5.2 matplotlib
python ai_lab/experiment_onnx_int8_static.py --preprocess
python ai_lab/plot_onnx_int8_static.py
python -m unittest discover -s ai_lab -p test_onnx_int8_static.py -v
pythonが仮想環境を指しているか不明なら、実行前にpython -c 'import sys; print(sys.executable)'で確認します。リポジトリにはCNNのFP32 ONNXファイル、実験コード、図の生成コード、整合性テストを含めました。元モデルのSHA-256は1147ce7c98c4e2e4bfb1eadaaf04cb4b899590d1693a6cbede63a32447be2074です。
正常なら出力のaccuracyに"fp32": 0.865、"int8": 0.8637、"changed_predictions": 78が現れ、最後のテストはRan 5 tests ... OKになります。処理ごとの未丸めの数値はai_lab/results/onnx_int8_static/preprocessed/result.json、推論呼び出し3,000回分はtimings_raw.csvへ保存されます。CPU速度はPCごとに変わるので、同じミリ秒値は期待しないでください。
なぜ校正データが必要なのか
量子化では、浮動小数点数を狭い整数の範囲へ写すための縮尺、つまりscaleを決めます。今回は重みだけでなく、層の途中に流れる値(中間出力)もINT8へ写します。重みはファイル中にありますが、中間出力の値の広がりは実際の入力を通して見ないと分かりません。このため、訓練側から乱数シード 42で選んだ512枚を校正に使いました。評価に使うテスト1万枚は校正に混ぜていません。
方式は静的量子化、MinMax校正、重み・中間出力とも符号付きINT8、重みは出力チャネル別のスケール、ONNXのQDQ形式です。静的量子化では校正時に求めたスケールをモデルに保存します。ONNX Runtimeの公式文書もCNNにはまず静的量子化を勧めています。
コードの中心は次の部分です。quant_pre_processは形状推論など、公式文書が量子化前に推奨する処理です。
quant_pre_process(
    input_model=fp32_path,
    output_model_path=preprocessed_path,
)
quantize_static(
    model_input=preprocessed_path,
    model_output=int8_path,
    calibration_data_reader=train_image_reader,
    quant_format=QuantFormat.QDQ,
    activation_type=QuantType.QInt8,
    weight_type=QuantType.QInt8,
    per_channel=True,
    calibrate_method=CalibrationMethod.MinMax,
    op_types_to_quantize=["Conv", "Gemm", "MatMul"],
)
QDQとはQuantizeLinearとDequantizeLinearをグラフへ挿入する表現です。QDQがあるだけでは「全演算が整数化された」とは言えません。そこで、CPU向けに最適化したグラフも保存して演算子を数えました。元のFP32グラフにはConvが2個、Gemmが2個。INT8版をONNX Runtimeが最適化したグラフにはQLinearConvが2個、QGemmが2個ありました。実際に両モデルをCPUExecutionProviderで読み込み、テスト画像を推論できています。
最適化グラフの保存時には「このCPU向けの変換を含むため別の環境で使うな」という警告が出ました。これは失敗ではありません。持ち運ぶのは生成された通常の量子化モデルai_lab/models/fashion_cnn_preprocessed_static_int8_qdq.onnxで、*_optimized.onnxは今回の確認用です。
速度の測り方と、遅くなった理由の扱い
FP32とINT8は同じ入力、同じCPU Provider、同じintra_op_num_threads=1、同じORT_ENABLE_ALLで比較しました。バッチは1・32・256。各条件を20回ウォームアップし、5巡×100回の推論を実行。条件の測定順を交互にして、後に測る側だけが常に有利・不利にならないようにしました。表は各500回の中央値です。
最適化後のグラフには整数演算子がありましたが、推論時間は長くなっています。この小さなCNNでは量子化・逆量子化の処理、演算子の実装、CPUの命令、バッチサイズなどが総時間へ効きます。ただし今回は各演算子の時間まで分解していないため、どれが遅さの主因かは断定しません。測ったのはCore i7-14700Fの1スレッド、3種類のバッチサイズです。
初回の量子化前処理なしの実行では、ONNX Runtimeから前処理を勧める警告が出ました。前処理を加えて測り直しても、正解率と予測変更枚数は同じで、3種類のバッチすべてでINT8が遅いという結論も変わりませんでした。両方の実行記録を残し、記事の数表は前処理ありの結果を使っています。
うまく動かないとき
ModuleNotFoundError: No module named 'torch':システムのPythonで実行している可能性があります。python -c 'import sys; print(sys.executable)'とpython -c 'import torch, torchvision'を確認し、同じ環境へ依存関係を入れます。WSLとWindowsのPythonは別環境です。fashion_cnn_dynamic.onnxがない:取得したリポジトリのai_lab/models/を含むディレクトリー構造が崩れています。リポジトリ全体を取得し直します。- FashionMNISTの取得で止まる:初回はネット接続が必要です。途中で失敗した場合は通信を確認して再実行します。学習データを勝手にテスト側へ置き換えて校正を進めないでください。
QLinearConvなどを実行できない:使用しているONNX Runtimeの版と実行Providerを確認します。この記事の結果は1.29.0のCPU Providerです。モデルが読めること、テストが通ること、最適化グラフを確認することを別々に試します。
このCPUでは容量を減らす効果が大きかった
モデルファイルは約72%小さくなり、正解率の低下は0.13ポイントでした。ただ、予測が変わった78枚には、正解から不正解になった画像も、その逆もあります。
今回の1スレッドCPU推論では、速度を目的にINT8へ替える利点はありませんでした。複数スレッドや別のモデル、GPU・FPGAでの性能は測っていません。容量を優先する用途でも、使う入力でどの答えが変わるかは確認が要ります。
