PyTorch 2.13.0+cu130
CPU: Core i7-14700F / GPU: RTX 5070 Ti 16 GB
Digitsの小さなネットワークではGPUのほうが遅かったので、FashionMNISTのCNNでも試しました。28×28の衣服画像6万枚を、約10.6万パラメータのモデルで3エポック学習します。
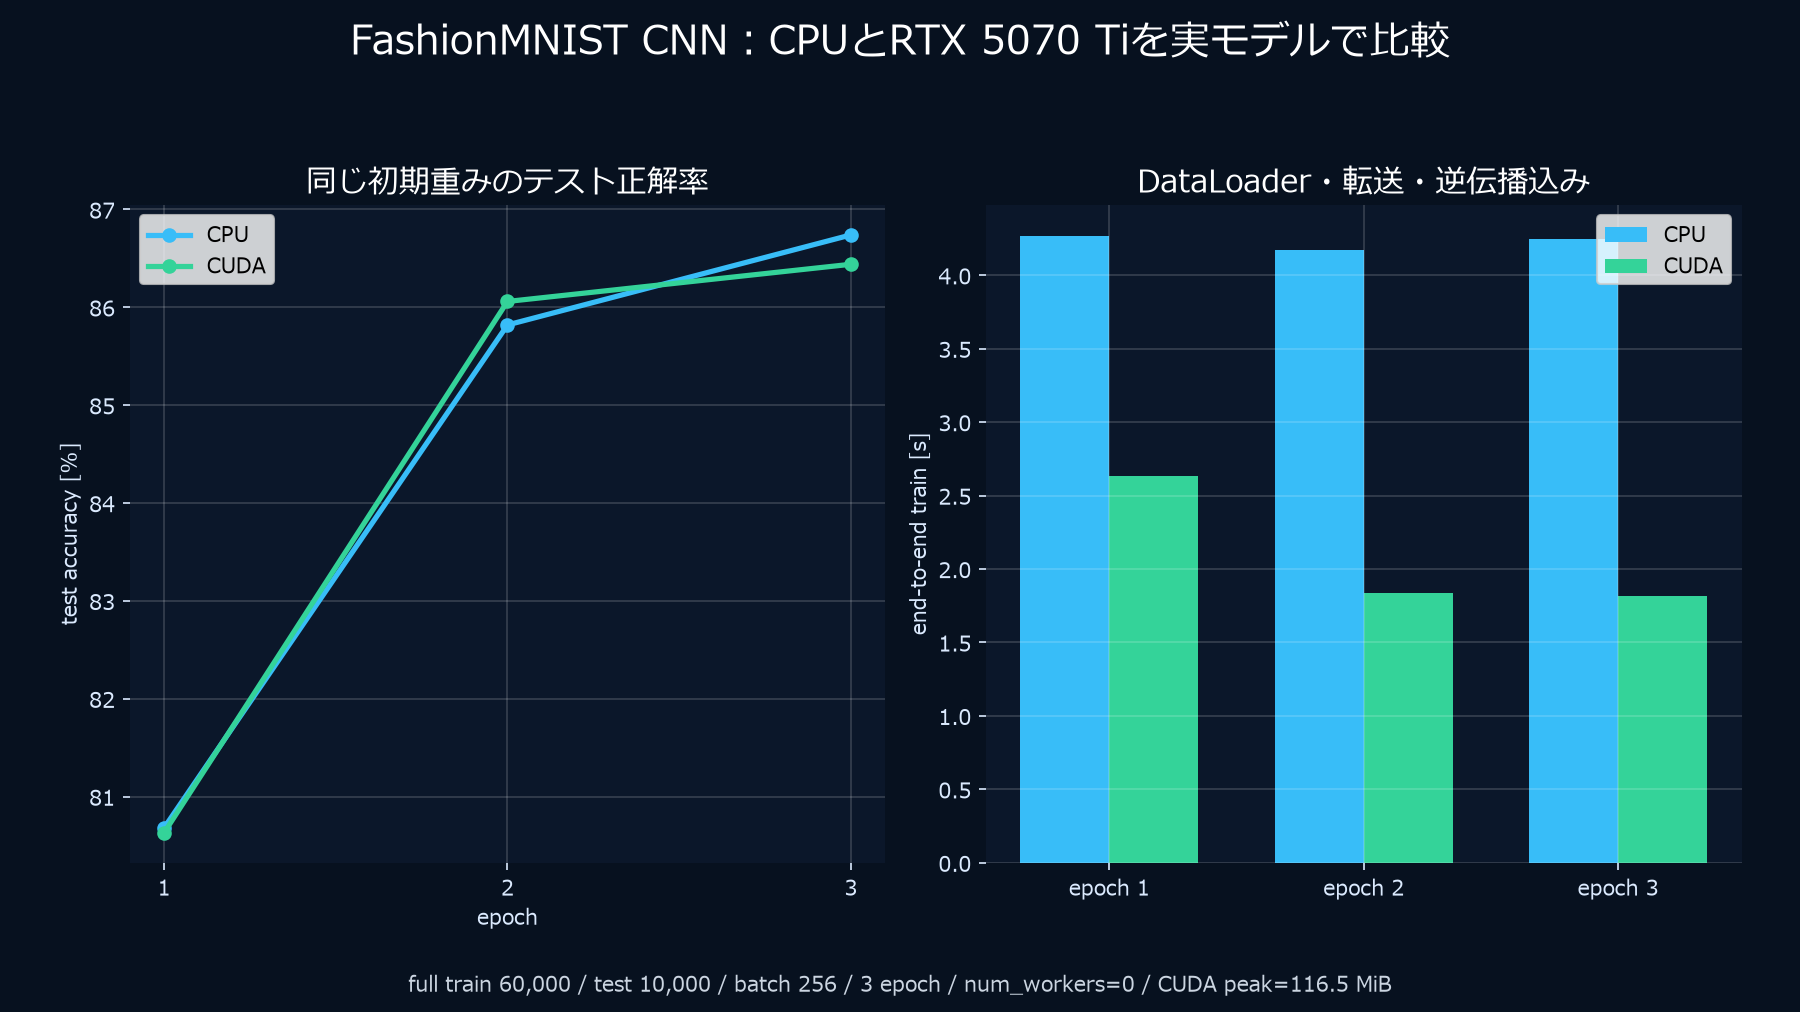
今度はCPUが12.68秒、RTX 5070 Tiが6.29秒で、GPUが約2倍速くなりました。画像を読み出してGPUへ送り、重みを更新するまでを含めた時間です。
GPUが逆転した
- CPU 3エポック合計:12.68秒
- CUDA 3エポック合計:6.29秒
- 処理全体でGPUが約2.02倍高速
- 温間エポック 3:CPU 4.24秒、CUDA 1.82秒(約2.34倍)
- 最終テスト精度:CPU 86.74%、CUDA 86.44%
- CUDAのピークPyTorch割当:116.5 MiB
- CPU:約14,139 images/s、CUDA:約33,038 images/s(エポック 3)
- pytest:出力配列の形とパラメータ数の1件合格
小さい全結合NNではCPUが勝ち、FashionMNIST CNNではGPUが逆転しました。ただしRTX 5070 Tiの性能を使い切ったとは言えません。バッチ 256、num_workers=0、約10万パラメータでは、まだデータ供給や固定費の割合が大きいからです。
FashionMNISTとは
FashionMNISTは28×28グレースケールの衣類画像を10クラスへ分類するデータセットです。
| ラベル | クラス |
|---|---|
| 0 | T-shirt/top |
| 1 | Trouser |
| 2 | Pullover |
| 3 | Dress |
| 4 | Coat |
| 5 | Sandal |
| 6 | Shirt |
| 7 | Sneaker |
| 8 | Bag |
| 9 | Ankle boot |
学習60,000枚、テスト10,000枚です。Digitsの8×8画像より大きく、T-shirt、Shirt、Pullover、Coatのように形が似たクラスがあります。
transform = transforms.ToTensor()

train_set = datasets.FashionMNIST(
    data_dir, train=True, download=True, transform=transform
)
test_set = datasets.FashionMNIST(
    data_dir, train=False, download=True, transform=transform
)
ToTensor()により画素を0~1のfloat Tensorへ変換しました。今回は平均・標準偏差による正規化やデータ拡張を使っていません。CPU/GPU速度比較の条件を単純にし、精度を最大化する実験とは分けています。
CNNが画像の空間構造を使う仕組み
Digitsの全結合NNでは画像を1列に並べ、各画素へ独立した重みを持たせました。CNNの畳み込み層は小さなカーネルを画像上で移動し、同じ重みを位置ごとに共有します。
今回の構造です。
input: 1 × 28 × 28
  ↓ Conv 3×3, 1→16 + ReLU
16 × 28 × 28
  ↓ MaxPool 2×2
16 × 14 × 14
  ↓ Conv 3×3, 16→32 + ReLU
32 × 14 × 14
  ↓ MaxPool 2×2
32 × 7 × 7
  ↓ Flatten
1568
  ↓ Linear 1568→64 + ReLU
  ↓ Linear 64→10
logits
PyTorchコードです。
class SmallCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 16, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(16, 32, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(32 * 7 * 7, 64),
            nn.ReLU(),
            nn.Linear(64, 10),
        )
自動テストでは(4,1,28,28)を入力し、出力が(4,10)、全パラメータ数が105,866であることを確認しました。
. [100%]
1 passed in 3.45s
CPUとGPUで何を揃えたか
| 項目 | 条件 |
|---|---|
| 初期重み | 同じstate_dictをコピー |
| 並べ替え | 同じgenerator 乱数シード 42 |
| バッチサイズ | 256 |
| エポック | 3 |
| 最適化器 | Adam、lr 1e-3 |
| 損失 | CrossEntropyLoss |
| num_workers | 0 |
| CPU pin_memory | False |
| CUDA pin_memory | True |
CPU用モデルを先に初期化してstate_dictを保存し、CPU/CUDAの両モデルへ読み込みました。
torch.manual_seed(42)
base_model = SmallCNN()
initial_state = copy.deepcopy(base_model.state_dict())

model = SmallCNN().to(device)
model.load_state_dict(initial_state)
同じ条件を揃えても、CPUとGPUで全エポックの精度が完全一致するとは限りません。並列演算の順序、浮動小数点の丸め、バックエンド実装が違うため、小さな数値差が最適化器更新を通じて蓄積します。
何を時間に含めたか
各エポックの時計は次を含みます。
- DataLoaderからバッチを取り出す
- Tensorをデバイスへ送る
- 順伝播
- 損失計算
- 逆伝播
- Adamによるパラメータ更新
テスト評価はエポック時間から除外しました。
torch.cuda.synchronize()
started = time.perf_counter()

for images, labels in train_loader:
    images = images.to(device, non_blocking=device == "cuda")
    labels = labels.to(device, non_blocking=device == "cuda")
    optimizer.zero_grad(set_to_none=True)
    logits = model(images)
    loss = loss_function(logits, labels)
    loss.backward()
    optimizer.step()

torch.cuda.synchronize()
epoch_seconds = time.perf_counter() - started
CUDAの非同期実行を考慮し、計測前後で同期しています。転送を含めたのは、人間がこの学習コードを実行したときの待ち時間に近い比較にするためです。
エポックごとの実測
| エポック | CPU時間 | CUDA時間 | CPU テスト | CUDA テスト |
|---|---|---|---|---|
| 1 | 4.265 s | 2.633 s | 80.68% | 80.63% |
| 2 | 4.173 s | 1.840 s | 85.82% | 86.06% |
| 3 | 4.244 s | 1.816 s | 86.74% | 86.44% |
CUDAのエポック 1だけ2.63秒と長く、エポック 2以降は約1.82秒です。初回にはカーネル選択、ライブラリ初期化、キャッシュなどのコールドスタート要素が含まれます。
合計6.29秒には初回の起動時間も含まれるため、温間エポックの値も併記します。学習全体の待ち時間と、温まってからの1エポックは別に見たほうが分かりやすいです。
小さいNNではCPU、CNNではGPUが勝った
これまでの同PC実測を並べます。
| 処理 | CPU | GPU | 勝者 |
|---|---|---|---|
| 4,810 パラメータのDigits NN学習 | 0.251 s | 1.098 s | CPU 約4.38倍 |
| FashionMNIST CNN 3エポック | 12.68 s | 6.29 s | GPU 約2.02倍 |
| 4096² FP32行列積 | 177.845 ms | 4.262 ms | GPU 約41.7倍 |
仕事が大きくなるほどGPUの並列演算を活かしやすくなっています。ただし3つは計測範囲が違います。行列積は配列生成・転送を除外、Digits NNはデータ事前配置、FashionMNISTはDataLoaderと転送込みです。倍率だけを直接比較せず、損益分岐の傾向として読みます。
ピークVRAM 116.5 MiBの意味
torch.cuda.max_memory_allocated()で、PyTorchがTensorへ割り当てたピークを測りました。
peak CUDA allocated: 116.5 MiB
これはnvidia-smiのプロセスVRAM表示とは一致しません。CUDA コンテキスト、ライブラリ workspace、allocatorが予約した未使用領域など、測る対象が違うからです。本記事の116.5 MiBはPyTorchの「allocated」であり、GPU全体の消費量ではありません。
16 GB GPUに対して非常に小さいため、バッチを増やす余地があります。バッチサイズごとの速度・VRAM・OOMを測れば、余ったVRAMが処理速度へ寄与する範囲を切り分けられます。
精度差を性能差と断定しない
最終精度はCPU 86.74%、CUDA 86.44%で0.30ポイント差でした。しかし1回の学習だけで「CPUの方が高精度」とは言えません。
- 初期重みと並べ替え乱数シードは同じ
- バックエンドの数値演算順は異なる
- 学習は確率的で、小さな丸め差が蓄積する
- 複数乱数シードを回していない
精度の差を比べるには、複数乱数シードで学習して平均と分散を見る必要があります。ここでは1回ずつの実行なので、速度とVRAMを中心に比べます。同じ初期重みと並べ替え乱数シードでも、CPUとCUDAでは精度に差が出ました。
混同行列からCNNの弱点を見る
CPU版の最終混同行列では、クラス6のShirtが1,000枚中468枚しか正解していませんでした。
- Shirt→Pullover:170枚
- Shirt→Coat:145枚
- Shirt→T-shirt/top:131枚
一方、Bagは973/1,000、Sneakerは969/1,000、Trouserは963/1,000正解です。全体正解率86.74%だけを見ると、Shirtの弱さを見落とします。
次に改善するなら、学習エポックを増やす前に誤分類画像を観察し、画像拡張、正規化、モデル容量、クラス別指標のどれを試すか仮説を立てます。
num_workers=0を明記する理由
DataLoaderのワーカー数を増やすと、CPUでのデータ準備を学習と並列化できます。しかしWindows/WSL、CPU core数、ストレージ、変換処理によって最適値が変わります。
ここではnum_workers=0に固定しました。GPUが入力を待っていた可能性は残るため、ワーカーを増やした場合の速度はこの結果からは分かりません。
データの渡し方にも余地がある
今回はnum_workers=0、同じ初期値とバッチサイズで比べました。GPU側の6.29秒にはデータ供給の待ちも含むので、RTX 5070 Tiの計算能力を使い切った結果ではありません。CPUとGPUの正解率にあった0.3ポイントの差も、1回ずつの学習では優劣を判断できません。
DataLoaderの並列数とバッチサイズを変えた測定では、この待ち時間やメモリ使用量が変わっています。小さなモデルでも、計算量だけでなく入力の渡し方が効いていました。
実行環境と記録ファイル
- 実験:
work/ai_lab/experiment_fashion_cnn.py - 自動テスト:
work/ai_lab/test_fashion_cnn.py - 生データ:
work/ai_lab/results/fashion_cnn_cpu_gpu.json - データ保存:
/opt/ai-lab/data/FashionMNIST - 図:
outputs/fashion-cnn-cpu-gpu.png - PyTorch 2.13.0+cu130、torchvision 0.28.0+cu130
- GPU:RTX 5070 Ti、CUDA ランタイム 13.0
参考:
