PyTorch 2.13.0+cu130
CPU: Core i7-14700F / GPU: RTX 5070 Ti 16 GB
NumPyで書いた2層ネットワークをPyTorchへ移しました。重みをそのままコピーして比べると、手書きの逆伝播と自動微分の勾配差は最大1.11×10⁻¹⁶でした。
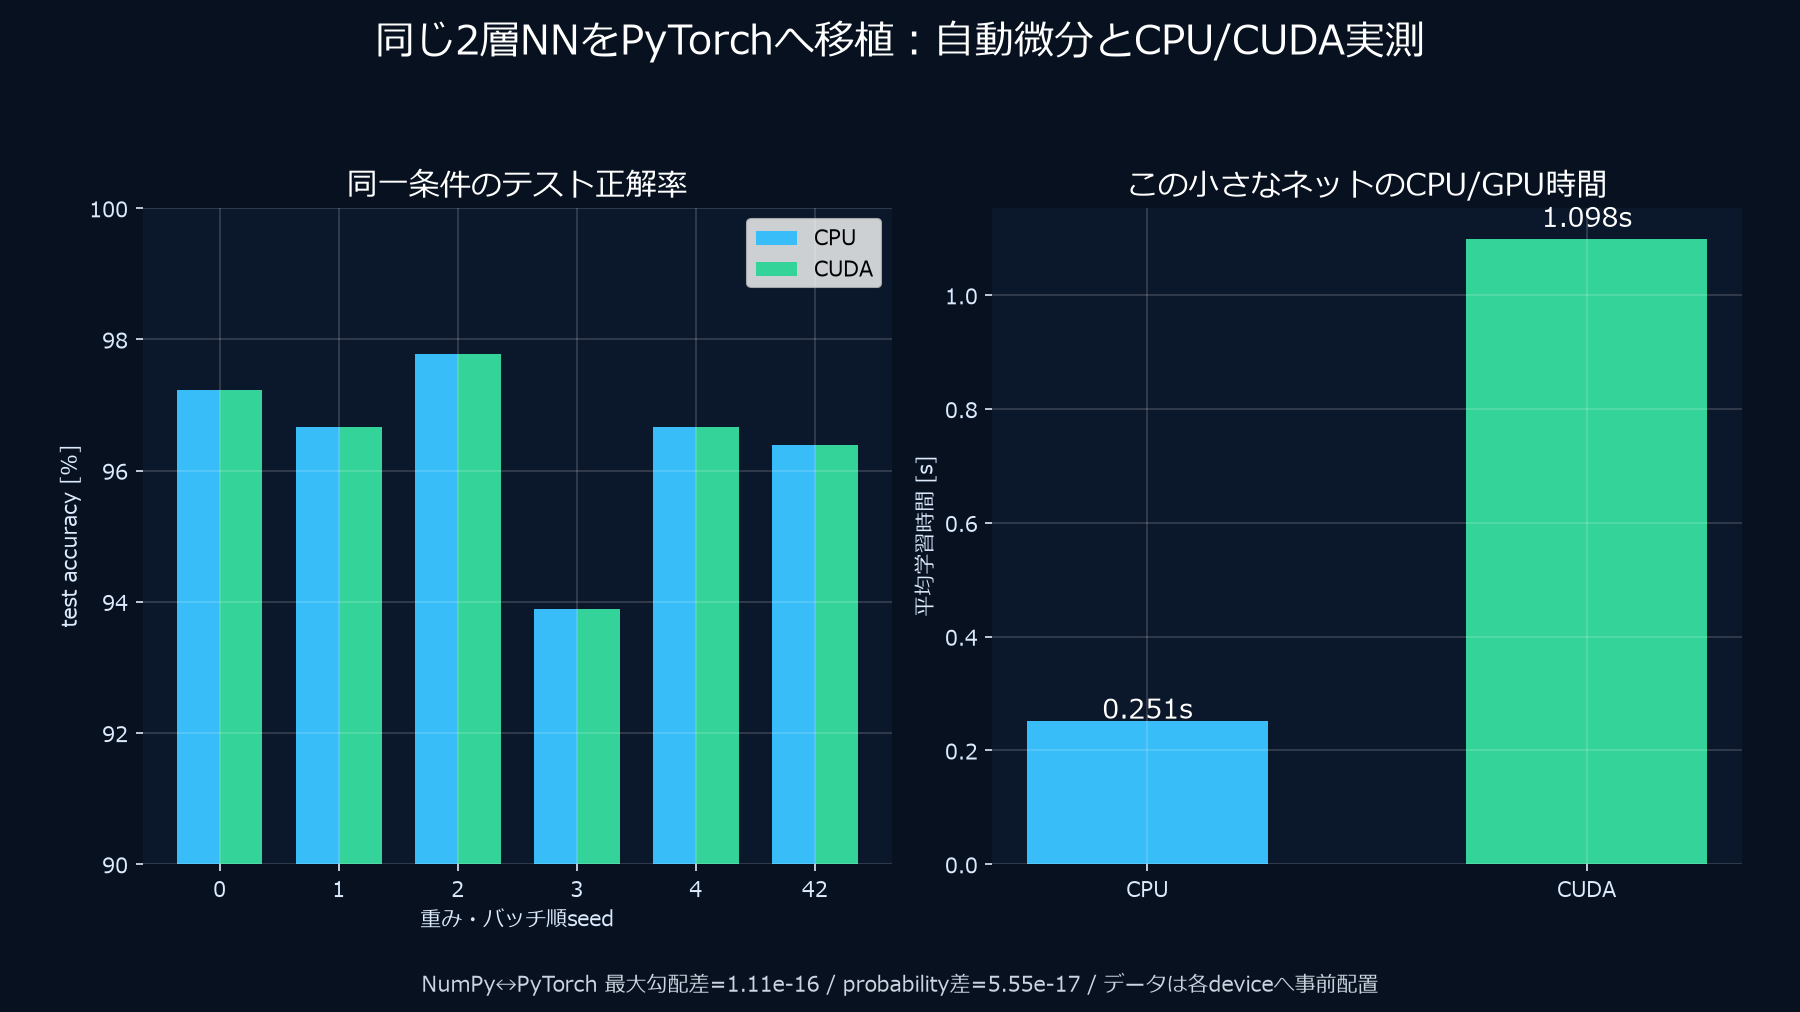
同じモデルをCPUとRTX 5070 Tiで学習させると、今回はCPUのほうが約4.38倍速い結果です。4,810パラメータしかない小さな計算なので、GPUへ処理を渡す手間が目立ちました。
CPUとGPUまで比べた結果
- NumPyとPyTorchの予測確率の最大差:5.55×10⁻¹⁷
- 損失の絶対差:2.39×10⁻¹¹
- 4パラメータ群の最大勾配差:1.11×10⁻¹⁶
- pytest:1件合格
- CPU/CUDAの6 乱数シード平均正解率:ともに96.44%
- CPU平均学習時間:0.251秒
- CUDA平均学習時間:1.098秒
- この条件ではCUDAがCPUより約4.38倍遅い
- 乱数シード=42の360枚推論:CPU 0.049 ms、CUDA 0.201 ms
GPUは故障していません。4096角行列積では同じPCのGPUがCPUより約41.7倍高速でした。しかし4,810パラメータの小さなネットでは、GPUへ仕事を依頼するオーバーヘッドと同期コストが計算量に勝ちました。
NumPyの各処理をPyTorchへ対応付ける
| NumPy手実装 | PyTorch | 役割 |
|---|---|---|
x @ w1 + b1 |
nn.Linear(64, 64) |
全結合層 |
np.maximum(z, 0) |
nn.ReLU() |
活性化関数 |
| 安定化Softmax+CE | nn.CrossEntropyLoss() |
分類損失 |
手書きd_w1など |
loss.backward() |
自動微分 |
| パラメータ更新式 | torch.optim.SGD |
最適化器 |
| 勾配配列を0へ | optimizer.zero_grad() |
勾配蓄積のリセット |
モデル定義は次です。
model = nn.Sequential(
    nn.Linear(64, 64),
    nn.ReLU(),
    nn.Linear(64, 10),
)
最後にSoftmaxを書いていない点が重要です。CrossEntropyLossは未正規化のlogitsを受け取り、内部でLogSoftmaxと負の対数尤度を安定に組み合わせます。モデル出力へ先にSoftmaxを掛けて渡すと、期待する入力と違ってしまいます。
自動微分は何を記録しているか
PyTorchのTensorは、requires_grad=Trueのパラメータから行われた演算を計算グラフとして追跡します。
optimizer.zero_grad(set_to_none=True)
logits = model(x_batch)
loss = loss_function(logits, y_batch)
loss.backward()
optimizer.step()
zero_grad:前バッチの勾配を消すmodel:順伝播し、演算関係を記録loss:予測と正解からスカラー損失を作るbackward:連鎖律で各パラメータの.gradを計算step:最適化器がパラメータを更新
PyTorchの勾配は標準で加算されます。zero_gradを忘れると複数バッチの勾配が意図せず蓄積します。勾配蓄積を狙う場合もありますが、今回は毎バッチリセットします。
同じ重みをコピーして公平に比較する
「同じ乱数シード」を指定しても、NumPyとPyTorchでは乱数生成器や乱数消費順が違うため、同じ初期重みになるとは限りません。
そこでNumPyモデルの重みを、PyTorchへ直接コピーしました。NumPyのW1は配列の形 (64, 64)でX @ W1に使います。PyTorchのLinear.weightは(out, in)なので転置が必要です。
with torch.no_grad():
    torch_model[0].weight.copy_(torch.from_numpy(numpy_w1.T))
    torch_model[0].bias.copy_(torch.from_numpy(numpy_b1))
    torch_model[2].weight.copy_(torch.from_numpy(numpy_w2.T))
    torch_model[2].bias.copy_(torch.from_numpy(numpy_b2))
torch.no_grad()は、このコピー操作を学習用計算グラフへ記録しないために使います。
順伝播と勾配の等価性を検証する
5サンプルをfloat64で入力し、NumPyとPyTorchへ完全に同じ重みを設定しました。
| 比較対象 | 最大差 |
|---|---|
| 予測確率 | 5.55×10⁻¹⁷ |
| 損失 | 2.39×10⁻¹¹ |
| W1勾配 | 1.11×10⁻¹⁶ |
| b1勾配 | 2.78×10⁻¹⁷ |
| W2勾配 | 5.55×10⁻¹⁷ |
| b2勾配 | 2.08×10⁻¹⁷ |
浮動小数点の丸め程度まで一致しました。前回のNumPy勾配は有限差分とも一致しているので、次の検証鎖になります。
有限差分の数値勾配
        ≒
NumPy手実装の逆伝播
        ≒
PyTorch autograd
pytestでも別入力に対して、確率差1e-12未満、損失差1e-10未満、全勾配差1e-10未満を検査しました。
. [100%]
1 passed in 3.47s
学習条件を揃える
| 条件 | 設定 |
|---|---|
| データ | Digits、画素÷16 |
| 分割 | NumPy版と同じ学習 1,293 / 検証 144 / テスト 360 |
| 構造 | 64→64 ReLU→10 logits |
| 最適化器 | SGD、lr 0.05、momentum 0.9 |
| バッチ | 64 |
| early stopping | 最大240エポック、patience 40 |
| 初期値 | NumPy版の同じ重みをコピー |
| バッチ順 | CPU/CUDA/NumPyで同じ乱数シード順 |
| 試行 | 乱数シード 0,1,2,3,4,42 |
CPUとCUDAでは、学習開始前にデータ全体を各デバイスへ置きました。そのため計測は毎バッチのCPU→GPU転送を含みません。GPUに有利寄りの条件でも、小規模ネットではCPUが速いかを確かめます。
CPUとCUDAで正解率が一致した
6 乱数シードのテスト精度は、表示桁ではCPUとCUDAがすべて一致しました。
| 乱数シード | CPU | CUDA |
|---|---|---|
| 0 | 97.22% | 97.22% |
| 1 | 96.67% | 96.67% |
| 2 | 97.78% | 97.78% |
| 3 | 93.89% | 93.89% |
| 4 | 96.67% | 96.67% |
| 42 | 96.39% | 96.39% |
平均96.44%、標本SD 1.34ポイントでNumPy版とも一致しました。これは同じ初期値とバッチ順を使った結果です。一般にはCPU/GPUの演算順序や非決定的アルゴリズムにより完全一致しない場合があります。
なぜRTX 5070 Tiの方が遅かったか
6試行の平均学習時間はCPU 0.251秒、CUDA 1.098秒でした。
このネットの1バッチで主に行う行列積は、64×64や64×10程度です。GPUは多数の演算を並列処理できますが、仕事をカーネルとして起動し、結果を同期する固定費があります。小さな行列では並列演算の利益より固定費が支配的になります。
また、各エポックでtraining/validation精度を測るため同期が発生します。これは実験の監視として必要ですが、GPUのスループットだけを測るベンチマークではありません。
4096角行列積との違い
以前の4096×4096 FP32行列積では、GPU 4.262 ms、CPU 177.845 msでした。十分に大きな仕事をまとめて渡せばGPUが有利です。
小さい2層NN:CPUが約4.38倍速い
大きな4096²行列積:GPUが約41.7倍速い
「GPUは速い/遅い」という二択ではなく、計算量、バッチサイズ、転送、同期、モデル構造で損益分岐点が決まります。
正しいGPU時間を測るために同期する
CUDA演算は非同期です。Pythonがカーネルを投入した時点で先へ進むため、同期せずに時計を止めると実処理より短く見える場合があります。
torch.cuda.synchronize()
started = time.perf_counter()

# CUDA処理

torch.cuda.synchronize()
elapsed = time.perf_counter() - started
本実験では学習前後と推論前後で同期しました。PyTorch公式のCUDA 意味でも、正確な時間測定には同期またはCUDA Eventが必要と説明されています。
model.train()とmodel.eval()
今回のモデルはLinearとReLUだけなので、両モードで計算内容は変わりません。それでも学習時はmodel.train()、最終評価時はmodel.eval()を明示しました。
DropoutやBatchNormを追加すると、学習モードと評価モードで挙動が変わります。最初から習慣にしておくと、後のCNN実験で評価精度が不安定になる事故を防げます。
推論時には勾配が不要なので次を使います。
model.eval()
with torch.no_grad():
    predictions = model(x_test).argmax(dim=1)
no_grad()により計算グラフを保持せず、余分なメモリと処理を減らします。
NumPy手実装で分かったこと、PyTorchで得たもの
NumPy版では次を直接確認できました。
- Softmaxの数値安定化
- ReLUを通る勾配
- 転置と配列の形
- ミニバッチ平均
- 有限差分による検証
PyTorch版では次が得られます。
- 自動微分で層を変更しやすい
- 最適化器を交換しやすい
- CPU/CUDAを同じコードで切り替えられる
- CNNなど複雑な層へ拡張しやすい
state_dictで重みを保存・復元できる
NumPyの手実装と対応させると、loss.backward()が連鎖律に沿って勾配を計算していることを確認できます。
この大きさならCPUで十分だった
NumPyから移した勾配計算は合っていましたが、この4,810パラメータの学習ではGPUの利点が出ませんでした。学習を繰り返すだけなら、CPUのほうが待ち時間は短く済みます。
計算量を増やしたFashionMNISTのCNNではGPUが速くなっています。今回の時間は小さな2層ネットの結果として見るのがよさそうです。環境構築はWSL 2のPyTorch導入手順にまとめています。
実行環境と記録ファイル
- 実験:
work/ai_lab/experiment_digits_pytorch_nn.py - 自動テスト:
work/ai_lab/test_pytorch_numpy_equivalence.py - 生データ:
work/ai_lab/results/digits_pytorch_nn.json - 図:
outputs/digits-pytorch-nn-cpu-gpu.png - PyTorch 2.13.0+cu130、CUDA ランタイム 13.0
- GPU:NVIDIA GeForce RTX 5070 Ti
参考:
