DataLoaderの並列数を変えると学習が速くなったので、torch.profilerで処理の内訳を見ました。画像に切り抜きと回転を加えた条件では、num_workers=0の学習ループは次の画像群を受け取るところで長く待っていました。
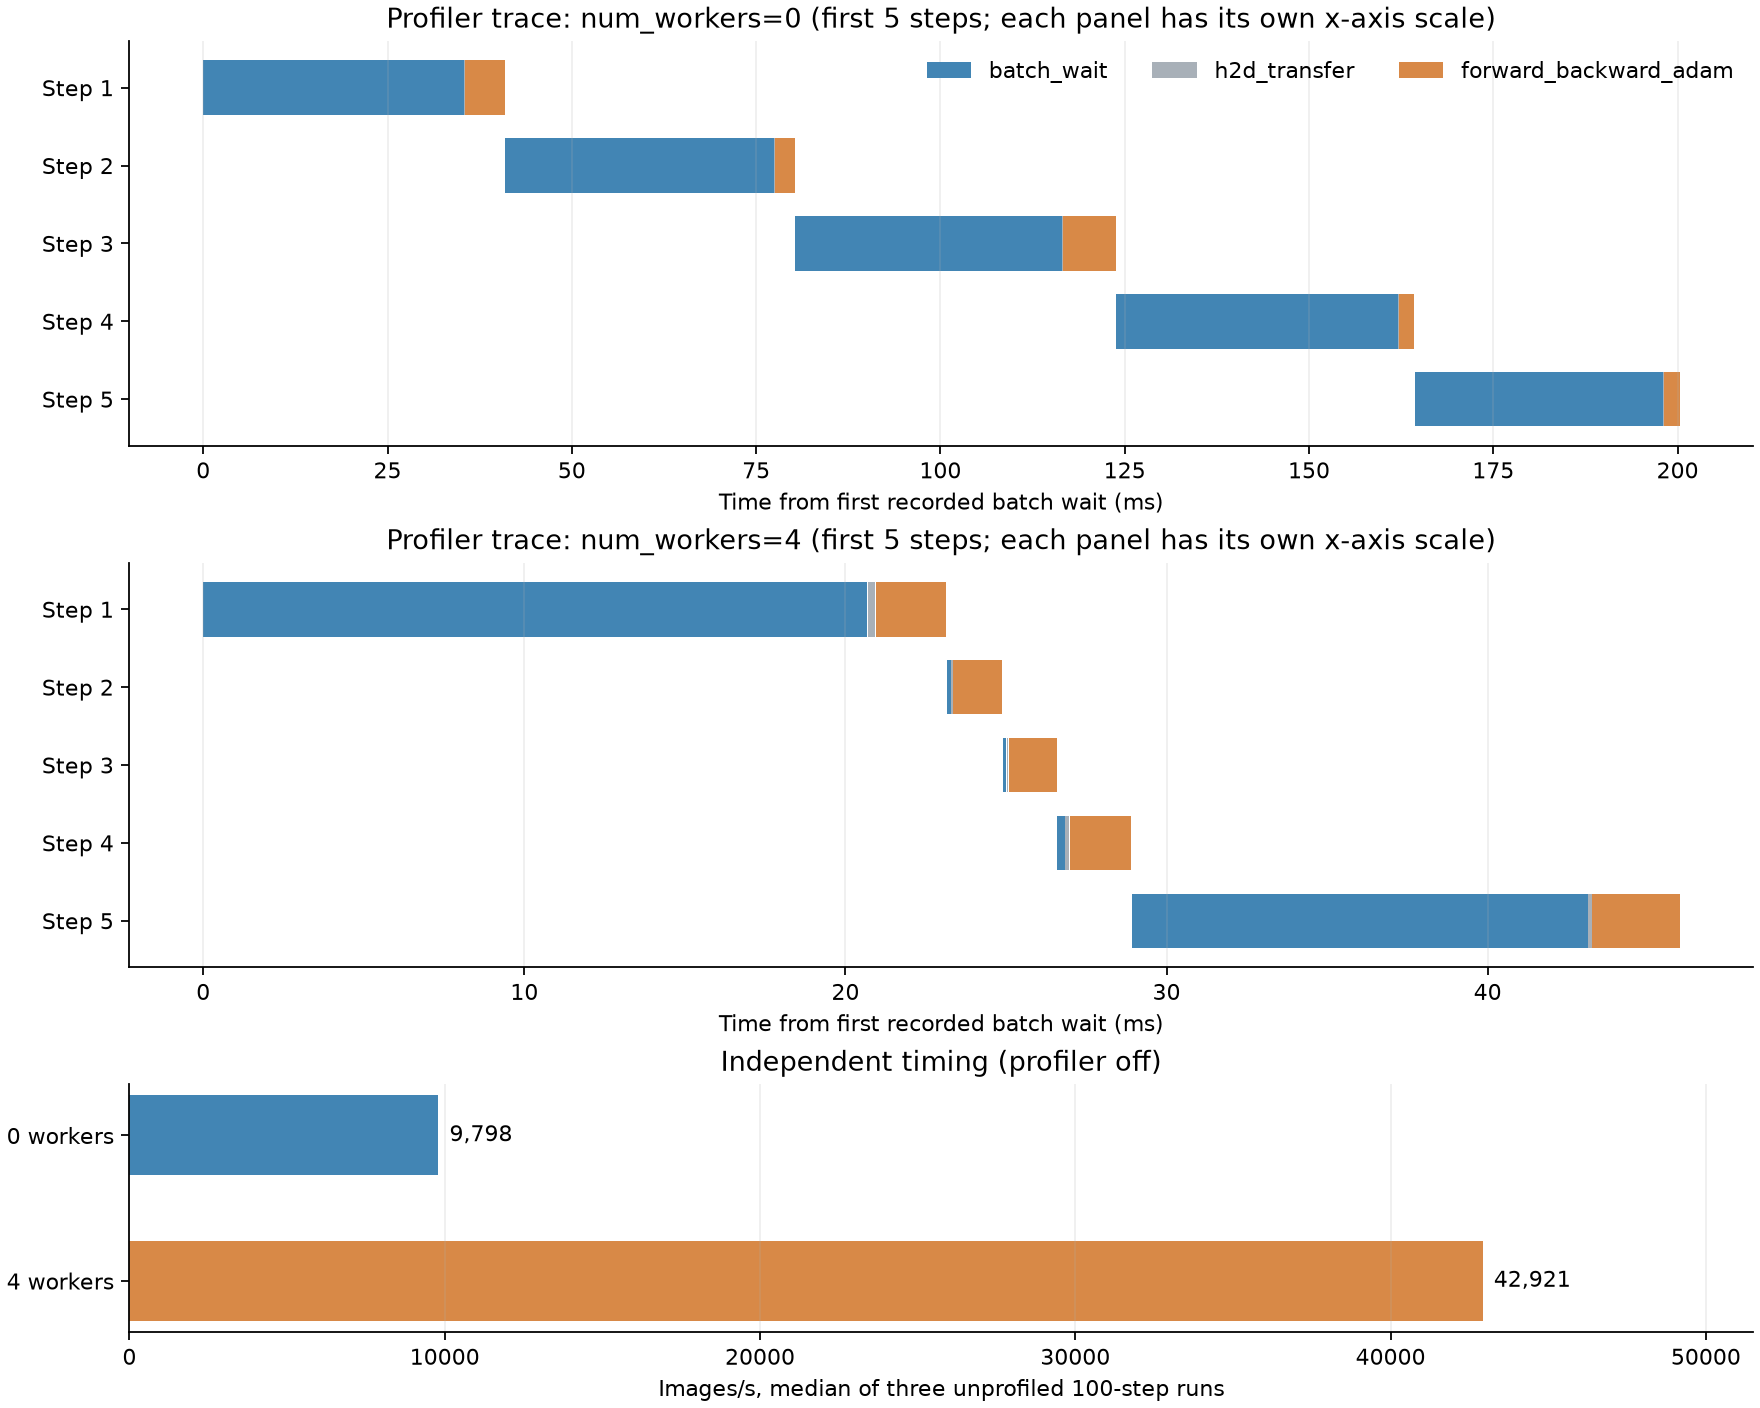
4プロセスで前処理すると、その待ち時間が短くなります。profilerを外して速度を測り直すと、約9,798 images/sから42,921 images/sへ、約4.4倍になりました。並列数ごとの比較に対して、こちらでは何を待っていたのかを追います。
0ワーカーでは、次のバッチを待っていた
| 通常計測・各100ステップを3回 | 0ワーカー | 4ワーカー |
|---|---|---|
| 処理速度の中央値 | 9,798 images/s | 42,921 images/s |
| 100ステップ所要時間の中央値 | 2.613 s | 0.596 s |
next(DataLoader)待ち時間、各回の中央値をさらに中央値 |
23.781 ms | 0.169 ms |
バッチサイズはどちらも256。100ステップで25,600枚を処理します。計測前に40ステップ動かしたので、表にはワーカーの起動時間を含めていません。3回の計測のうち中央だけ実行順を逆にしても、4ワーカーのほうが速い結果は変わりませんでした。
next(DataLoader)は、Pythonの学習ループがバッチを取り出す操作です。4ワーカーなら背後のプロセスが先に画像を変換し、バッチを用意できます。0ワーカーでは学習ループ自身が切り抜き・回転・Tensor変換を進めるため、この呼び出しが長くなります。ただし、この待ち時間はGPU処理と重なり得るので、表の各時間を足して総所要時間とみなしてはいけません。処理速度はCUDAの完了を待ってから測った別の値です。
profilerを使った20ステップでは、batch_waitの中央値は0ワーカーで35.952 ms、4ワーカーで0.116 msでした。通常計測の23.781 msと数値が違うのは、profilerがCPU演算とCUDA活動を記録する負荷を加えるためです。トレースの区間と通常の速度表を混ぜず、「長い青い区間がどこにあるか」を見るために使います。4ワーカーでもまれに待ちが長くなり、profiler上の95パーセンタイルは16.621 msでした。常にゼロ待ちになるわけではありません。
実験条件と準備
環境はWindows 11上のWSL 2(Ubuntu 26.04 LTS)、Core i7-14700F、RTX 5070 Ti 16 GB、PyTorch 2.13.0+cu130、torchvision 0.28.0+cu130です。WSL 2からPyTorchでGPUを使う手順と同じ系統の環境を使いました。CUDAが動くPyTorch環境が必須です。FashionMNISTの初回ダウンロードは圧縮データで約31 MB。0ワーカーの詳細トレースだけで約106 MBになったため、Python環境とは別に300 MB程度の空き容量を確保します。既存のGPU環境なら管理者権限も再起動も不要で、ダウンロードを除いた実験はこのPCで1分程度でした。
比較ではFashionMNISTの訓練データとCNNを共通にし、初期重み、バッチ 256、乱数シード 42、FP32(TF32無効)、pin_memory=Trueも揃えました。画像にはRandomResizedCrop(28, scale=(0.75, 1.0))、RandomRotation(15)、ToTensorを適用します。4ワーカーではpersistent_workers=Trueでプロセスを維持し、prefetch_factor=2で先読みしました。見たいのは正解率の差ではなく、この前処理を入れたときに学習ループがどこで待つかです。
再現手順
再現用リポジトリをgit cloneで取得します。GitがなければGitHubの「Code」→「Download ZIP」も使えます。作業場所を~/ai-experimentsとした場合、~/ai-experiments/ai_lab/にPythonファイルが並ぶ配置です。
git clone https://github.com/matrizea/yuyuyuroom-ai-experiments.git ~/ai-experiments
cd ~/ai-experiments
python -c 'import torch; print(torch.cuda.is_available())'
python -m pip install matplotlib numpy
python ai_lab/experiment_training_profiler.py
python ai_lab/plot_training_profiler.py
python -m unittest discover -s ai_lab -p test_training_profiler.py -v
最初の確認がTrueでなければ、ワーカー数を調べる前にCUDAが実際に動くか確認します。PyTorchとtorchvisionが未導入なら公式の組み合わせ選択を使ってください。ダウンロード時はネット接続が必要です。
実験が終わるとai_lab/results/training_profiler/result.json、全600ステップのtimed_steps_raw.csv、workers_0_トレース.json、workers_4_トレース.json、演算子表ができます。最後のテストはRan 3 tests ... OKです。図はfigures/pytorch-profiler-dataloader-wait.pngに出力します。別のPCでは時間が変わります。まず結果JSONと2本の記録ファイルが生成されることを確認してください。
トレースでは何を囲ったか
PyTorchのrecord_functionで3つの区間へ名前を付け、公式のprofilerでCPUとCUDA活動を記録しました。
with profile(activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA]) as prof:
    for _ in range(20):
        with record_function("batch_wait"):
            batch = next(iterator)
        with record_function("h2d_transfer"):
            images, labels = (x.to("cuda", non_blocking=True) for x in batch)
        with record_function("forward_backward_adam"):
            optimizer.zero_grad(set_to_none=True)
            loss = loss_fn(model(images), labels)
            loss.backward()
            optimizer.step()
        prof.step()
batch_waitはCPU側が次のバッチを要求して戻るまでの時間です。h2d_transferはCPUメモリからGPUメモリへ送る操作、forward_backward_adamは予測・誤差逆伝播・重み更新です。CUDA操作は非同期なので、これらのCPU区間の長さだけをGPUの計算時間と呼びません。トレースにCUDA カーネルイベントも両条件で940個ずつ記録され、GPU計算が行われていることを別に確認しています。
図の上段では、0ワーカーの青いbatch_waitが各ステップの大部分を占めます。4ワーカーでは青い区間が短いステップが増えますが、最初と5番目のステップには待ちが残りました。横軸は段ごとに異なるため、速度差は下の通常計測と表で判断してください。
速度を測るときの落とし穴
profilerが有効なステップの所要時間をそのまま「学習速度」として載せると、観測の負荷を結果に混ぜます。今回、0ワーカーの詳細トレースは約106 MBで、CPU変換の細かな演算まで大量に記録されました。表の速度はprofilerを切り、100ステップの最後にtorch.cuda.synchronize()でGPUの完了を待って計算しています。
ワーカーの起動にも時間がかかります。短い学習なら、ワーカーを増やしても起動時間で損をする場合があります。ここでは先に40ステップを実行し、4ワーカーはプロセスを維持してから計測しました。「最初の1エポックも含めた総時間」が知りたい場合は、ワーカーの起動時間まで測った記事の条件と合わせて見る必要があります。
待っている場所が見えた
今回は、画像の切り抜きと回転を学習ループ自身が行う0プロセス構成で、次のバッチを受け取るまでの時間が長くなっていました。4プロセスへ分けると、その区間が短くなり、profilerを外した計測でも速くなりました。
軽いToTensorだけの場合や、計算量の大きなモデルで同じ差が出るかは別です。まず記録された区間を見て、変更後はprofilerを外して時間を測ると、観測そのものの負荷を混ぜずに比べられます。
ProfilerActivity.CUDAを指定してもCUDAイベントが出ない場合は、GPU環境とPyTorchの版を確認します。GPU計算が動いていても、詳細記録に必要なCUPTIを利用できない環境では記録が欠ける場合があります。