実験機: Core i7-14700F、RTX 5070 Ti 16 GB、RAM 32 GB
環境: Windows 11、WSL 2、Ubuntu 26.04 LTS、Python 3.14.4、PyTorch 2.13.0+cu130
Windows 11のWSL 2にCUDA版PyTorchを入れ、RTX 5070 Tiで行列積を実行しました。4096×4096のFP32行列では、計算部分の所要時間がCPUの約1/41.7になりました。
導入時は、Windowsのドライバ、WSLから見えるGPU、Python環境の順に確認すると、つまずいた場所を追いやすくなります。以下ではインストールから実際にGPUへ計算を渡すところまで進めます。
WSL2からGPUを使えた
このPCでは、WSL 2上のPyTorchからRTX 5070 Tiを認識し、CUDA行列積を実行できました。
torch.cuda.is_available():True- GPU:NVIDIA GeForce RTX 5070 Ti
- PyTorch:2.13.0+cu130
- PyTorch同梱CUDA ランタイム:13.0
- GPUメモリ:15.92 GiB(PyTorchから取得)
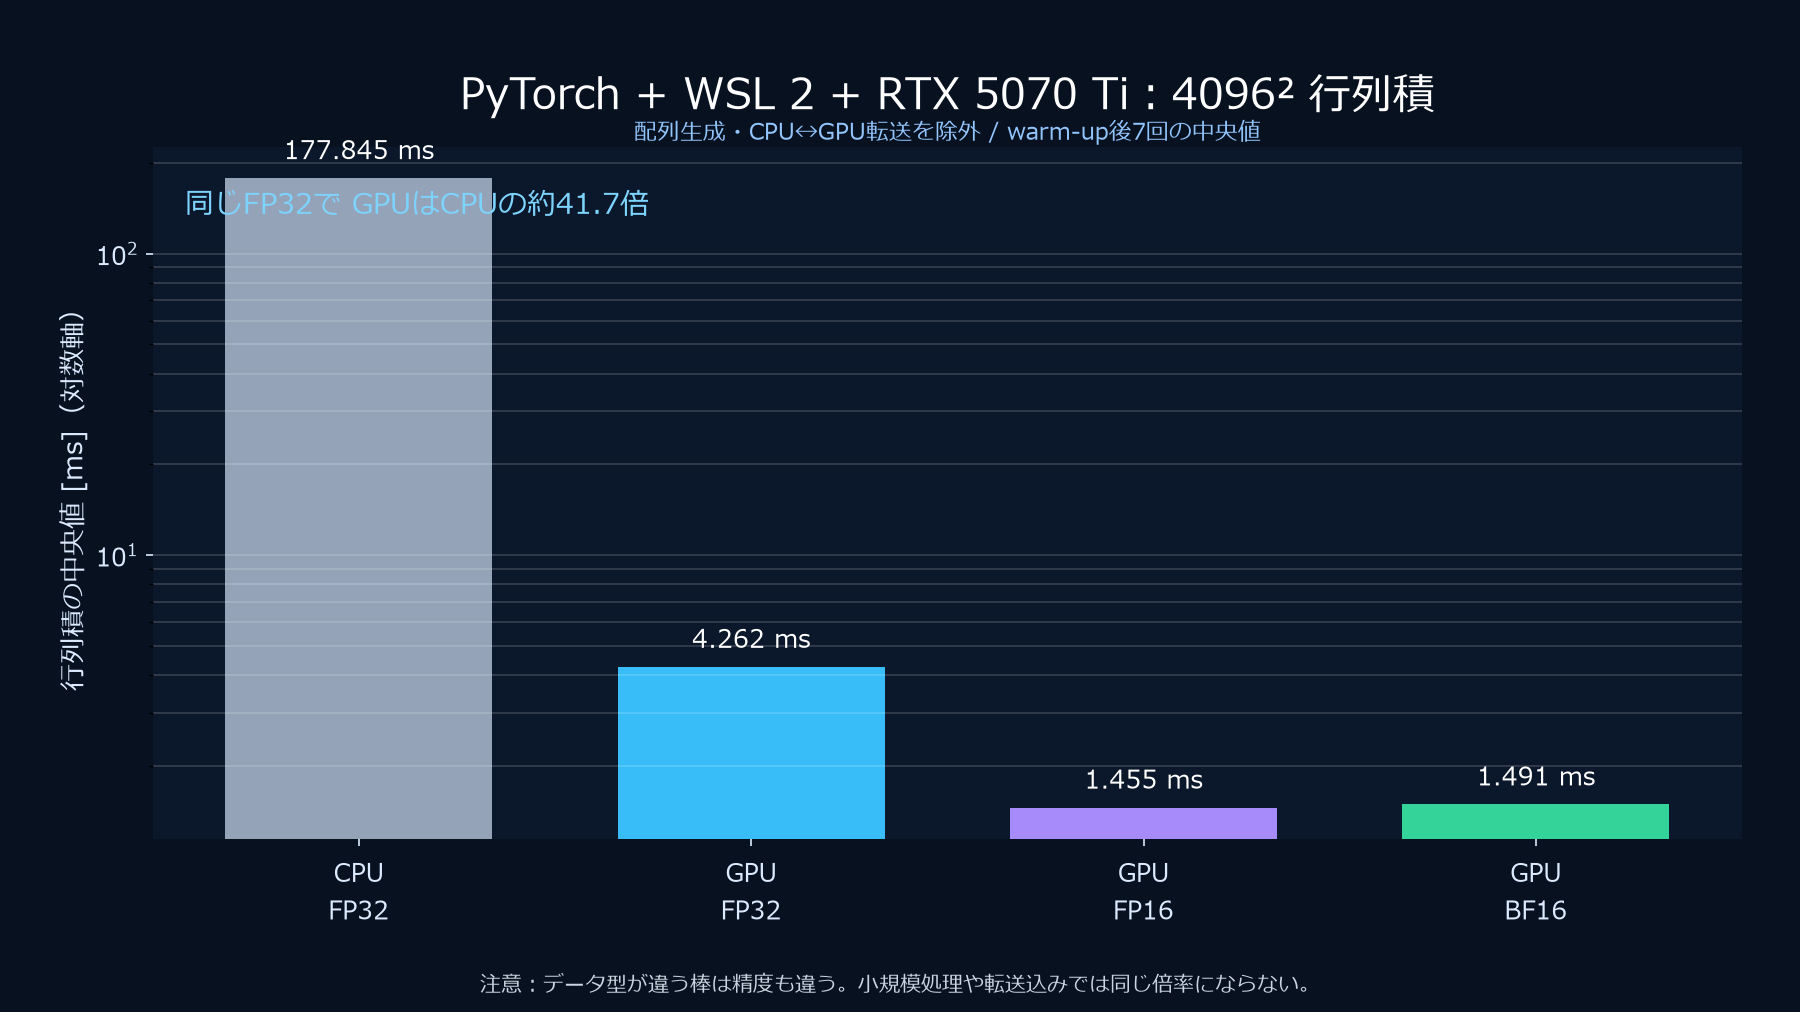
- 4096×4096 FP32行列積:CPU 177.845 ms、GPU 4.262 ms
- 同条件FP32の計算部分:GPUがCPUの約41.7倍
ただし41.7倍は、行列を作る時間とCPUからGPUへ送る時間を除いた、大きな行列積だけの比較です。小さな処理やデータ転送の多いプログラムまで41.7倍になるわけではありません。
ドライバとPyTorchの間にあるもの
CUDA周りで混乱しやすい理由は、「CUDA」という語が複数の層に現れるからです。この実験では次の順に処理がつながります。
Pythonコード
  ↓
PyTorch(torch)
  ↓
PyTorch wheelに含まれるCUDA runtime / cuDNNなど
  ↓
WSL 2がWindows側GPUドライバへ橋渡し
  ↓
RTX 5070 Ti
重要なのは、WSLのUbuntuへ通常のLinux用NVIDIAドライバを重ねて入れる構成ではないことです。Windows側へWSL対応GPUドライバを入れ、WSLからその機能を利用します。Microsoftも、対応Windows、GPUドライバ、WSL、対応Linuxディストリビューションを前提として案内しています。
また、torch.version.cuda == "13.0"は「PyTorchが使うCUDA ランタイムの版」です。nvidia-smiに出るドライバ版595.71とは役割も番号体系も違います。数字が一致していないこと自体は異常ではありません。
必要なもの
- Windows 11、またはWSL GPU計算の要件を満たすWindows 10
- NVIDIA GPUと、WSL CUDA対応のWindows側ドライバ
- WSL 2とUbuntuなどのglibcベースLinux
- 空き容量20 GB程度(CUDA版PyTorchと依存パッケージは大きい)
- PowerShellを実行できること
WSLをまだ導入していない場合は、管理者PowerShellで次を実行し、必要なら再起動します。
wsl --install -d Ubuntu
本実験ではWSL 2.7.12、Linux カーネル 6.18.33.2、Ubuntu 26.04 LTSを使用しました。
手順1:Windows側ドライバがWSLから見えるか確認する
PyTorchを入れる前に、GPUまでの下半分が動いているか切り分けます。PowerShellから次を実行しました。
wsl.exe -d Ubuntu -u root -- /usr/lib/wsl/lib/nvidia-smi `
  --query-gpu=name,driver_version,memory.total,compute_cap `
  --format=csv,noheader
実際の出力は次でした。
NVIDIA GeForce RTX 5070 Ti, 595.71, 16303 MiB, 12.0
ここでGPU名が出なければ、PyTorchの入れ直しへ進む前に、Windows側ドライバ、WSLの版、WSLカーネルを確認します。
手順2:PyTorch用のPython環境を作る
UbuntuへPythonの仮想環境とビルド用の基本パッケージを入れます。
sudo apt-get update
sudo apt-get install -y python3-venv python3-pip build-essential
次に、AI実験専用の仮想環境を作ります。
sudo python3 -m venv /opt/ai-lab/venv
sudo /opt/ai-lab/venv/bin/python -m pip install --upgrade pip setuptools wheel
仮想環境を使う理由は、OSのPythonと実験用パッケージを分離するためです。研究室で複数テーマを扱うと、「ある実験のためにNumPyを更新したら、別の実験が動かなくなった」が起きます。環境を分け、最後にpip freezeを残すと追試しやすくなります。
手順3:CUDA版PyTorchを明示して入れる
本実験ではPyTorch公式インデックスでPython 3.14用wheelの存在を確認し、CUDA 13.0版を固定して導入しました。
sudo /opt/ai-lab/venv/bin/python -m pip install \
  torch==2.13.0+cu130 torchvision==0.28.0+cu130 \
  --index-url https://download.pytorch.org/whl/cu130
--index-urlを省くと、意図と違うビルドを取る可能性があります。研究の再現性を重視するなら、記事を読んだ時点の最新版へ無条件に追従するより、実験で使った版を記録します。一方、将来その組み合わせが古くなった場合は、PyTorch公式の「Start Locally」でOS、パッケージ、language、compute platformを選び直してください。
手順4:読み込みではなくCUDAまで確認する
次をverify_cuda.pyとして実行するか、Pythonへ貼り付けます。
import torch
import torchvision

print("torch", torch.__version__)
print("torchvision", torchvision.__version__)
print("cuda_available", torch.cuda.is_available())
print("cuda_runtime", torch.version.cuda)
print("device", torch.cuda.get_device_name(0))
print("capability", torch.cuda.get_device_capability(0))

a = torch.randn(2048, 2048, device="cuda")
b = torch.randn(2048, 2048, device="cuda")
torch.cuda.synchronize()
c = a @ b
torch.cuda.synchronize()

print("matmul_mean", float(c.mean()))
print("allocated_MiB", round(torch.cuda.memory_allocated() / 1024**2, 1))
実機出力です。
torch 2.13.0+cu130
torchvision 0.28.0+cu130
cuda_available True
cuda_runtime 13.0
device NVIDIA GeForce RTX 5070 Ti
capability (12, 0)
matmul_mean -0.006466319784522057
allocated_MiB 80.0
ここでは4段階で確認しています。
importできる:Pythonパッケージが壊れていないis_available()がTrue:PyTorchからCUDAを利用可能- GPU名が正しい:意図したGPUが選ばれている
device="cuda"の行列積が完了:実際の演算をGPUへ投入できる
Trueだけをスクリーンショットにして終えるより、実演算まで通す方が強い確認になります。
CPUとGPUで同じ行列を掛ける
行列積で比べる理由
4096×4096のように計算量が大きい行列積では、RTX 5070 TiがCore i7-14700Fより短時間で計算する。ただしGPU起動・転送のオーバーヘッドを含む小規模処理には、その倍率をそのまま適用できない。
条件
| 項目 | 設定 |
|---|---|
| 行列サイズ | 4096×4096を2個 |
| 演算 | left @ right |
| 乱数乱数シード | 42 |
| CPUデータ型 | FP32 |
| GPUデータ型 | FP32 / FP16 / BF16 |
| ウォームアップ | CPU 1回、GPU 3回 |
| 本計測 | 各7回 |
| 代表値 | 中央値 |
| 計測外 | 配列生成、CPU↔GPU転送 |
GPU処理は非同期で進むため、単純にtime.perf_counter()で囲むだけでは、処理が終わる前に時計を止める可能性があります。そこで各GPU計測の終了前にtorch.cuda.synchronize()を呼び、GPU完了を待ちました。この点はPyTorch公式のCUDA 意味にも明記されています。
実測結果
| 実行先 | データ型 | 中央値 | 推定演算性能 | ピークPyTorch割当 |
|---|---|---|---|---|
| CPU | FP32 | 177.845 ms | 0.773 TFLOPS | — |
| GPU | FP32 | 4.262 ms | 32.244 TFLOPS | 288.0 MiB |
| GPU | FP16 | 1.455 ms | 94.466 TFLOPS | 160.0 MiB |
| GPU | BF16 | 1.491 ms | 92.165 TFLOPS | 160.0 MiB |
FP32同士では、177.845 / 4.262 ≒ 41.7なので、計算部分はGPUが約41.7倍高速でした。FP16はGPU FP32より約2.93倍短時間ですが、表現できる数の精度や範囲が異なります。「速いから常にFP16へ変えてよい」ではありません。
推定TFLOPSは2 × N³ ÷ 秒で計算した、この行列積に対する値です。GPU製品仕様の理論ピークそのものではありません。
なぜ平均ではなく中央値にしたか
PC上の計測は、バックグラウンド処理、初回ライブラリロード、クロック変動などで外れ値が出ます。7回の中央値なら、1回だけ遅い値が混ざっても代表値が大きく引っ張られません。
ただし、7回で統計的に十分だと断言しているわけではありません。卒論の評価値に使うなら、反復数を増やし、平均・標準偏差・信頼区間、温度や消費電力も記録するのが次の段階です。
よくある失敗と復旧
torch.cuda.is_available()がFalse
最初に次の順で確認します。
/usr/lib/wsl/lib/nvidia-smi
/opt/ai-lab/venv/bin/python -c "import torch; print(torch.__version__, torch.version.cuda)"
/opt/ai-lab/venv/bin/python -c "import torch; print(torch.cuda.is_available())"
nvidia-smiも失敗:Windows側ドライバ、WSL更新、再起動を確認torch.version.cudaがNone:CPU版PyTorchを入れた可能性- GPUは見えるがPyTorchだけ失敗:wheelとPython版、ドライバ対応を確認
No module named venvまたはensurepip is not available
Ubuntuで仮想環境パッケージを入れます。
sudo apt-get update
sudo apt-get install -y python3-venv python3-pip
APT終了時のsystemd警告
本環境ではAPTのtriggerでTransport endpoint is not connectedという警告が一度出ました。ただしAPTの終了コードは0で、python3-venvなども導入済みでした。警告文字列だけで失敗と判断せず、終了コードと目的のコマンドが動くかを確認します。
速度が毎回大きく違う
- 初回実行をそのまま採用していないか
- GPU完了前に計測を止めていないか
- 行列生成や転送を含めたり除いたりしていないか
- 他のGPUアプリが動いていないか
- 反復回数と代表値が同じか
「何秒だったか」だけでなく、どこからどこまでを測ったかが再現性の本体です。
行列積が動いた後の速度確認
4096角の行列積ではGPUが約41.7倍速かったものの、これは計算部分の比較です。画像の読み込みや転送、重み更新を含む学習時間には、そのまま当てはまりません。FP16・BF16も短時間で動きましたが、出力の精度は用途ごとに確認が必要です。
同じ環境でFashionMNISTのCNNをCPUとGPUで学習したところ、学習全体では約2倍の差でした。GPUが認識できたら、使いたいモデルでも時間を測ってみると違いが分かります。
実行環境と記録ファイル
- 環境収集:
work/ai_lab/collect_environment.py - ベンチマーク:
work/ai_lab/benchmark_matmul.py - 環境JSON:
work/ai_lab/results/environment.json - 生の計測JSON:
work/ai_lab/results/matmul.json - 完全な依存関係:
work/ai_lab/requirements-freeze.txt - グラフ生成:
work/ai_lab/make_pytorch_setup_assets.py - 全スクリプトの乱数乱数シード:42
参考:
- Microsoft: Enable NVIDIA CUDA on WSL 2
- PyTorch: Start Locally
- PyTorch: CUDA 意味
- PyTorch: torch.cuda API
