環境: RTX 5070 Ti / WSL2 / PyTorch 2.13.0+cu130 / ONNX 1.22.0 / ONNX Runtime 1.29.0
FashionMNISTのCNNをONNXへ変換し、PyTorchとONNX Runtimeへ同じテスト画像1万枚を渡しました。予測クラスはすべて一致し、正解率も86.50%のままでした。
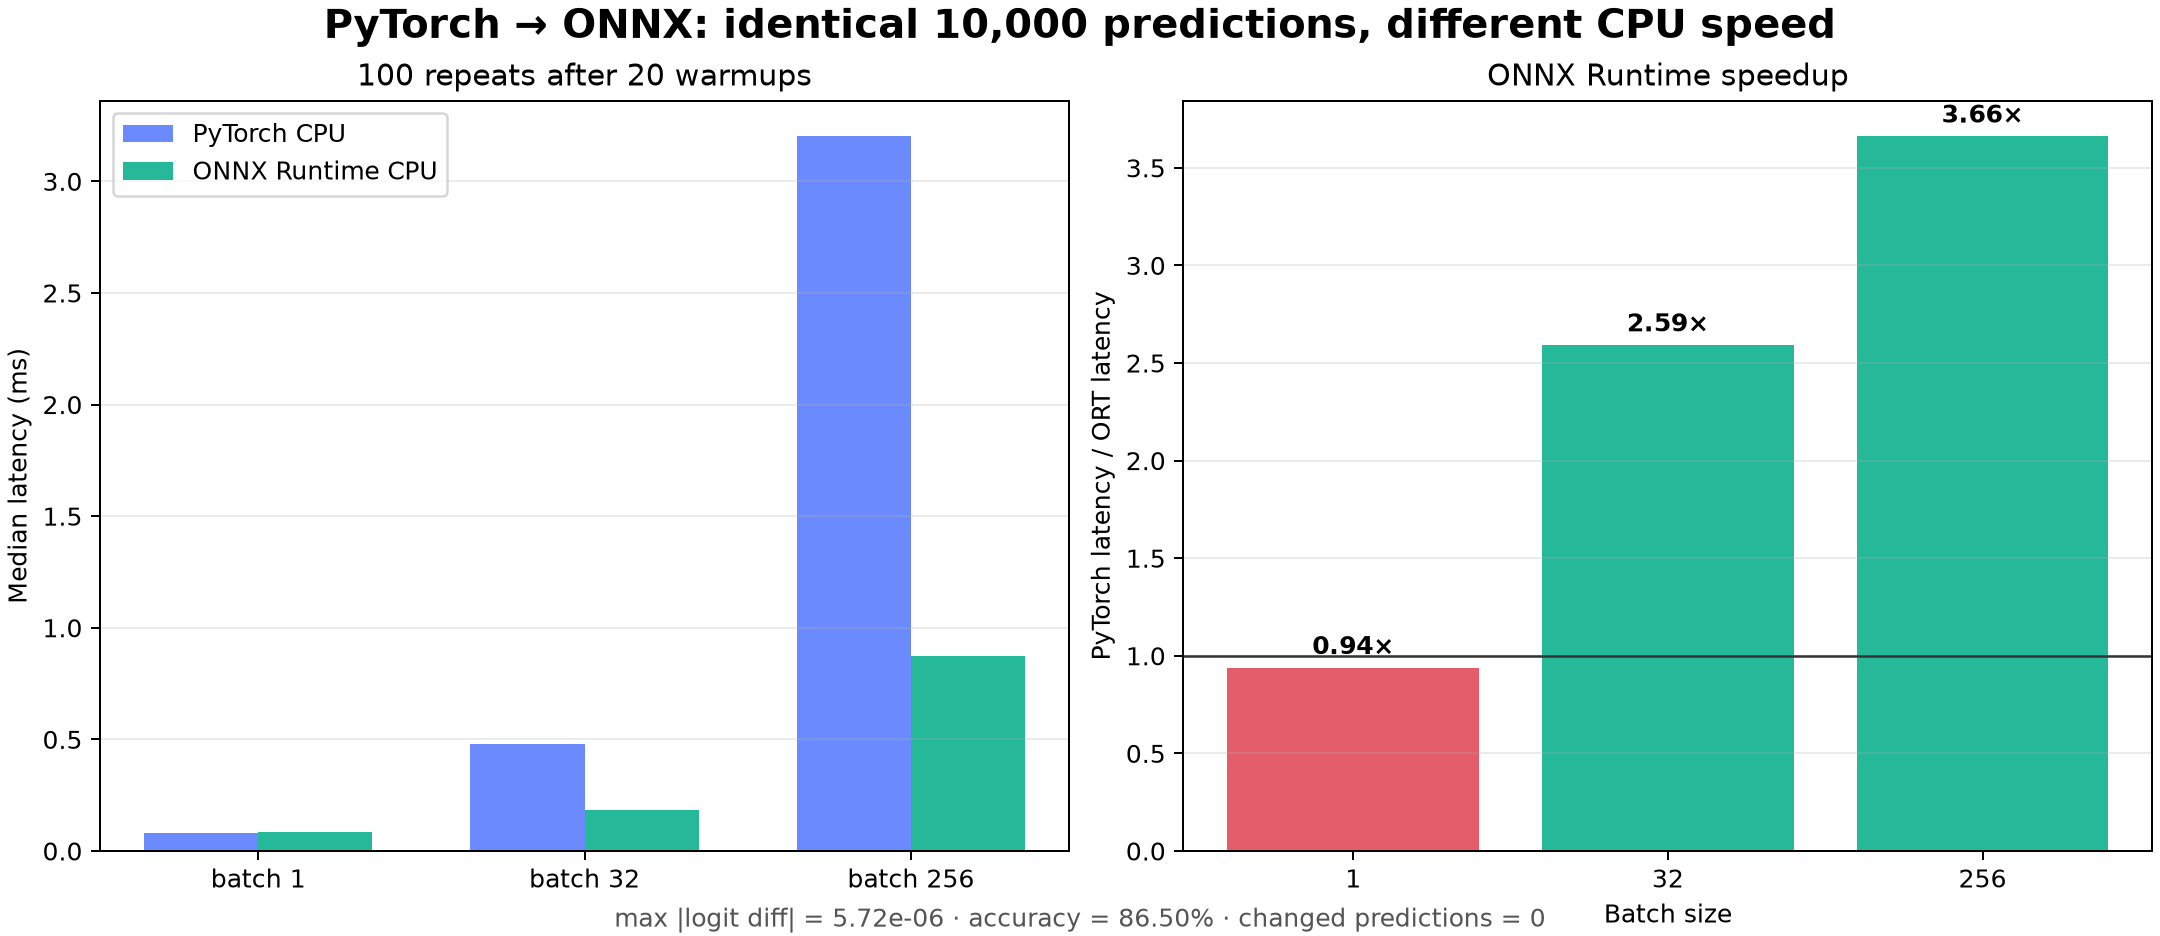
CPUでの推論時間は、まとめて渡す枚数によって変わりました。1枚ずつではONNX Runtimeが少し遅く、256枚ずつでは3.66倍速くなっています。変換手順と、出力・速度の確認方法を残します。
1万枚で出力が一致した
| 確認項目 | 結果 |
|---|---|
| テスト画像 | 10,000枚 |
| 最大ロジット絶対差 | 5.72e-6 |
| 平均ロジット絶対差 | 5.07e-7 |
| top-1一致率 | 100% |
| 予測変化 | 0枚 |
| PyTorch 正解率 | 86.50% |
| ONNX Runtime 正解率 | 86.50% |
| バッチ | PyTorch CPU中央値 | ONNX Runtime CPU中央値 | ORT倍率 |
|---|---|---|---|
| 1 | 0.0799 ms | 0.0851 ms | 0.94× |
| 32 | 0.4791 ms | 0.1848 ms | 2.59× |
| 256 | 3.2021 ms | 0.8744 ms | 3.66× |
ONNXは重みファイルだけではない
PyTorchのstate_dictはパラメータ名とテンソルを保存します。モデルクラスのPython コードは別に必要です。
torch.save(model.state_dict(), "fashion_cnn_state_dict.pt")
ONNX ファイルは、演算子グラフ、initializer テンソル、input/output definitionなどを共通形式で表します。Pythonのモデルクラスをそのまま配布しなくても、ONNXを理解するランタイムで実行できます。
今回のファイルサイズです。
PyTorch state_dict  427,551 bytes
ONNX graph          425,562 bytes
ほぼ同じなのは大部分が同じFP32 重みだからです。ただし配備サイズではありません。PyTorchやONNX Runtime本体、CUDA provider、Python、OS ライブラリを含めていません。
学習モデルを固定する
構造はこれまでのFashionMNIST記事と同じ小型CNNです。
Conv2d 1→16, 3×3 + ReLU + MaxPool
Conv2d 16→32, 3×3 + ReLU + MaxPool
Flatten
Linear 1568→64 + ReLU
Linear 64→10
乱数シード 42、Adam、学習率 1e-3、バッチ 256でCUDA学習しました。
epoch 1  2.241 s  loss 0.7327
epoch 2  1.644 s  loss 0.4251
epoch 3  1.634 s  loss 0.3742
学習後にCPUへ移し、eval()を呼びます。dropoutやバッチ normalizationがあるモデルでは、train/eval modeを間違えると書き出し前後の比較が崩れます。
model = model.cpu().eval()
動的バッチ付きで書き出し
dummy 入力は配列の形 (1, 1, 28, 28)です。
example = torch.zeros(1, 1, 28, 28)

torch.onnx.export(
    model,
    example,
    "fashion_cnn_dynamic.onnx",
    input_names=["image"],
    output_names=["logits"],
    dynamic_axes={
        "image": {0: "batch"},
        "logits": {0: "batch"},
    },
    opset_version=18,
    dynamo=False,
)
バッチ軸を動的にしないと、例と同じバッチ 1専用グラフになる場合があります。今回は1、32、256の全バッチを同じONNX ファイルへ入力できました。
opset_versionはONNX 演算子 specificationのバージョンです。大きければ常に良いわけではなく、exporterとtarget ランタイムの対応範囲を合わせます。
legacy exporterの警告を無視しない
PyTorch 2.13は次の警告を出しました。
You are using the legacy TorchScript-based ONNX export.
Starting in PyTorch 2.9, the new torch.export-based ONNX exporter
has become the default.
今回はdynamo=Falseを明示し、simple CNNを既知のlegacy pathで書き出ししました。記事の再現性のため、警告を消していません。
新規projectではPyTorchのONNX 書き出し公式資料を確認し、dynamo=Trueの新exporterもテストすべきです。書き出し routeが違えば対応演算子や動的配列の形の扱いも変わります。
checkerを通してからランタイムへ渡す
ファイルが書けた後、ONNX checkerを実行しました。
graph = onnx.load(path)
onnx.checker.check_model(graph)
今回のグラフはIR バージョン 8、node数10で、checkerを通過しました。
checkerはグラフ schemaやtypeの整合性を検査します。しかしPyTorchと数値的に同じ出力を保証しません。そのため次に実データで出力の一致確認します。
ONNX Runtime CPU sessionを作る
session = ort.InferenceSession(
    "fashion_cnn_dynamic.onnx",
    providers=["CPUExecutionProvider"],
)
今回はCPU同士を比較しました。PyTorch CUDAとONNX Runtime CPUを比べると、format差とデバイス差が混ざるからです。
入力名imageと出力名logitsは書き出し時に固定しました。
ort_logits = session.run(
    ["logits"],
    {"image": batch.numpy()},
)[0]
ONNX RuntimeはNumPy arrayを受け取ります。dtypeはFP32、配列の形はNCHWです。
10,000枚すべてのロジットを比較
1~2サンプルの目視ではなく、テストデータ全体を512枚ずつ実行しました。
diff = np.abs(pytorch_logits - onnx_logits)

max_abs = diff.max()
mean_abs = diff.mean()
agreement = np.mean(
    pytorch_logits.argmax(1) == onnx_logits.argmax(1)
)
結果です。
max absolute difference   0.000005722
mean absolute difference  0.000000507
top-1 agreement           1.0000
changed predictions       0 / 10,000
floating-point演算は演算子統合、計算順序、ライブラリ実装で丸め差が出ます。ロジットのbitwise equalityを要求せず、誤差の大きさとtask-level 予測の両方を確認しました。
今回は全予測が一致しましたが、クラス境界で2つのロジットが極めて近いサンプルなら、数µの差でargmaxが変わる可能性があります。だから最大差だけでなくtop-1 予測の一致率も必要です。
正解率も再計算する
PyTorch CPU accuracy       86.50%
ONNX Runtime CPU accuracy  86.50%
top-1が10,000枚すべて一致するため、正解率も一致します。重要なのは、正解率 86.50%だけでは変換品質を判定できないことです。
例えば100枚の予測が別クラスへ入れ替わっても、正解→誤答と誤答→正解が同数なら全体正解率は同じです。parityにはsample-level 予測の一致率を使います。
ベンチマークはウォームアップ後100回
各バッチで同じ入力を使い、20回ウォームアップした後100回測定しました。
for _ in range(20):
    inference()

for _ in range(100):
    started = time.perf_counter()
    inference()
    times.append(time.perf_counter() - started)
中央値、平均、p95をJSONへ保存しています。記事の表は外れ値に比較的強い中央値です。
DataLoader、ファイル read、前処理、postprocessは含みません。すでにメモリ上にあるtensor/NumPy arrayの順伝播待ち時間です。
バッチ 1ではPyTorchがわずかに速い
PyTorch CPU  0.0799 ms
ORT CPU      0.0851 ms
ONNX Runtimeは0.94倍、つまり約6%遅い結果です。差は約0.005 msで非常に小さく、OS schedulingや測定noiseの影響を受けます。
低待ち時間リクエストでは、グラフ optimizationの利益よりランタイム call 追加コストが支配することがあります。「ONNXへ変換したから速い」とは限りません。
バッチを増やすとONNX Runtimeが速かった
batch 32   PyTorch 0.4791 ms  ORT 0.1848 ms  2.59×
batch 256  PyTorch 3.2021 ms  ORT 0.8744 ms  3.66×
バッチ 256の中央値処理速度換算です。
PyTorch CPU       約79,947 images/s
ONNX Runtime CPU 約292,756 images/s
同じCPUでもONNX Runtimeのグラフ optimizationや演算子実装がこのCNNとバッチサイズで効いた可能性があります。CPU thread設定は明示固定していないため、ライブラリの既定 thread poolも差へ含まれます。
実運用で比較するときはthread数、プロセス数、power setting、NUMA、入力コピーまで固定します。
動的バッチが動くこともテストになっている
書き出し例はバッチ 1でしたが、ONNX Runtimeへバッチ 32と256を渡せました。これは動的軸指定がランタイムで機能した実証です。
配列の形 flexibilityはモデル parityとは別のcontractです。可変解像度や可変sequence lengthが必要なら、それぞれの軸を動的にして複数配列の形でテストします。
モデル配備で追加確認すること
今回のsimple CNNは成功しましたが、実モデルでは次が問題になります。
- 未対応の演算子
- custom autograd function
- Python control flow
- 動的配列の形の不完全な伝播
- preprocessing差
- NCHW/NHWCの取り違え
- FP16/INT8変換後の正解率低下
- providerごとの演算子切り替え
書き出し、checker、ランタイム読み込み、parity、performanceを別stageにすると、失敗場所を切り分けられます。
PyTorch eval model
  ↓ export
ONNX file
  ↓ checker
valid graph
  ↓ runtime load
executable session
  ↓ full test parity
numerical confidence
  ↓ workload benchmark
deployment decision
再現手順
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
source /opt/ai-lab/venv/bin/activate
pip install onnx onnxruntime

cd ~/ai-experiments/work/ai_lab
python -u experiment_pytorch_onnx.py
python plot_pytorch_onnx.py
生成されるファイルは次のとおりです。
work/ai_lab/experiment_pytorch_onnx.py
work/ai_lab/models/fashion_cnn_state_dict.pt
work/ai_lab/models/fashion_cnn_dynamic.onnx
work/ai_lab/results/pytorch_onnx.json
work/figures/pytorch-onnx-fashionmnist.png
未加工の JSONにはenvironment、学習、10,000枚parity、バッチ別100回timing、ファイルサイズ、グラフ付加情報を保存しました。
変換後も同じ画像へ同じクラスを返した
1万枚の予測クラスは一致しましたが、出力値がビット単位で同一だったわけではなく、最大5.72×10^-6の差がありました。CPU推論の速度もバッチサイズによって変わっています。
変換したモデルを使う側でも、入力形状と前処理を合わせて確認します。今回のモデルをさらに小さくしたINT8量子化の実測では、予測も速度も変わりました。
