環境: RTX 5070 Ti / WSL2 / PyTorch 2.13.0+cu130
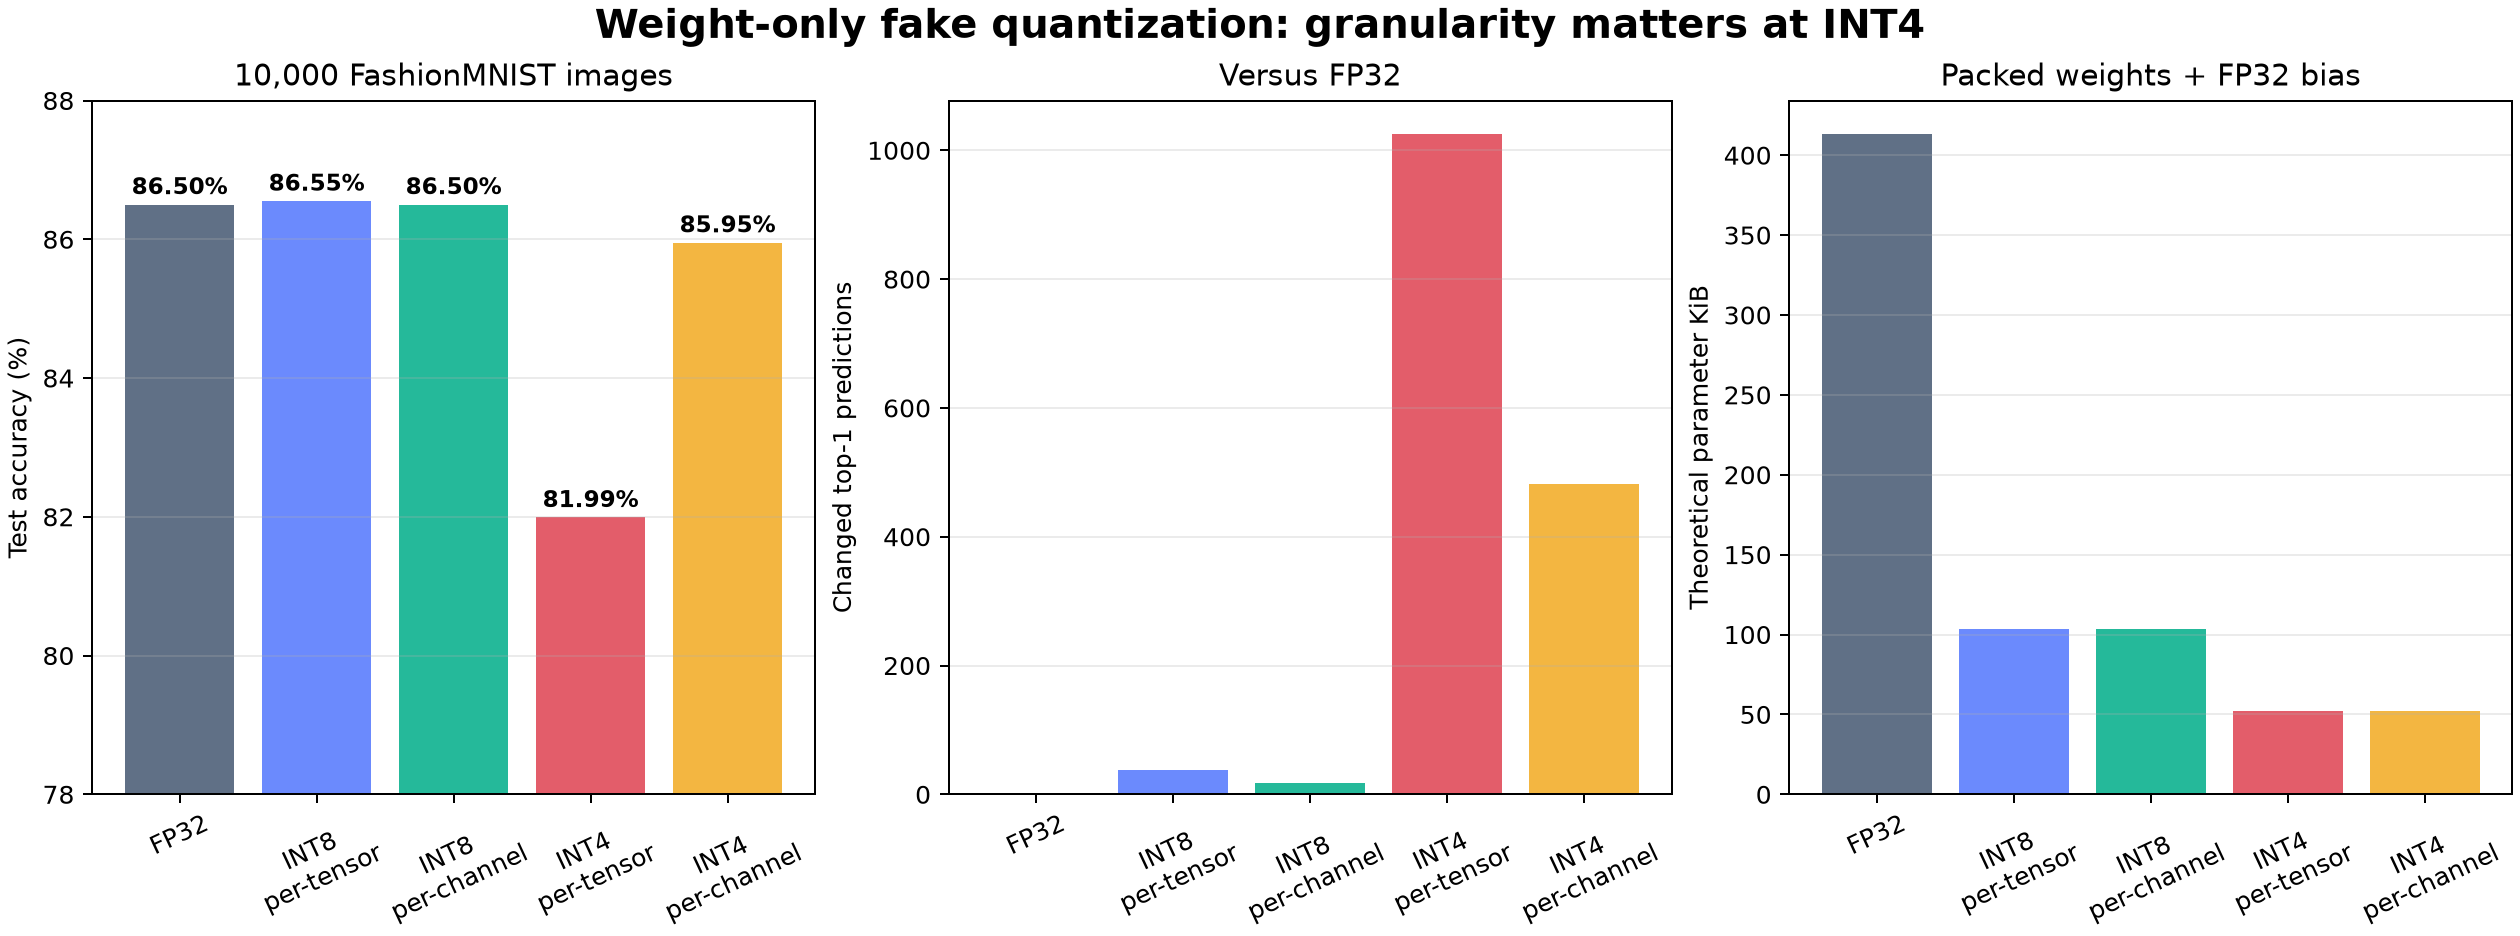
FashionMNISTのCNNの重みをINT8・INT4相当に丸め、予測がどれくらい変わるか調べました。INT4では、層全体を同じ縮尺で丸めると正解率が81.99%、出力チャネルごとに縮尺を決めると85.95%でした。元のFP32は86.50%です。
ここでは丸めた重みをFP32へ戻して計算しています。整数演算で速くなるかを測る前に、丸め誤差だけでどの画像の答えが変わるのかを確認する実験です。
INT8は保ち、INT4は方式で差が出た
| 方式 | 正解率 | FP32から変化 | 平均ロジット差 | 理論パラメータ容量 |
|---|---|---|---|---|
| FP32 | 86.50% | 0 | 0 | 421.3 KiB |
| INT8 per-tensor | 86.55% | 38/10,000 | 0.0369 | 103.7 KiB |
| INT8 per-channel | 86.50% | 18/10,000 | 0.0235 | 103.7 KiB |
| INT4 per-tensor | 81.99% | 1,026/10,000 | 0.7579 | 52.1 KiB |
| INT4 per-channel | 85.95% | 482/10,000 | 0.3331 | 52.1 KiB |
今回は「疑似量子化」
重みだけを丸め、中間出力とバイアスはFP32のままにしました。
weight      INT8またはINT4へ丸める
activation  FP32のまま
bias        FP32のまま
inference   丸めたweightをFP32へ戻して通常のPyTorch演算
計算自体は通常のFP32演算なので、ここでは推論速度ではなく、丸めた結果が予測に与える影響を見ます。
測れるのは、限られたビット数へ重みを丸めたときの数値誤差、予測変化、正解率、理論的な重みを隙間なく詰めて保存した場合の容量です。実配備には整数カーネル、スケール付加情報、整数を詰めて保存する処理、演算子対応が必要です。
対称量子化の式
符号付き b-bit 整数の正側最大値を次で決めます。
qmax = 2^(b-1) - 1

INT8 qmax = 127
INT4 qmax = 7
重みの最大絶対値からスケールを作ります。
scale = max(|w|) / qmax
q = clip(round(w / scale), -qmax, qmax)
w_hat = q × scale
qが量子化整数、w_hatが逆量子化した FP32近似値です。ゼロ点を0に固定するため対称と呼びます。
Python実装です。
qmax = 2 ** (bits - 1) - 1
scale = weight.abs().max() / qmax
q = torch.clamp(torch.round(weight / scale), -qmax, qmax)
dequantized = q * scale
INT4は使える段階が15個しかない
今回の対称定義ではINT8は-127~127、INT4は-7~7を使います。
INT8: 255 levels
INT4:  15 levels
bitを半分にすると表現点は半分ではなく、255から15へ大幅に減ります。重み分布が広いとスケールが大きくなり、小さな重みが同じ値や0へ丸められます。
これがINT4 per-tensorで正解率が4.51ポイント下がった主因と考えられます。ただし層別中間出力やクラス別誤りまで解析していないため、因果を断定しません。
per-tensorはスケールを1個だけ使う
per-tensor 量子化は、層重み全体の最大絶対値を使います。
scale = weight.abs().max() / qmax
実装と付加情報が単純です。しかし1つの出力チャネルだけ大きな重みを持つと、他チャネルもその大きいスケールへ合わせられ、細かな値を表せません。
今回のINT4 per-tensorです。
accuracy             81.99%
changed predictions   1,026
top-1 agreement       89.74%
max logit difference   3.519
mean logit difference  0.758
10枚に約1枚の予測がFP32から変わりました。全体正解率だけでなく予測の一致率を見ると、内部挙動の変化が大きいと分かります。
per-channelは出力ごとにスケールを持つ
Conv2d 重みは[out_channels, in_channels, kh, kw]、Linearは[out_features, in_features]です。出力チャネルごとに、それ以外の軸について最大絶対値を求めます。
dims = tuple(range(1, weight.ndim))
scale = weight.abs().amax(dim=dims, keepdim=True) / qmax
これで、出力ごとの重みの範囲にスケールを合わせられます。
INT4 per-channel結果です。
accuracy             85.95%
changed predictions     482
top-1 agreement       95.18%
max logit difference   1.671
mean logit difference  0.333
per-tensorより正解率は3.96ポイント高く、予測変化は1,026枚から482枚へ半減しました。ロジット差の平均も0.758から0.333へ減っています。
ビット数が同じでも丸める範囲の分け方が結果を大きく変えました。
INT8はほぼ正解率を維持した
INT8 per-tensorは86.55%、per-channelは86.50%でした。FP32の86.50%とほぼ同じです。
per-tensorが0.05ポイント高いのは、量子化でモデルが改善したと断定できる差ではありません。10,000枚中、正解数が5枚増えただけです。丸めで一部の誤答が正解へ変わり、別の正解が誤答へ変わった結果です。
予測変化を見ると差があります。
INT8 per-tensor   38枚変化
INT8 per-channel  18枚変化
正解率が同じでも、per-channelの方がFP32 モデルに近い出力です。
層別重み MSEもper-channelが小さい
平均二乗誤差を層ごとに保存しました。最大の差があった最初のConv2dです。
INT8 per-tensor    2.92e-6
INT8 per-channel   0.93e-6

INT4 per-tensor    8.88e-4
INT4 per-channel   3.07e-4
Linear 1568→64でもINT4は1.72e-4から4.50e-5へ減りました。チャネルごとの範囲調整が重み復元誤差を一貫して下げています。
ただし重み MSEが小さいほど課題正解率が必ず高いとは限りません。層感度や中間出力分布が異なるからです。最後は検証用・テスト用データで予測を確かめます。
理論容量はFP32の約1/4と1/8
モデルの重み要素数へビット数を掛け、バイアスはFP32のままとして計算しました。
FP32 raw parameters  約421.3 KiB
INT8 weights         約103.7 KiB
INT4 weights          約52.1 KiB
INT8は約24.6%、INT4は約12.4%です。バイアスがFP32なので厳密に1/4、1/8ではありません。
さらに実ファイルには次が加わります。
- per-channel スケール
- テンソル配列の形とdtype
- 演算子グラフ
- 配置の整列と余白
- ファイル形式を示すヘッダ
- 必要に応じたゼロ点
今回の値は「隙間なく詰めて保存したパラメータの理論値」であり、実際のONNXや実行用ファイルのサイズではありません。
per-channel スケールの付加情報も本来は数える
図の理論容量はスケール付加情報を除外しました。per-channelは層ごとに出力数分のスケールが必要です。
このCNNなら出力チャネルは16、32、64、10です。
16 + 32 + 64 + 10 = 122 scales
122 × FP32 4 bytes = 488 bytes
約0.48 KiBなので全体には小さいですが、非常に小さなテンソルが多いモデルでは無視できません。ゼロ点もチャネルごとならさらに増えます。
どの画像の答えが変わったか
INT8のper-tensorでは、正解数が5枚増えた一方、予測が変わった画像は38枚ありました。差し引きの正解数だけでは、入れ替わった誤答を見落とします。今回は変化した件数までの集計で、特定の衣服へ誤りが集中しているかは調べていません。
PTQとQATの違い
今回のように学習済み重みを後から丸める方法はPost-Training Quantizationの簡易模擬実験です。
Quantization-Aware Trainingでは、順伝播中に量子化誤差を模擬しながら重みを更新します。特にINT4の正解率を回復できる可能性があります。
PTQ: train FP32 → quantize → evaluate
QAT: fake quantizationを入れて追加学習 → quantize → evaluate
ただしQATは学習コスト、実装、調整する設定値が増えます。まずPTQ 比較の基準でどれだけ落ちるか測ると、QATが必要か判断できます。
中間出力量子化は別問題
今回中間出力はFP32です。実際の整数推論では中間出力もINT8へ量子化する場合があります。そのスケールを決めるには実際の入力を代表する、範囲調整用のデータが必要です。
中間出力範囲へ外れ値があるとスケールが粗くなります。キャリブレーションサンプルの選び方、外れ値の切り捨て方、dynamic/static 量子化によって結果が変わります。
重みだけをINT8にした場合で正解率が維持できたからといって、中間出力も整数で計算するINT8でも同じとは限りません。
整数演算の速度は別に測る
丸めた値は次のようにFP32テンソルへ戻しています。
parameter.copy_(quantized_integer * scale)
この状態で時間を測っても、通常のFP32演算の速度です。整数を扱う演算子で動かした結果は、ONNX RuntimeのINT8実験にまとめました。そちらでは容量が減っても、このCPUでは速くなりませんでした。
再現手順
前記事のstate dictを入力に使います。
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments/work/ai_lab
/opt/ai-lab/venv/bin/python -u experiment_weight_quant_sim.py
/opt/ai-lab/venv/bin/python plot_weight_quant_sim.py
生成されるファイルは次のとおりです。
work/ai_lab/models/fashion_cnn_state_dict.pt
work/ai_lab/experiment_weight_quant_sim.py
work/ai_lab/results/weight_quant_sim.json
work/ai_lab/plot_weight_quant_sim.py
work/figures/int8-int4-weight-quant.png
JSONには方式ごとの正解率、10,000枚の予測の一致率、ロジット差、理論容量、全4 重み層のMSEを保存しました。
