GPU: RTX 5070 Ti 16GB / WSL2 / Ollama 0.32.15
Model: Gemma 3 4B Q4_K_M
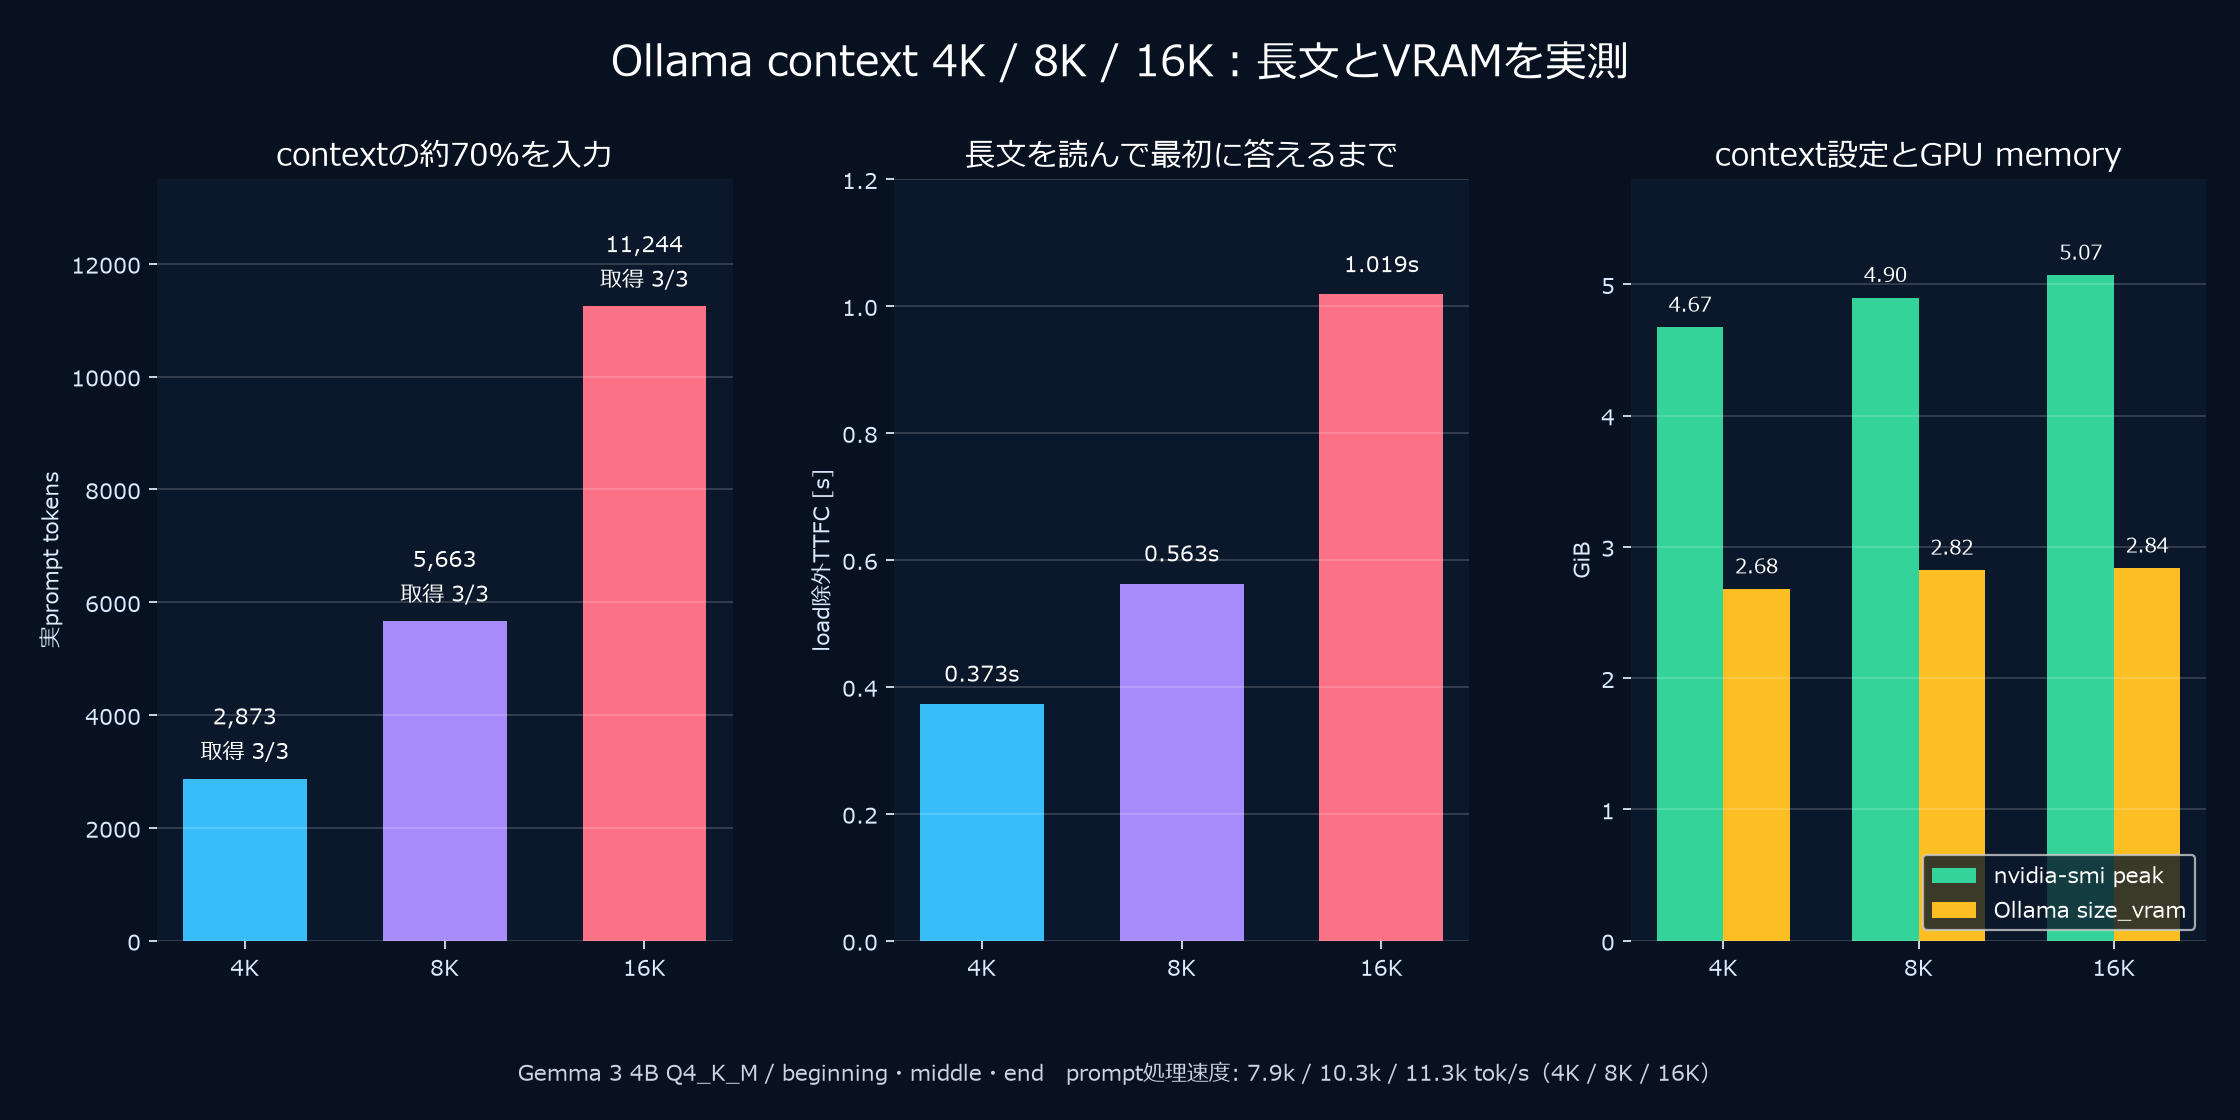
Gemma 3 4Bに長い架空の研究ログを渡し、その中へ埋めた文字列を探させました。Ollamaのコンテキスト設定は4K・8K・16K、実際の入力は約2.9K・5.7K・11.2Kトークンです。
文字列を先頭・中央・末尾へ置いた9条件では、すべて取り出せました。最初の回答までの待ち時間は入力が長いほど増えますが、GPU使用量の増加は4Kから16Kで406 MiBに収まりました。
4K・8K・16Kの結果
| num_ctx | 実プロンプトトークン | 秘密コード取得 | 読み込み除外TTFC | プロンプト処理速度 | ピーク GPU used |
|---|---|---|---|---|---|
| 4,096 | 2,873 | 3/3 | 0.373秒 | 7,935 tok/s | 4,783MiB |
| 8,192 | 5,663 | 3/3 | 0.563秒 | 10,339 tok/s | 5,015MiB |
| 16,384 | 11,244 | 3/3 | 1.019秒 | 11,278 tok/s | 5,189MiB |
このPCで普段の短いchatをするだけなら4Kで十分です。複数ファイルや長い論文断片を投入するときだけ8K、16Kへ上げます。大きいコンテキストは無料ではなく、入力を読む待ち時間とメモリを増やすからです。
コンテキスト窓は会話の作業領域
LLMは入力トークンと生成済みトークンをコンテキスト窓内で扱います。概念的には次の制約があります。
input tokens + output tokens + template等のoverhead <= context window
num_ctx=4096は「4,096文字」ではありません。トークンは文字より細かい場合も、複数文字をまとめる場合もあります。日本語、英語、数字、コードで文字数/token比は変わります。
またnum_ctx=16384へ設定しても、短いプロンプトを送れば実際の入力は短いままです。コンテキスト capacityと実プロンプト lengthを区別します。
KV キャッシュは何を保存するのか
Transformerは過去トークンへattentionします。生成のたびに過去のkey/valueを最初から再計算すると無駄なので、各層のkeyとvalueをキャッシュします。これがKV キャッシュです。
単純なfull attention モデルなら、KV キャッシュの概算は次の要素へ比例します。
KV cache ∝ layers × context tokens × KV heads × head dimension × 2(K,V) × bytes
コンテキストを2倍にするとKV部分も概ね増えます。ただし実モデルはGrouped-Query Attention、sliding-window attention、KV量子化などを使う場合があり、全VRAMが単純に2倍になるわけではありません。重みはコンテキスト長に関係なく大部分を占めます。
Gemma 3はローカルとglobal attentionを混ぜる
Google DeepMindのGemma 3 Technical Reportでは、ローカル sliding-window self-attentionを5 層、その後global self-attentionを1 層という5:1 パターンで交互に使うと説明されています。
ローカル層は無制限に全過去トークンを見るのではなく、近傍windowを中心に見ます。global 層は長距離情報を扱います。Gemma 3 モデル cardでは4B、12B、27Bが128K コンテキストに対応します。
4Kから16Kへのメモリ増加が406 MiBにとどまった結果は、この構造と整合します。ただしOllama内部の層別KV allocationは測っていないため、5:1構造だけで増加分を説明できるとは限りません。
実験環境とモデル
Windows 11 + WSL2 Ubuntu
NVIDIA GeForce RTX 5070 Ti 16GB
driver 595.71
Ollama 0.32.15
gemma3:4b-it-q4_K_M
temperature 0 / seed 42 / think false
前記事のQ4/Q8比較でQ4_K_MはQ8_0より約25%高速、約1.5GiB低メモリでした。今回はコンテキストコストを見やすくするためQ4を固定しました。
実際にコンテキストの約70%を埋める
recordは次の形式です。
LOG 00042 | sensor=S08 | status=normal | value=0545 | note=no anomaly.
ただ同じ単語をコピーするだけでなく、番号、sensor、valueを変えました。まず100 recordをAPIへ送り、実単語分割器でprompt_eval_count=3,179を得ました。
estimated tokens per record = 3,179 / 100 = 31.79
この値から各コンテキストの70%を目標にrecord数を決めます。
record_count = int(num_ctx * 0.70 / tokens_per_record)
実際にはtemplate、指示、秘密recordの追加コストがあるため、最終値はAPIのprompt_eval_countを採用します。
num_ctx 4,096   90 records   2,873 tokens
num_ctx 8,192  180 records   5,663 tokens
num_ctx 16,384 360 records  11,244 tokens
どれも設定の約68.6~70.1%です。入力と短い出力の余裕を残し、意図しない切り捨てを避けました。
needleを先頭・中央・末尾へ置く
各プロンプトへ1つだけ秘密recordを入れます。
IMPORTANT RECORD | SECRET_CODE=CTX16384-BEGINNING-7319 | preserve this exact code.
挿入位置は次の3種類です。
- beginning: 通常ログより前
- middle: 通常ログの中央
- end: 通常ログの後
最後に質問します。
QUESTION: IMPORTANT RECORDのSECRET_CODEは何ですか。
説明せずcodeだけを正確に出力してください。
ANSWER:
回答文字列に完全なコードが含まれる場合だけ成功です。意味が近い、数字が1桁違う、といった曖昧な採点はしません。
接頭辞キャッシュを切って測る
Ollamaは直前のプロンプト接頭辞やKV キャッシュを再利用できる場合があります。同じ合成ログを続けて送ると、2回目以降のプロンプト評価が不自然に速くなる可能性があります。
そこで9条件すべてで直前にモデルをunloadしました。
unload(model)  # keep_alive=0
run_streamed(prompt, num_ctx=context)
モデル読み込みはAPIのload_durationとして分離できます。ストリーム開始から最初の本文までの実経過時間から読み込み durationを引いた値を、この記事では「読み込み除外TTFC」と呼びます。
並列処理やtiming境界の差を含む近似値ですが、コンテキストを読むコストの目安にはなります。
先頭・中央・末尾の9/9で取得できた
実際の回答です。
CTX4096-BEGINNING-7319
CTX4096-MIDDLE-7319
CTX4096-END-7319

CTX8192-BEGINNING-7319
CTX8192-MIDDLE-7319
CTX8192-END-7319

CTX16384-BEGINNING-7319
CTX16384-MIDDLE-7319
CTX16384-END-7319
今回の最大11,245 トークンでも、先頭のneedleを失いませんでした。Gemma 3のglobal attention 層が長距離情報を運べる設計と整合します。
このテストでは秘密コードが1件だけで、質問も明示的でした。似たコードを混ぜていないため、9/9成功から次の能力までは判断できません。
- 長い論文を正しく要約できる
- 複数箇所の因果関係を統合できる
- 多数の似たIDから正しい1件を選べる
- 16Kの全位置で常に正確
needle 検索は「情報が届くか」のsmoke テストです。長文理解の最終ベンチマークではありません。
入力が約4倍で最初の回答まで約2.7倍
実プロンプトトークンと読み込み除外TTFCです。
 2,873 tokens → 0.373 s
 5,663 tokens → 0.563 s
11,244 tokens → 1.019 s
プロンプトは3.91倍、TTFCは2.73倍です。完全比例より緩く見える理由の1つは固定追加コストです。短いプロンプトではリクエスト、runner、GPU dispatchなどの固定コストが相対的に大きくなります。
入力文の処理速度の中央値も増えました。
4K setting    7,935 input tok/s
8K setting   10,339 input tok/s
16K setting  11,278 input tok/s
長い入力でGPUを継続的に使い、固定追加コストが薄まった可能性があります。ただし各コンテキストは位置3回だけです。温度、電力状態、background プロセスでも変わるため、長いほど常にtok/sが上がるとは一般化しません。
GPU ピークは4Kから16Kで406MiB増えた
nvidia-smiを50ms間隔でサンプルしたGPU全体のピークです。
num_ctx 4,096   4,783 MiB
num_ctx 8,192   5,015 MiB  (+232 MiB)
num_ctx 16,384  5,189 MiB  (+174 MiB)
4Kから16Kで+406MiB、約8.5%増です。重みやランタイムの固定部分が大きく、context-dependent部分はその一部でした。
Ollama /api/psのsize_vramも記録しました。
4K   2.68 GiB
8K   2.82 GiB
16K  2.84 GiB
nvidia-smiはGPU全体の使用量、Ollamaのsize_vramはモデルについて報告する値です。差にはCUDA/runtime領域や他プロセスの使用量などが含まれます。
コンテキストを大きくしても短いプロンプトは賢くならない
num_ctx=16384はcapacityを増やしますが、同じ短い質問への回答品質を自動で上げません。むしろメモリを予約し、モデルや実装によっては速度を下げます。
コンテキストを増やすべき場面です。
- 論文本文と質問を同時に入れる
- 複数出典をRAGで渡す
- 長い会話履歴を保持する
- リポジトリの複数ファイルを読ませる
増やさなくてよい場面です。
- 1問1答の短いchat
- 数十行のコード補完
- RAGで必要箇所を十分絞れている
- VRAMへ別モデルや画像処理も載せたい
「最大コンテキストを常に設定」ではなく、入力トークン分布の上位percentileを測って決めます。
自分のPCで再現する
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments
python3 work/ai_lab/experiment_ollama_context_lengths.py
結果です。
work/ai_lab/results/ollama_context_lengths.json
JSONには全9runのプロンプトトークン、プロンプト eval duration、応答、needle成否、GPU サンプル、/api/psを保存します。記事の表だけでなく、position別の生データまで追試できます。
自分の文書で試す場合は、合成ログをそのまま信用せず次の段階へ進みます。
- 実PDFやコードをテキスト化する
- 入力トークンをAPIで記録する
- 先頭・中央・末尾から検証可能な質問を作る
- distractorを追加する
- 複数乱数シードまたは複数プロンプト表現で繰り返す
- 正答率、TTFC、VRAMを一緒に比較する
今回の限界
- Gemma 3 4B Q4_K_Mだけ
- 4K、8K、16Kだけで128K上限は未検証
- 合成ログ 1形式、秘密コード 1件/request
- 各コンテキストのpositionは3回だけ
- 単一リクエストで並列負荷なし
- nvidia-smiはGPU全体のメモリ
- 読み込み除外TTFCは実経過時間とAPI durationの差による近似
- 16Kで成功しても一般的な長文reasoning性能を示さない
16Kでも文字列は取り出せた
11,244トークンの入力でも、先頭・中央・末尾の文字列を取り出せました。ただ、今回の課題は答えを1つ探すだけです。長い論文の内容を整理したり、離れた箇所を結び付けたりする能力までは測れていません。
GPU使用量の増加は406 MiBでしたが、これはGemma 3 4Bと今回のOllamaの組み合わせでの値です。長い入力へ替えるときは、num_ctxだけでなくAPIが返す実際の入力トークン数も確認します。
