CPU: Core i7-14700F / GPU: RTX 5070 Ti / WSL2
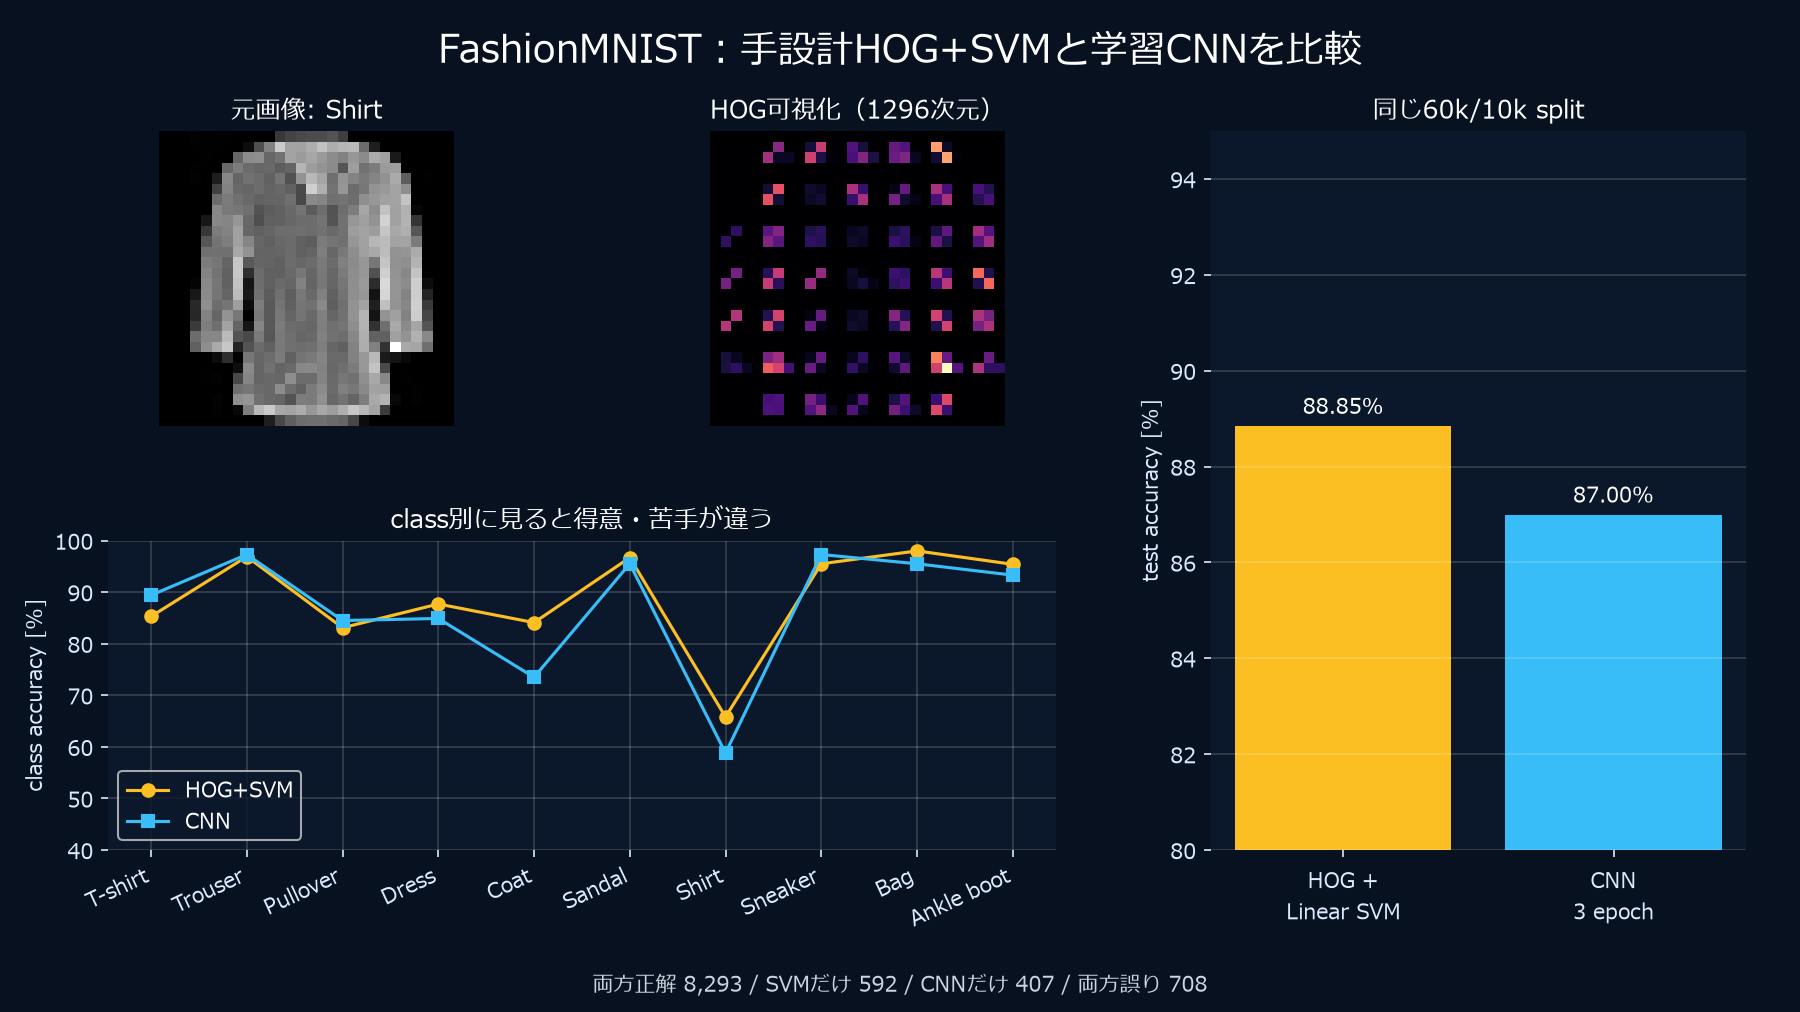
FashionMNISTで、HOGとLinear SVMを組み合わせた分類を試しました。正解率は88.85%で、同じ画像を3エポック学習したCNNの87.00%を上回りました。
HOGは画像の輪郭の向きを数値にする手法です。特徴の取り出し方を人が決める方法でも、この条件では十分強い結果になりました。ただし処理時間はCNNが短く、特にHOGを作る時間を含めると差が開きます。
正解率はHOG+SVM、処理時間はGPUのCNN
| 測定項目 | HOG+Linear SVM(CPU) | CNN(GPU、3エポック) |
|---|---|---|
| テスト1万枚の正解率 | 88.85% | 87.00% |
| 学習画像の特徴量抽出 | 13.73秒 | 学習処理に含む |
| 学習 | 50.45秒 | 3.59秒 |
| テスト画像の前処理と推論 | 約2.25秒 | 0.142秒 |
CPUはCore i7-14700F、GPUはRTX 5070 Tiです。使うプロセッサも違うので、ここで比べているのはこのPCでそれぞれを動かしたときの待ち時間です。SVM側の学習準備と学習を足すと64.18秒でした。
HOGは画像の何を特徴量にするのか
HOGはHistogram of Oriented Gradients、つまり「勾配方向のヒストグラム」です。画素の明るさそのものより、局所的なエッジがどの方向を向いているかを表します。
まず横・縦方向の差分から勾配を求めます。
gx = 横方向の明るさ変化
gy = 縦方向の明るさ変化

magnitude = sqrt(gx² + gy²)
angle     = atan2(gy, gx)
勾配が大きい場所はエッジです。衣服の袖、胴体、靴底、かばんの輪郭などに大きな値が出ます。
次に画像を小さなセルへ分け、セル内の勾配方向をヒストグラムへ投票します。今回の設定です。
features = hog(
    image,
    orientations=9,
    pixels_per_cell=(4, 4),
    cells_per_block=(2, 2),
    block_norm="L2-Hys",
)
scikit-image公式のHistogram of Oriented Gradientsでは、勾配計算、セル内の方向ヒストグラム、ブロック正規化、特徴量ベクトル化という流れが解説されています。
なぜ1,296次元になるのか
28×28画像を4×4画素のセルへ分けると、縦横7セルです。
2×2セルを1ブロックにし、1セルずつずらすので、ブロック位置は縦横6個あります。
1ブロックには次の値があります。
2 × 2 cells × 9 orientations = 36 values
全体では次の通りです。
6 × 6 blocks × 36 values = 1,296 dimensions
元画像は28×28=784画素なので、HOGは次元削減ではなく1,296次元へ増やしています。同じセルが複数ブロックで正規化されるため重複がありますが、局所的なコントラスト変化へ強くなる利点があります。
学習60,000枚をfloat32で保持すると、HOG行列だけで約296.6 MiBです。特徴抽出は計算時間だけでなくRAMも使います。
Linear SVMは1,296次元空間に境界を引く
HOGを抽出した後、LinearSVCへ入力しました。
svm = LinearSVC(
    C=1.0,
    dual="auto",
    max_iter=5000,
    random_state=42,
)

svm.fit(hog_train, y_train)
prediction = svm.predict(hog_test)
クラスごとに概念的には次のスコアを計算します。
score_k(x) = w_k · x + b_k
HOGの特徴量ベクトルxと重みw_kからスコアを求め、最も高いクラスを選びます。特徴量の空間に引く境界は線形です。
今回使ったのはRBF カーネルのSVCではなくLinearSVCです。60,000サンプルに対して計算量を現実的にし、HOG表現が線形の境界でどこまで分類できるかを見ています。
CNNは特徴量そのものを学習する
CNNへは0~1へ変換した画素をそのまま入力しました。
1×28×28
  → Conv 1→16 → ReLU → MaxPool
  → Conv 16→32 → ReLU → MaxPool
  → Linear 1568→64 → ReLU
  → Linear 64→10
HOGのセルの大きさや方向区分は人が決めます。CNNでは畳み込みカーネルの重みを誤差逆伝播で更新し、分類に役立つエッジや模様、部品の組み合わせをデータから学びます。
CNNの学習は3エポックで、画像の切り抜きや回転は加えていません。長く学習させたCNNとの比較は行っていません。
比較に使った画像と学習設定
どちらもFashionMNISTの訓練6万枚、テスト1万枚を使いました。HOGは1枚あたり1,296個のfloat32値に変換し、CPUで抽出と学習を実行しています。
CNNはバッチ256、Adam、学習率0.001で3エポック。画像を増やす加工は加えていません。DataLoaderは4プロセス、pin_memoryを有効にしました。GPUをウォームアップした後にモデルを初期状態へ戻し、そこから学習時間を測っています。
CNNを長く学習させたり構造を変えたりした場合は、順位が変わる余地があります。ここでの87.00%は、この小型モデルを3エポック動かした結果です。
クラス別に見ると違いが大きい
| クラス | HOG+SVM | CNN | 差(SVM-CNN) |
|---|---|---|---|
| T-shirt/top | 85.3% | 89.4% | -4.1 pt |
| Trouser | 96.9% | 97.3% | -0.4 pt |
| Pullover | 83.1% | 84.5% | -1.4 pt |
| Dress | 87.7% | 84.9% | +2.8 pt |
| Coat | 84.1% | 73.5% | +10.6 pt |
| Sandal | 96.7% | 95.5% | +1.2 pt |
| Shirt | 65.8% | 58.8% | +7.0 pt |
| Sneaker | 95.5% | 97.3% | -1.8 pt |
| Bag | 98.0% | 95.5% | +2.5 pt |
| Ankle boot | 95.4% | 93.3% | +2.1 pt |
最大差はCoatの10.6ポイントです。CNNはCoat 1,000枚のうちPulloverへ122、Shirtへ110誤分類しました。HOG+SVMではPulloverへ64、Shirtへ54です。
一方、T-shirt/topではCNNが4.1ポイント上です。HOGが常に優れた特徴ではなく、クラスごとに得意・苦手が違います。
Shirtは両方に難しい
両モデルで最低精度はShirtでした。
- HOG+SVM:65.8%
- CNN:58.8%
HOG+SVMはShirtをT-shirtへ130、Pulloverへ82、Coatへ82誤分類しました。CNNはT-shirtへ211、Pulloverへ106、Coatへ70です。
28×28のグレースケール画像では、シャツとほかの上半身衣類の輪郭が似ています。全体の正解率は約89%でも、Shirtだけは約66%でした。どの衣類を取りこぼしやすいかも見ておきたいところです。
速度はCNNが圧倒的だった
HOG+SVMの学習側コストです。
train HOG extraction  13.73 s
LinearSVC fit          50.45 s
合計                   64.18 s
テスト側です。
test HOG extraction     2.22 s
SVM predict             0.028 s
合計                    約2.25 s
SVMの内積計算だけなら速いのですが、毎回HOGを作る必要があります。特徴抽出が推論の約99%を占めました。
CNNは3エポック学習3.59秒、10,000枚推論0.142秒です。このPCではCNN推論がHOG+SVM 処理全体より約15.8倍速くなりました。
この速度差にはGPUを使った効果も含まれます。CNNとSVMという手法だけの差ではありません。
間違える画像も違う
両方が正解したのは8,293枚、SVMだけが正解したのは592枚、CNNだけが正解したのは407枚でした。残る708枚は両方とも間違えています。予測したラベル自体が一致した割合は88.29%です。
少なくとも一方が正解した画像を足すと9,292枚あります。ただし、これは正解ラベルを見た後で数えた上限で、2つの出力を混ぜれば92.92%になるという結果ではありません。併用するなら、どちらの答えを採るかを訓練・検証データで決め、別のテストデータで確かめる必要があります。
再現方法
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments/work/ai_lab

/opt/ai-lab/venv/bin/python experiment_hog_svm_vs_cnn.py \
  --data-dir /opt/ai-lab/data \
  --output results/hog_svm_vs_cnn.json \
  --figure ../../outputs/hog-svm-vs-cnn.png
JSONにはHOG設定、1,296次元、各処理時間、クラス別精度、2つの混同行列、正誤集合、予測一致率を保存しています。
