Python 3.14.4 / scikit-learn 1.9.0
データ: 8×8手書き数字1,797枚、10クラス
scikit-learnに入っている手書き数字のDigitsを、ロジスティック回帰とRBF-SVMで分類してみました。8×8画素の小さな画像ですが、学習用とテスト用の分け方を6通り試すと、正解率には少しばらつきが出ます。
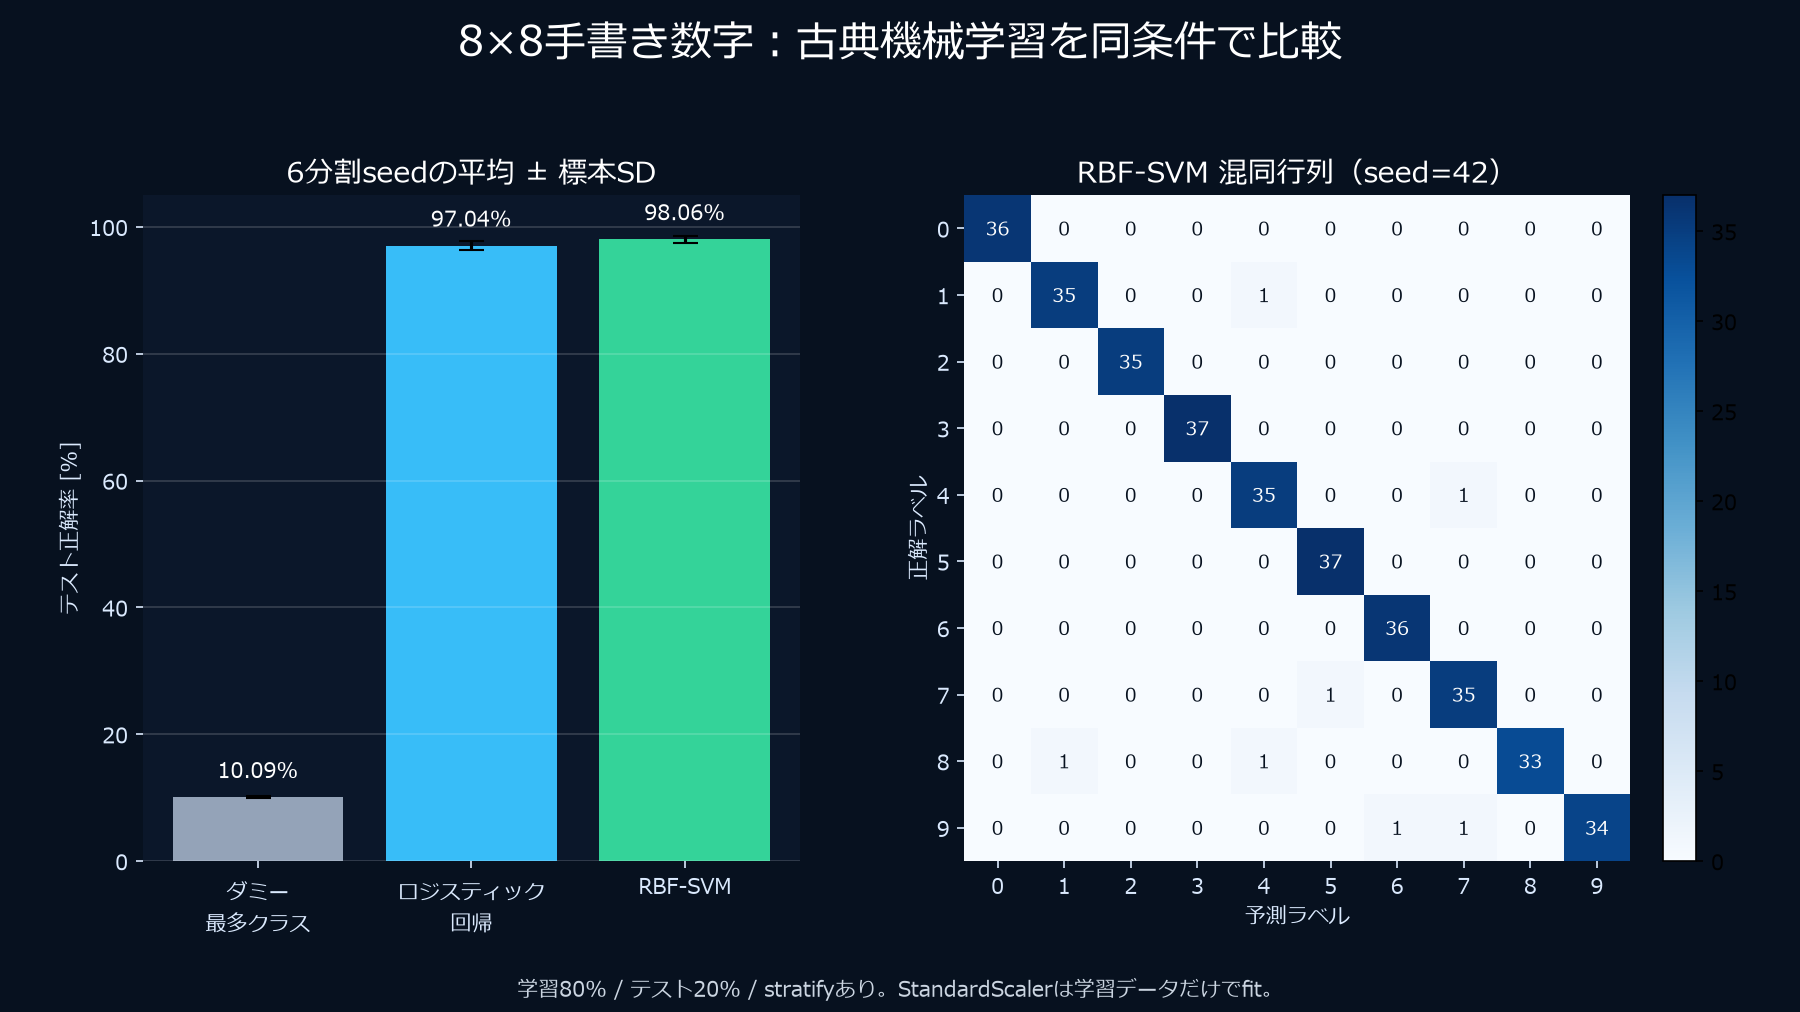
平均はロジスティック回帰が97.04%、RBF-SVMが98.06%でした。精度ではSVMが上ですが、推論には時間がかかります。間違えた数字の画像も見ながら、両者の違いを確認します。
まず結果
6分割のテスト正解率は次の通りでした。
| モデル | 平均正解率 | 標本SD | 最小~最大 |
|---|---|---|---|
| 最多クラスDummy | 10.09% | 0.14ポイント | 10.00~10.28% |
| ロジスティック回帰 | 97.04% | 0.67ポイント | 96.39~98.06% |
| RBF-SVM | 98.06% | 0.53ポイント | 97.22~98.61% |
RBF-SVMが平均で約1.02ポイント高精度でした。一方、乱数シード=42の360枚を予測する時間は、ロジスティック回帰0.63 msに対してRBF-SVM 12.69 msで、SVMは約20倍かかりました。
最高正解率だけならSVM、軽い推論も重視するならロジスティック回帰という判断になります。これは8×8の小さなデータでの結果であり、別のデータにもそのまま一般化はできません。
データを「画像」と「64個の特徴量」の両方で見る
Digitsは0~9の手書き数字1,797枚です。各画像は8×8画素なので、分類器へ渡すときは64個の数値へ平坦化します。画素値は0~16です。
from sklearn.datasets import load_digits

digits = load_digits()
print(digits.images.shape)  # (1797, 8, 8)
print(digits.data.shape)    # (1797, 64)
print(digits.target.shape)  # (1797,)
images[i]:人間が見る8×8画像data[i]:モデルへ入れる長さ64の特徴ベクトルtarget[i]:正解ラベル
画像を平坦化すると、「左上の画素」と「その隣の画素」が隣接していた事実をモデルは明示的には扱いません。それでもこの小さな問題では古典手法が高精度を出せます。CNNとの比較記事では、空間構造を使う価値を同じ観点で確認します。
学習データとテストデータを分ける理由
学習に使った答案で試験をすれば、高得点でも未知データへの性能は分かりません。今回は80%を学習、20%をテストにしました。
x_train, x_test, y_train, y_test = train_test_split(
    digits.data,
    digits.target,
    test_size=0.2,
    random_state=42,
    stratify=digits.target,
)
random_stateは分割を再現する乱数シードです。stratify=digits.targetは、0~9のクラス比率が学習側とテスト側で大きく崩れないようにします。
乱数シード=42の1回だけでは、分割の偶然に結果が左右されます。そこで乱数シードを0、1、2、3、4、42に変えて同じ実験を繰り返しました。6分割の結果を見れば、1回だけの結果より揺らぎを確認しやすくなります。
最低限の比較相手としてDummyを入れる
10クラス分類なら、何も学習せず常に最多クラスを答えても約10%当たります。
from sklearn.dummy import DummyClassifier

dummy = DummyClassifier(strategy="most_frequent")
高度なモデルが60%を出して「高精度」と見えても、ベースラインが70%なら負けています。今回のDummy 10.09%に対し、ロジスティック回帰は97.04%なので、画素からラベルを予測する規則を学べていると判断できます。
標準化をPipelineへ入れてデータ漏洩を防ぐ
ロジスティック回帰とRBF-SVMの前にStandardScalerを入れました。
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

model = make_pipeline(
    StandardScaler(),
    LogisticRegression(max_iter=3000, random_state=42),
)
model.fit(x_train, y_train)
標準化は各特徴量から学習データの平均を引き、標準偏差で割ります。大事なのは、テストデータを含めた全体で平均・標準偏差を先に計算しないことです。それをすると本来未知であるテスト分布の情報が学習工程へ漏れます。
Pipelineなら、fit(x_train, y_train)のときに学習データだけでScalerを学習し、テスト側には同じ変換を適用できます。精度を上げる魔法というより、処理順序の事故を防ぐ仕組みです。
ロジスティック回帰とRBF-SVMは何が違うか
ロジスティック回帰
64特徴量の重み付き和を基礎にクラスを分けます。決定境界は基本的に線形で、学習・推論が軽く、係数も調べやすいのが利点です。「回帰」という名前でも、ここでは分類に使います。
RBF-SVM
RBFカーネルにより、元の特徴空間で直線だけでは分けにくい境界を表現できます。今回はC=10.0、gamma="scale"です。高精度になりやすい一方、サポートベクトルとの計算が必要で、推論コストが増える場合があります。
svm = make_pipeline(
    StandardScaler(),
    SVC(kernel="rbf", C=10.0, gamma="scale"),
)
今回はハイパーパラメータ探索をしていません。テストデータを見ながらCやgammaを調整すると、テストセットまで実質的に学習へ使ってしまいます。調整するなら、学習データ内で交差検証し、最後のテストは一度だけ使います。
乱数シード=42の速度と過学習を見る
| モデル | 学習正解率 | テスト正解率 | 学習 | 360枚予測 | 誤分類 |
|---|---|---|---|---|---|
| Dummy | 10.0% | 10.0% | 0.14 ms | 0.02 ms | 324枚 |
| ロジスティック回帰 | 100.0% | 97.0% | 18.32 ms | 0.63 ms | 10枚 |
| RBF-SVM | 100.0% | 98.06% | 41.97 ms | 12.69 ms | 7枚 |
両モデルとも学習正解率100%ですが、テストは下がりました。学習データへの適合と未知データへの汎化には差があります。ただし3ポイント程度の差だけで「深刻な過学習」と断定はしません。学習曲線や交差検証も合わせて判断します。
速度はこのPCの単発計測で、厳密な性能ベンチマークではありません。それでも、1ポイントの精度向上に推論約20倍という交換条件があることは確認できます。組込みや大量処理なら無視できない差です。
混同行列と誤分類画像を読む
正解率98%だけでは、どのクラスを間違えたか分かりません。混同行列は行が正解、列が予測です。対角成分が正解で、対角線から外れた値が誤分類です。
乱数シード=42のRBF-SVMは、8→1、9→7、4→7、9→6、7→5、1→4、8→4の7枚を間違えました。
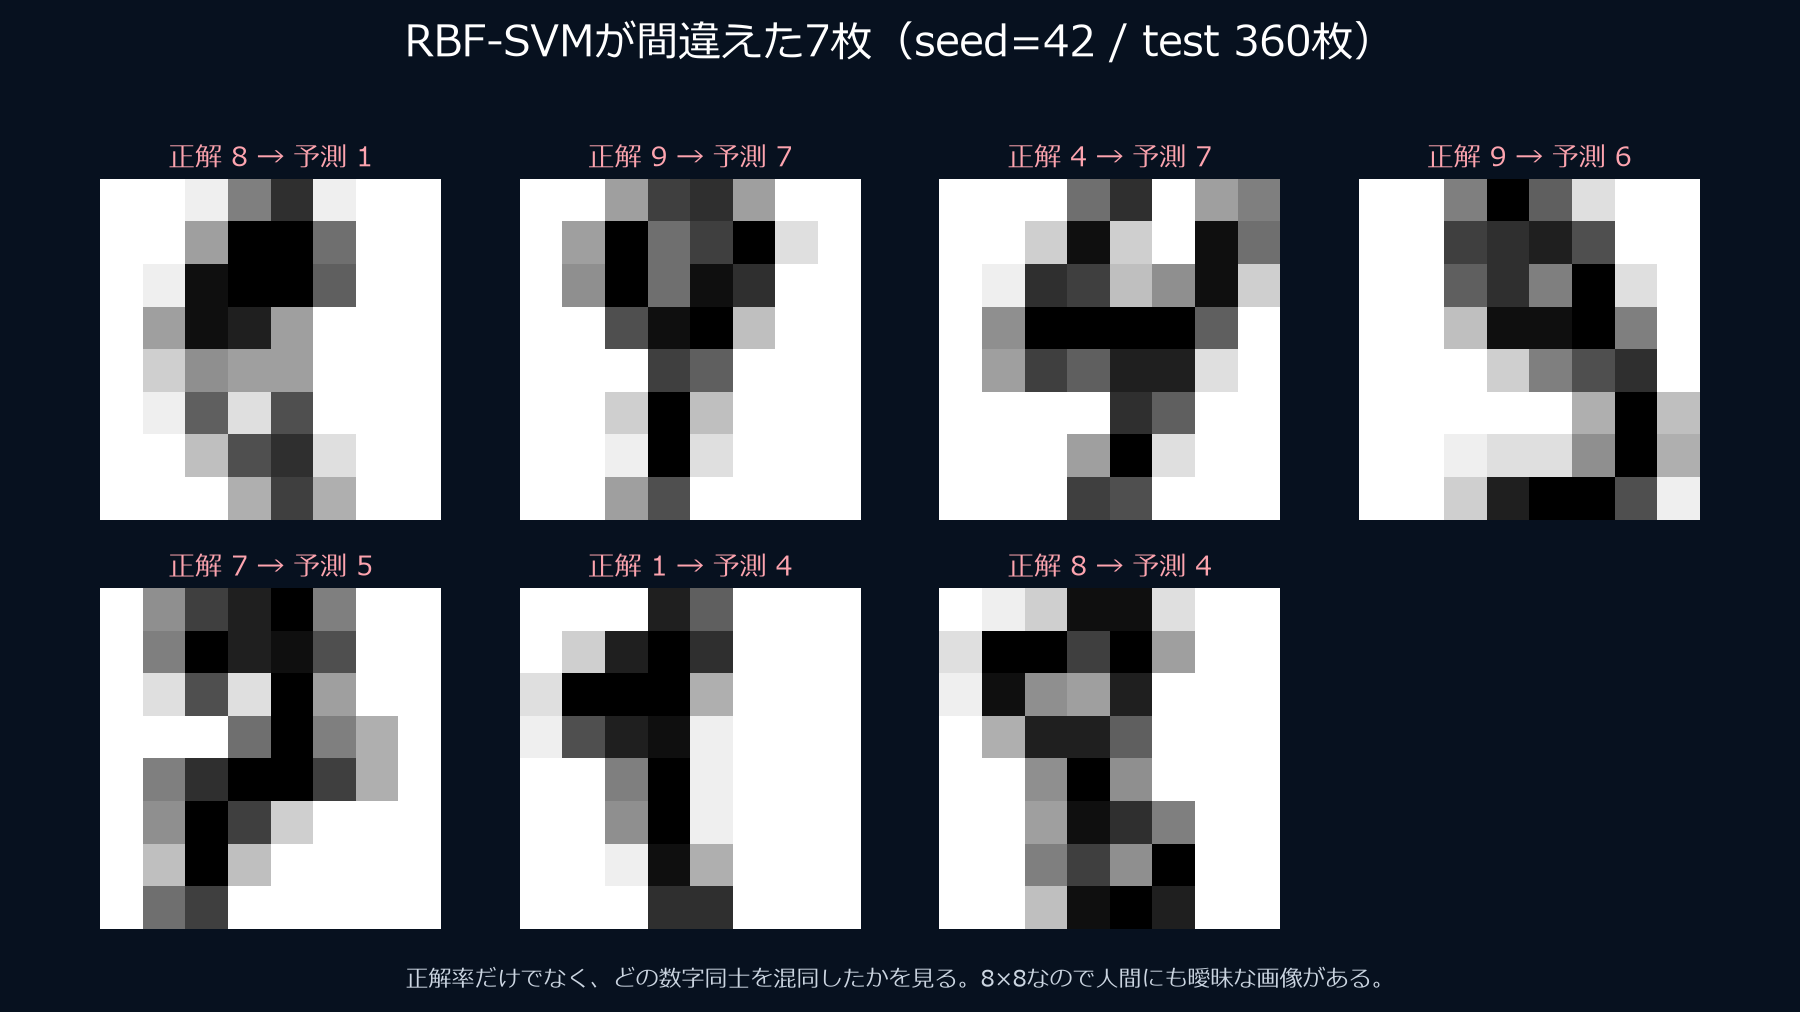
8×8まで縮小された数字は、人間にも曖昧に見えます。ここから「4と7の形状差を表す特徴が弱いのでは」「画素の空間構造を使うCNNなら変わるか」という次の仮説が生まれます。
この規模ではSVMがよく当たった
6通りの分割では、RBF-SVMの平均正解率がロジスティック回帰を約1.02ポイント上回りました。ただ、乱数シード=42の360枚の推論には約20倍の時間がかかっています。速度の差が困る用途かどうかで選び方は変わりそうです。
これは8×8画素のDigitsでの比較です。別の画像やデータ数でも同じ順位になるかは分かりません。同じDigitsをNumPy製のニューラルネットへ入れた実験では、初期値によるばらつきも確認しました。
実行環境と記録ファイル
- 実験コード:
work/ai_lab/experiment_digits_classic.py - 生データ:
work/ai_lab/results/digits_classic.json - 図:
outputs/digits-classic-ml-results.png、outputs/digits-rbf-svm-mistakes.png - Python 3.14.4、scikit-learn 1.9.0、NumPy 2.5.2
- 6 乱数シード、テスト 20%、stratifyあり、Scalerは学習データだけで学習
参考:
