Python 3.14.4 / NumPy 2.5.2
自動微分・深層学習フレームワーク不使用
loss.backward()が計算しているものを追うため、NumPyだけで小さなニューラルネットを書きました。8×8画素のDigitsを入力し、64個の中間ユニットを通して、0〜9のどれかを答える構成です。
逆伝播の実装は、重みを少しずつ動かして求めた数値勾配と照合しました。最大相対誤差は1.08×10⁻⁹。学習も動き、初期値を6通り変えたテスト正解率は平均96.44%でした。
作って確かめた結果
- 構造:64入力 → 64 ReLU → 10 Softmax
- パラメータ数:4,810
- 6種類の重み初期値に対するテスト平均:96.44%
- 標本SD:1.34ポイント
- 最小~最大:93.89~97.78%
- 乱数シード=42:96.39%、誤分類13/360枚
- 勾配チェック最大相対誤差:1.08×10⁻⁹
- pytest:2件合格
前記事の同じDigitsでは、ロジスティック回帰97.04%、RBF-SVM 98.06%でした。つまり、小さなニューラルネットを書いたから古典手法より高精度になるわけではありません。一方、順伝播と逆伝播を自分で追える実装ができ、次のPyTorch比較に使える基準が得られました。
同じデータ分割を使う
古典ML記事との比較を崩さないため、Digits 1,797枚のうち20%を乱数シード=42でテストへ固定しました。残る学習側の10%を検証へ分けます。
| 用途 | 枚数 | 学習に使うか |
|---|---|---|
| 学習 | 1,293 | 重み更新に使用 |
| 検証 | 144 | エポック選択に使用、重み更新には不使用 |
| テスト | 360 | 最後の性能報告だけに使用 |
テスト精度を見ながらエポックを選ぶと、テストセットへ間接的に過適合します。今回は検証正解率が最高になった重みを保存し、テストは最後に一度評価する設計です。
画素値0~16は16で割って0~1へ変換しました。この変換はデータ全体から統計量を学習しないので、平均や標準偏差を使う標準化とは違い、テスト情報の漏洩はありません。
2層ネットワークの順伝播
入力をX、1層目の重みとバイアスをW1, b1、2層目をW2, b2とします。
Z1 = X W1 + b1
H  = ReLU(Z1)
Z2 = H W2 + b2
P  = Softmax(Z2)
配列の形も一緒に追うと、行列積の意味が見えます。
| 値 | 配列の形 | 意味 |
|---|---|---|
| X | (バッチ, 64) | 8×8画像を平坦化 |
| W1 | (64, 64) | 入力から隠れ層への重み |
| H | (バッチ, 64) | ReLU後の中間表現 |
| W2 | (64, 10) | 隠れ層から10クラスへの重み |
| P | (バッチ, 10) | 各クラスの予測確率 |
NumPyコードは次の中心部分だけです。
hidden_pre = x @ w1 + b1
hidden = np.maximum(hidden_pre, 0)
logits = hidden @ w2 + b2

shifted = logits - logits.max(axis=1, keepdims=True)
exp_values = np.exp(shifted)
probabilities = exp_values / exp_values.sum(axis=1, keepdims=True)
Softmaxの前に各行の最大値を引くのは、exp(大きな値)のオーバーフローを避けるためです。最大値を引いてもSoftmaxの比率は変わりません。
交差エントロピー損失
正解クラスの予測確率をpとすると、1サンプルの損失は-log(p)です。
loss = -np.log(
    probabilities[np.arange(sample_count), y] + 1e-12
).mean()
正解に0.9を割り当てれば損失は小さく、0.01なら大きくなります。1e-12はlog(0)を避ける安全策です。
逆伝播を配列の形と一緒に追う
Softmaxと交差エントロピーを組み合わせると、logitsに対する勾配は簡潔になります。
d_logits = probabilities.copy()
d_logits[np.arange(sample_count), y] -= 1
d_logits /= sample_count

d_w2 = hidden.T @ d_logits
d_b2 = d_logits.sum(axis=0)

d_hidden = d_logits @ w2.T
d_hidden[hidden_pre <= 0] = 0

d_w1 = x.T @ d_hidden
d_b1 = d_hidden.sum(axis=0)
逆向きに見ると、出力の誤差をW2.Tで隠れ層へ戻し、ReLUで0以下だった要素の勾配を0にし、さらに入力側へ伝えています。
ここで転置を一つ間違えても、配列の形エラーが出れば気づけます。しかし配列の形が偶然合う誤りもあります。そこで勾配チェックが必要です。
勾配チェックで逆伝播の式を検証する
あるパラメータθの数値勾配は、中心差分で近似できます。
dL/dθ ≈ {L(θ + ε) - L(θ - ε)} / (2ε)
今回はε=1e-5として24個のパラメータ要素をランダムに選び、手計算した解析勾配と比較しました。
checks: 24
max relative error: 1.081566e-09
mean relative error: 1.020951e-10
passed under 1e-5: True
相対誤差は次で計算しています。
|numerical - analytical|
---------------------------------
max(1e-12, |numerical| + |analytical|)
pytestではSoftmaxの各行が1へ合計されることと、別の乱数入力で40要素の勾配が基準内に入ることを自動確認しました。
.. [100%]
2 passed in 1.67s
勾配チェックは非常に遅いため、全パラメータ4,810個へ毎エポック実行するものではありません。小さな入力と一部要素で、実装変更時の検査に使います。
He初期化とReLU
重みをすべて0にすると、同じ層のユニットが同じ出力・同じ勾配になり、役割を分担できません。今回はReLU向けに標準偏差sqrt(2 / fan_in)の正規乱数で初期化しました。
w1 = rng.normal(0, np.sqrt(2 / input_size), (input_size, hidden_size))
この初期値乱数シードを0、1、2、3、4、42へ変えました。データ分割は固定なので、重み初期値とミニバッチ順序の違いを観測しています。
モメンタム付きミニバッチSGD
初回は単純SGD、学習率0.12で実験し、6初期値平均95.09%でした。勾配チェックは合格しているため、逆伝播の式ではなく最適化条件の影響を疑いました。
そこでテスト値を調整基準にせず、検証の収束を見てモメンタム0.9、学習率0.05へ変更しました。
velocity[key] = 0.9 * velocity[key] - 0.05 * gradient[key]
parameter[key] += velocity[key]
モメンタムは過去の更新方向を蓄え、勾配が同じ方向へ続くと進みやすく、往復する方向では揺れを抑えます。変更後の平均は96.44%へ上がりました。
early stoppingと検証の弱点
最大240エポック、検証が40エポック更新されなければ停止し、最良検証時点の重みを復元しました。
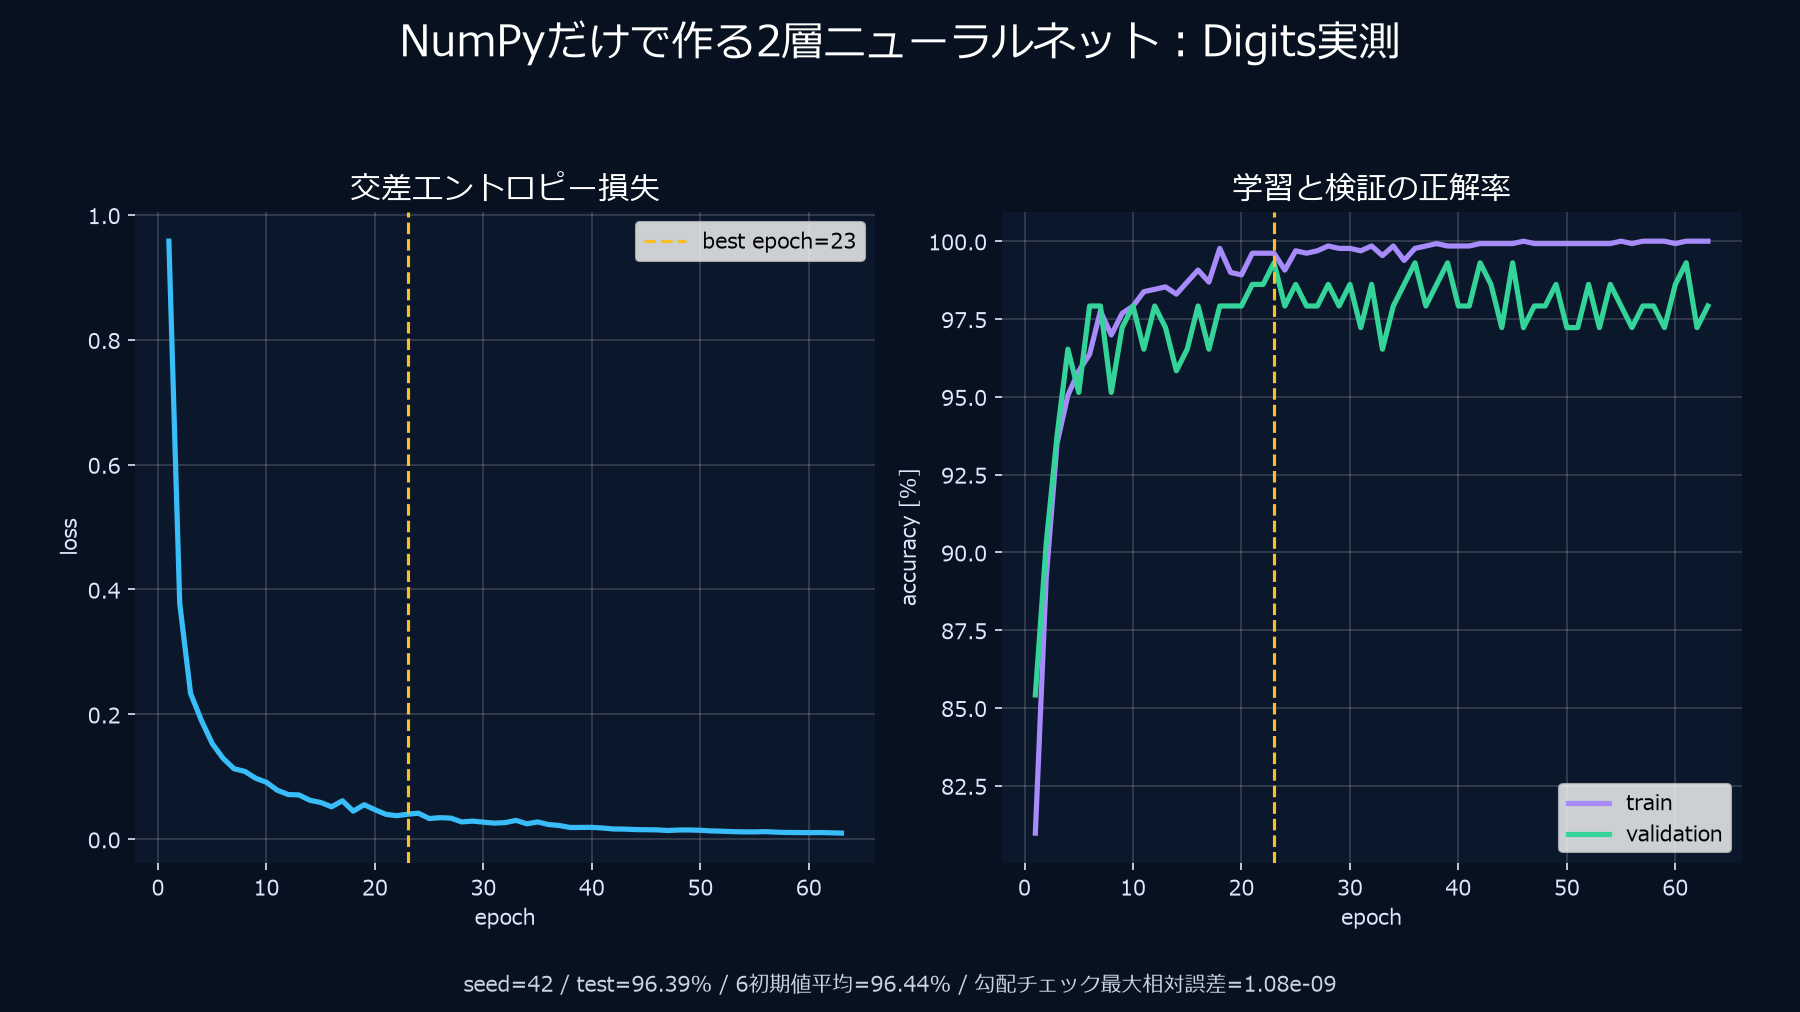
乱数シード=42ではエポック 23が最良で、検証 99.31%、テスト 96.39%でした。グラフでは学習がほぼ100%へ上がる一方、検証は97~99%の間で揺れています。
さらに乱数シード=3は検証 99%でもテスト 93.89%でした。検証が144枚しかないため、1枚の正誤で約0.69ポイント変わります。検証が高いことは、未知データ性能の保証ではありません。
検証用の画像が少ないので、ここでの順位は数枚の正誤でも変わります。初期値だけでなく、データの分け方を変えた場合も別に確かめる必要があります。
6初期値の実測結果
| 乱数シード | best エポック | 検証 | テスト | 誤分類 |
|---|---|---|---|---|
| 0 | 39 | 99.31% | 97.22% | 10 |
| 1 | 11 | 97.92% | 96.67% | 12 |
| 2 | 26 | 99.31% | 97.78% | 8 |
| 3 | 4 | 98.61% | 93.89% | 22 |
| 4 | 26 | 99.31% | 96.67% | 12 |
| 42 | 23 | 99.31% | 96.39% | 13 |
初期値だけでテスト正解率が93.89〜97.78%まで変わりました。平均は96.44%、標本標準偏差は1.34ポイントです。
古典MLとの比較
| モデル | テスト条件 | 平均正解率 |
|---|---|---|
| ロジスティック回帰 | 6種類のデータ分割 | 97.04% |
| RBF-SVM | 6種類のデータ分割 | 98.06% |
| NumPy 2層NN | 固定データ分割・6初期値 | 96.44% |
乱数を変えた対象が違うため、標準偏差を直接比較して優劣は決められません。古典ML記事はデータ分割の揺らぎ、本記事は重み初期値の揺らぎです。ただし固定乱数シード=42の同じテスト 360枚では、ロジスティック97.0%、SVM 98.06%、NumPy NN 96.39%でした。
このDigitsの比較ではSVMがよく当たりました。ニューラルネットを使うだけで正解率が上がるわけではありませんでした。
自動微分へ移す前の確認
この実装では、逆伝播の式を数値勾配と照合できました。一方、検証正解率が高い初期値でも、テストで同じ順位になるとは限りませんでした。勾配の計算が合っているかと、未知の画像を分類できるかは、それぞれ確認が要ります。
同じ重みをPyTorchへコピーして自動微分と比べた結果も載せています。NumPy側の行列と対応させると、loss.backward()がどの計算を引き受けているか追えます。
実行環境と記録ファイル
- 実装:
work/ai_lab/experiment_digits_numpy_nn.py - テスト:
work/ai_lab/test_numpy_nn.py - 生データ:
work/ai_lab/results/digits_numpy_nn.json - 図:
outputs/digits-numpy-nn-training.png - 実行環境:Python 3.14.4、NumPy 2.5.2
- pytestと学習は
/opt/ai-lab/venvで実行
