環境: RTX 5070 Ti 16GB / WSL2 / Ollama 0.32.15 / Python 3.13 / pytest 8.4.1
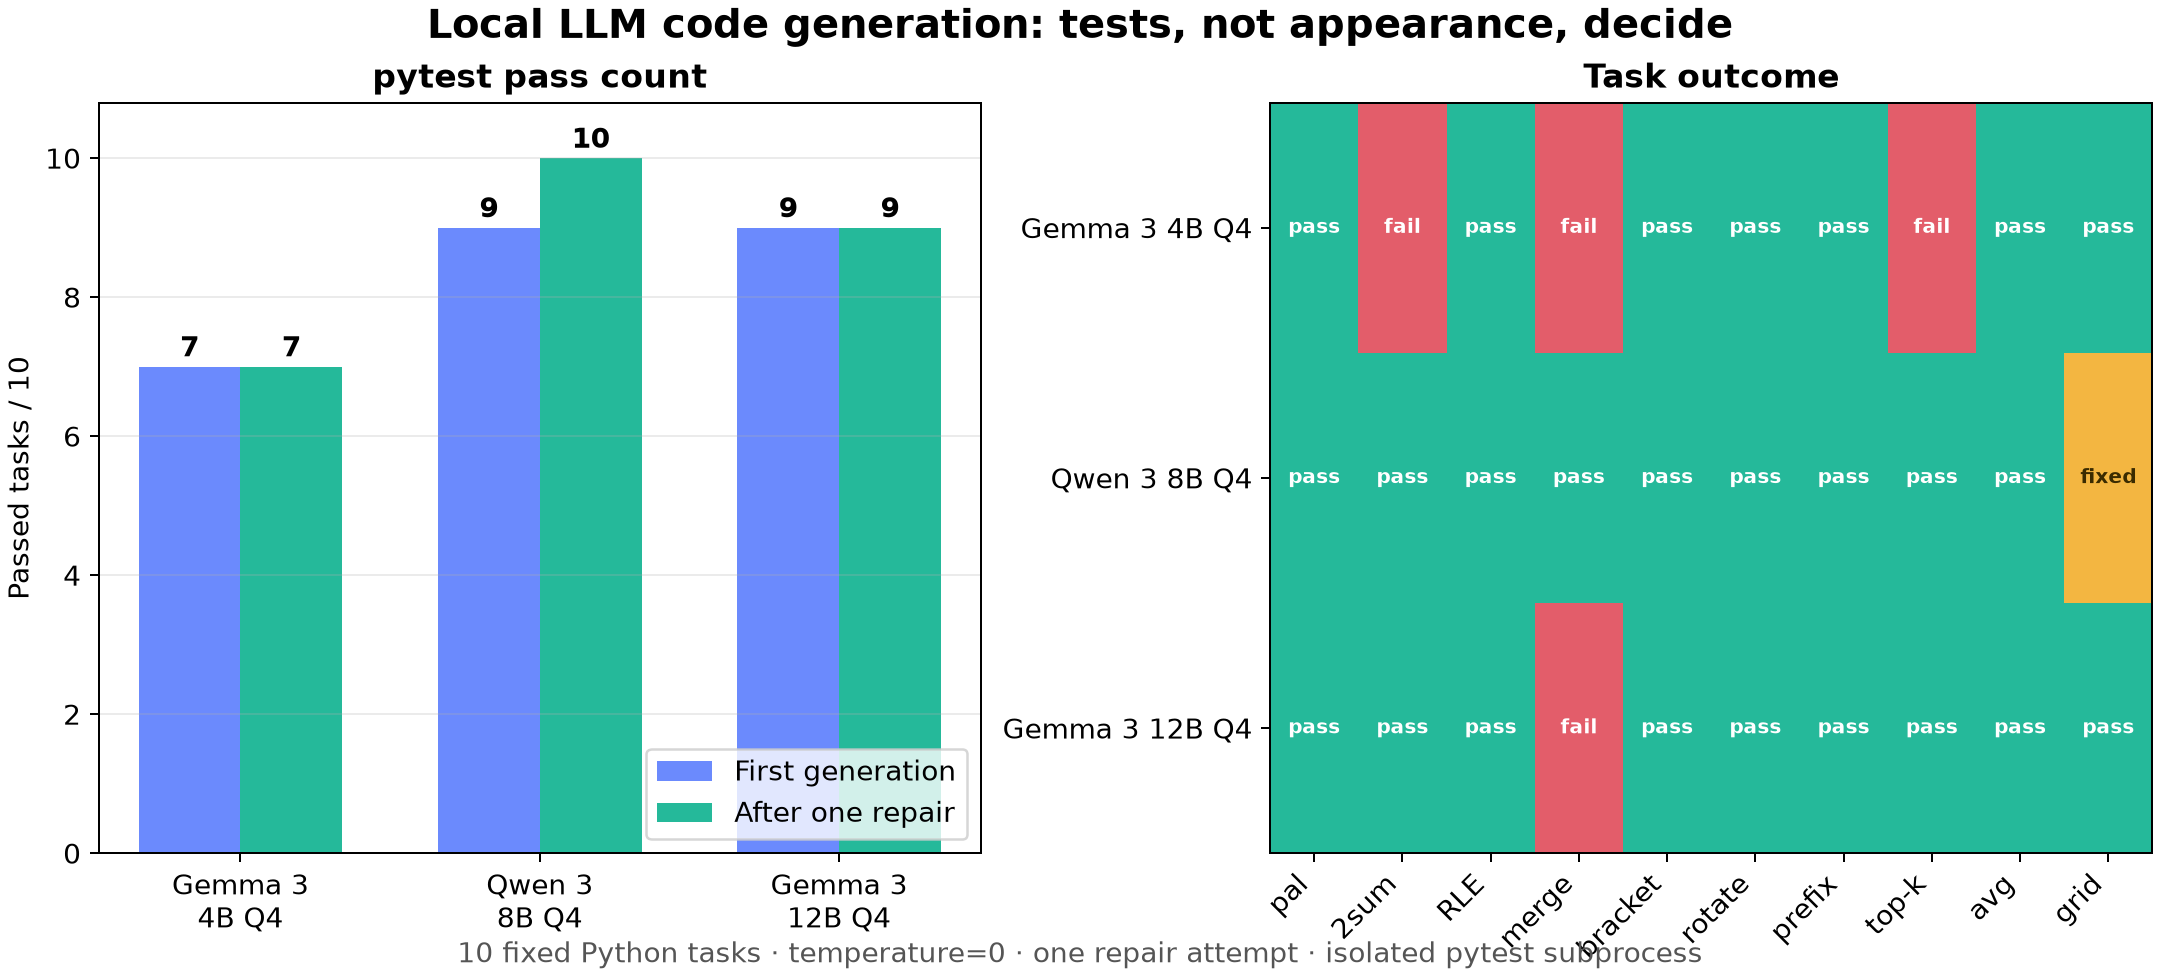
ローカルLLMにPythonの関数を10個書かせ、pytestで動かしました。Gemma 3 4Bは7問、Qwen 3 8BとGemma 3 12Bは9問が初回で合格しました。
失敗したコードへテスト結果を一度だけ返すと、8Bは10問すべて通るようになりました。4Bと12Bの合格数は変わりません。返り値が合っていても元の入力を書き換える、といった見落としが残りました。
pytestを通した結果
| モデル | 初回合格 | 1回修正後 | 修正成功/試行 | 安全検査reject |
|---|---|---|---|---|
| Gemma 3 4B Q4 | 7/10 | 7/10 | 0/3 | 0 |
| Qwen 3 8B Q4 | 9/10 | 10/10 | 1/1 | 1 |
| Gemma 3 12B Q4 | 9/10 | 9/10 | 0/1 | 0 |
重要なのはモデル rankingより、評価方法です。
- プロンプトを固定する
- testcaseを生成後に都合よく変えない
- syntaxを解析し、実行前に危険な構造を弾く
- テストをtimeout付きの別プロセスで動かす
- 初回と修正後を混ぜずに記録する
- 未加工のコード、pytest出力、条件を保存する
3問を1回試すだけでは、別のモデルと比べるときに条件がずれます。プロンプト、testcase、実行方法、未加工の出力を残しておけば、同じ条件で試し直せます。
なぜコード評価に人間の見た目だけでは足りないか
例えば次の関数は、一見それらしくintervalをmergeします。
def merge_intervals(intervals):
    intervals.sort()
    merged = []
    for interval in intervals:
        if not merged or merged[-1][1] < interval[0]:
            merged.append(interval)
        else:
            merged[-1][1] = max(merged[-1][1], interval[1])
    return merged
しかし仕様が「入力を変更しない」なら不合格です。sort()はlistの順序を変え、mergedに元の内側listを入れてendを書き換えるため、入力データまで破壊します。
実際に4Bと12Bはこの落とし穴で失敗しました。返り値だけ確認するテストなら合格していたはずです。ソフトウェアのcorrectnessは出力値だけでなく、side effect、例外、境界値を含む契約で決まります。
10問は何を測ったか
単なる同型問題にならないよう、10種類を固定しました。
| 課題 | 主な確認点 |
|---|---|
| palindrome | 正規化、空文字、大小文字 |
| two sum | 2引数、インデックス、同一要素の再利用禁止 |
| run-length encoding | tuple形式、case保持、空入力 |
| interval merge | sort、接触区間、入力非破壊 |
| balanced brackets | stack、3種類、他文字を無視 |
| matrix 回転 | 長方形、1行・1列、入力非破壊 |
| common 接頭辞 | 空list、空文字、case-sensitive |
| top-k frequency | 頻度tieを数値昇順で解決 |
| moving average | 浮動小数、invalid windowで例外 |
| grid shortest path | BFS、blocked、到達不能、start=goal |
各課題は4~6個のassertを持ちます。ただし10問は統計的に小さく、一般的なcoding能力を代表するベンチマークではありません。今回の目的は、自分の研究用課題へ持ち込める評価処理の流れを示すことです。
モデルと生成条件を固定する
比較したモデルです。
gemma3:4b-it-q4_K_M
qwen3:8b
gemma3:12b
共通条件です。
temperature 0
seed 42
think false
num_ctx 4096
num_predict 512
repair attempts 1
pytest timeout 10 s
Ollamaの/api/generateへ同じシステム指示と課題 specificationを送りました。temperature 0でもバックエンドやモデルバージョンが変われば完全再現を保証できないため、モデル tag、Ollama バージョン、応答全文も残します。
システム指示の要点です。
Return only one Python code block.
Define exactly the requested function.
Use only Python built-ins; no imports, I/O, network, subprocess,
dynamic execution, global state, or top-level executable statements.
「安全なコードを」と曖昧に頼むのではなく、実行環境で許す範囲を列挙しました。
生成コードをいきなり実行しない
LLMのコードはuntrusted 入力として扱いました。最初にMarkdown fenceを除き、Pythonのast.parseでsyntax treeへ変換します。
今回の簡易gateは次を拒否します。
import / import from
class定義
global / nonlocal
指定外のfunction
top-levelの実行文
eval, exec, open, compile, __import__, input
globals, locals, vars, getattr, setattr, delattr
dunder attribute access
top-levelには、指定された関数定義と定数docstringだけを許しました。
tree = ast.parse(code)

for node in ast.walk(tree):
    if isinstance(node, (ast.Import, ast.ImportFrom, ast.ClassDef)):
        raise ValueError(type(node).__name__)
これは完全なsandboxではありません。Pythonの静的AST検査だけで、CPU消費、メモリ消費、巧妙なobject traversalを完全には防げません。今回は自分のoffline PC、ネットワークを使わない小関数、10秒timeoutという限定条件です。他人のコードをmulti-tenant serverで動かす防壁にはなりません。
pytestは別プロセス・別ディレクトリで動かす
安全検査を通ったコードとテストだけを課題別ディレクトリへ置きます。
generated_code/
  qwen3_8b/
    shortest_path_grid/
      candidate.py
      candidate_first.py
      candidate_repaired.py
      test_candidate.py
実行commandです。
python -m pytest -q --disable-warnings --maxfail=1
Pythonからはsubprocess.run(..., timeout=10)で起動します。pytestの標準的な起動方法に沿いつつ、1 失敗で止めることで修正feedbackを短くしました。
プロセスを分ける理由は、main evaluatorへモジュールキャッシュや例外状態を持ち込まないためです。ただしOS-level isolationではないため、信頼できない第三者コードならcontainer、VM、resource limit、ネットワーク namespace等が別途必要です。
初回結果:4B 7問、8Bと12Bは9問
課題別の初回結果です。
| 課題 | 4B | 8B | 12B |
|---|---|---|---|
| palindrome | pass | pass | pass |
| two sum | fail | pass | pass |
| RLE | pass | pass | pass |
| interval merge | fail | pass | fail |
| brackets | pass | pass | pass |
| matrix 回転 | pass | pass | pass |
| common 接頭辞 | pass | pass | pass |
| top-k | fail | pass | pass |
| moving average | pass | pass | pass |
| grid shortest path | pass | reject | pass |
8Bのgridだけはalgorithmの誤りではなく、from collections import dequeを含んだため実行前にrejectしました。標準ライブラリでも、今回は「built-insのみ」という実験契約違反です。
4Bは仕様を「実装し直して」しまった
4Bのtwo_sumとtop_k_frequentは、要求された2引数関数ではなく1引数関数を生成しました。
TypeError: two_sum() takes 1 positional argument but 2 were given
TypeError: top_k_frequent() takes 1 positional argument but 2 were given
自然言語仕様には関数signatureを明記していました。それでもモデルは独自interfaceを作ったため、function名だけでなく引数をテストから実際に呼ぶ必要があります。
これは研究コードで特に危険です。モデルが「改善」のつもりでAPIを変え、呼び出し側と噛み合わなくても、コード単体は整って見えるからです。
4Bと12Bは入力の書き換えを見落とした
merge_intervalsでは返り値のassertは通過し、その次で落ちました。
x = [[1,3],[2,6],[8,10],[10,12],[15,18]]
before = [row[:] for row in x]

assert merge_intervals(x) == [[1,6],[8,12],[15,18]]
assert x == before
pytestの差分は先頭が[1,3]から[1,6]へ変わったことを示しました。仕様の「do not mutate the 入力」は飾りではなく、テスト可能なpostconditionです。
修正例は、sort前とmerge時に新しいlistを作ることです。
ordered = sorted([row[:] for row in intervals])
1回のエラーのフィードバックで直ったのは1件だけ
初回不合格には、元仕様とpytestのstdout/stderrを返しました。追加の自由な会話はせず、修正コードだけを要求します。
The previous implementation failed validation.
Return a complete corrected implementation.

Original specification: ...
Validation feedback: ...
Qwen 3 8Bはdeque 読み込みを削除し、built-in listをキューとして使うBFSへ直して合格しました。
一方、4Bの3件と12Bの1件は、同じwrong signatureや入力の書き換えを再生成して不合格でした。エラーログを与えただけでは、モデルが失敗の根本原因を理解して修正するとは限りません。
実運用なら、repairを無制限に繰り返すのではなく上限を設け、人間確認へ送るべきです。今回の1回制限は、モデル間でretry 予算を揃える意味もあります。
「安全検査で落ちた」と「テストで落ちた」を分ける
8Bの初回はコードを実行していません。これをpytest 失敗と同一視すると、algorithm 正解率とpolicy complianceが混ざります。
結果JSONでは別のfieldに保存しました。
{
  "first_safe": false,
  "first_safety_message": "Blocked AST node: ImportFrom",
  "first_test": {
    "passed": false,
    "stderr": "Blocked AST node: ImportFrom"
  },
  "final_passed": true
}
研究評価では少なくともsyntax 失敗、policy rejection、テスト assertion 失敗、timeout、infrastructure errorを分離すると、改善すべき場所が分かります。
この実験から言えないこと
10問、各モデル 1 乱数シードなので、8Bが一般に12Bよりcoding能力が高いとは言えません。モデル系列も違います。HumanEvalやMBPPの公式スコアとも比較できません。
testcaseも完全ではありません。合格は「この公開テストを通った」であり、全入力に正しい証明ではありません。LLMがテスト内容をプロンプトで見てrepairしているため、未知テストへのgeneralizationも別に測る必要があります。
より強い評価にするなら次を追加します。
- hidden テストをrepair プロンプトから隠す
- property-based testingで入力を生成する
- 課題数と乱数シード数を増やしconfidence intervalを出す
- mutation testingで弱いテストを検出する
- ランタイムとメモリ使用量も採点する
- human-written 比較の基準と比較する
再現手順
リポジトリ内のスクリプトは課題、テスト、プロンプト、AST gate、repair、保存まで含みます。
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments
/opt/ai-lab/venv/bin/python -u work/ai_lab/experiment_llm_codegen_pytest.py
/opt/ai-lab/venv/bin/python work/ai_lab/plot_llm_codegen_pytest.py
主な生成されるファイルは次のとおりです。
work/ai_lab/experiment_llm_codegen_pytest.py
work/ai_lab/results/llm_codegen_pytest.json
work/ai_lab/generated_code/
work/ai_lab/plot_llm_codegen_pytest.py
work/figures/llm-codegen-pytest.png
JSONには30 生成すべてについて、元応答、抽出コード、安全検査結果、pytest stdout/stderr、実経過時間、修正応答を保存しました。成功数だけでなく失敗例を残すと、後でテストやプロンプトを改善できます。
返り値だけのテストでは見逃す
今回の失敗には、返り値は合っていても引数のリストを書き換えるコードがありました。元の入力を保存して比較するテストがなければ、これも合格に見えてしまいます。
また、エラーログを一度返して直ったのは1件だけでした。修正後も同じテストを動かし、禁止した操作が増えていないかを見る必要があります。ここでの10問は小さな関数なので、大きなプログラムでも同じ合格率になるとは考えていません。
