環境: RTX 5070 Ti 16GB / WSL2 / Ollama 0.32.15 / Qwen 3 8B Q4
このPCで測った速度やVRAMの値をQwen 3 8Bへ尋ねても、当然ながら、その実験の記録を渡さなければ答えられません。そこで自作記事13本を検索対象にし、質問に近い箇所を拾ってから回答させました。
用意した20問では、検索なしの0問正解から、検索ありの19問正解へ増えました。残った1問は記事自体を見つけていたのに、答えの数値がある段落を渡せていませんでした。この失敗も含めて見ていきます。
0問から19問へ増えた
| 指標 | 結果 |
|---|---|
| 検索なしの数値正解 | 0/20 |
| RAGの数値正解 | 19/20 |
| 期待出典が順位 1 | 17/20 |
| 期待出典がtop 3内 | 20/20 |
| 期待出典を回答で引用 | 19/20 |
| 平均回答時間:検索なし | 0.316秒 |
| 平均回答時間:RAG | 0.376秒 |
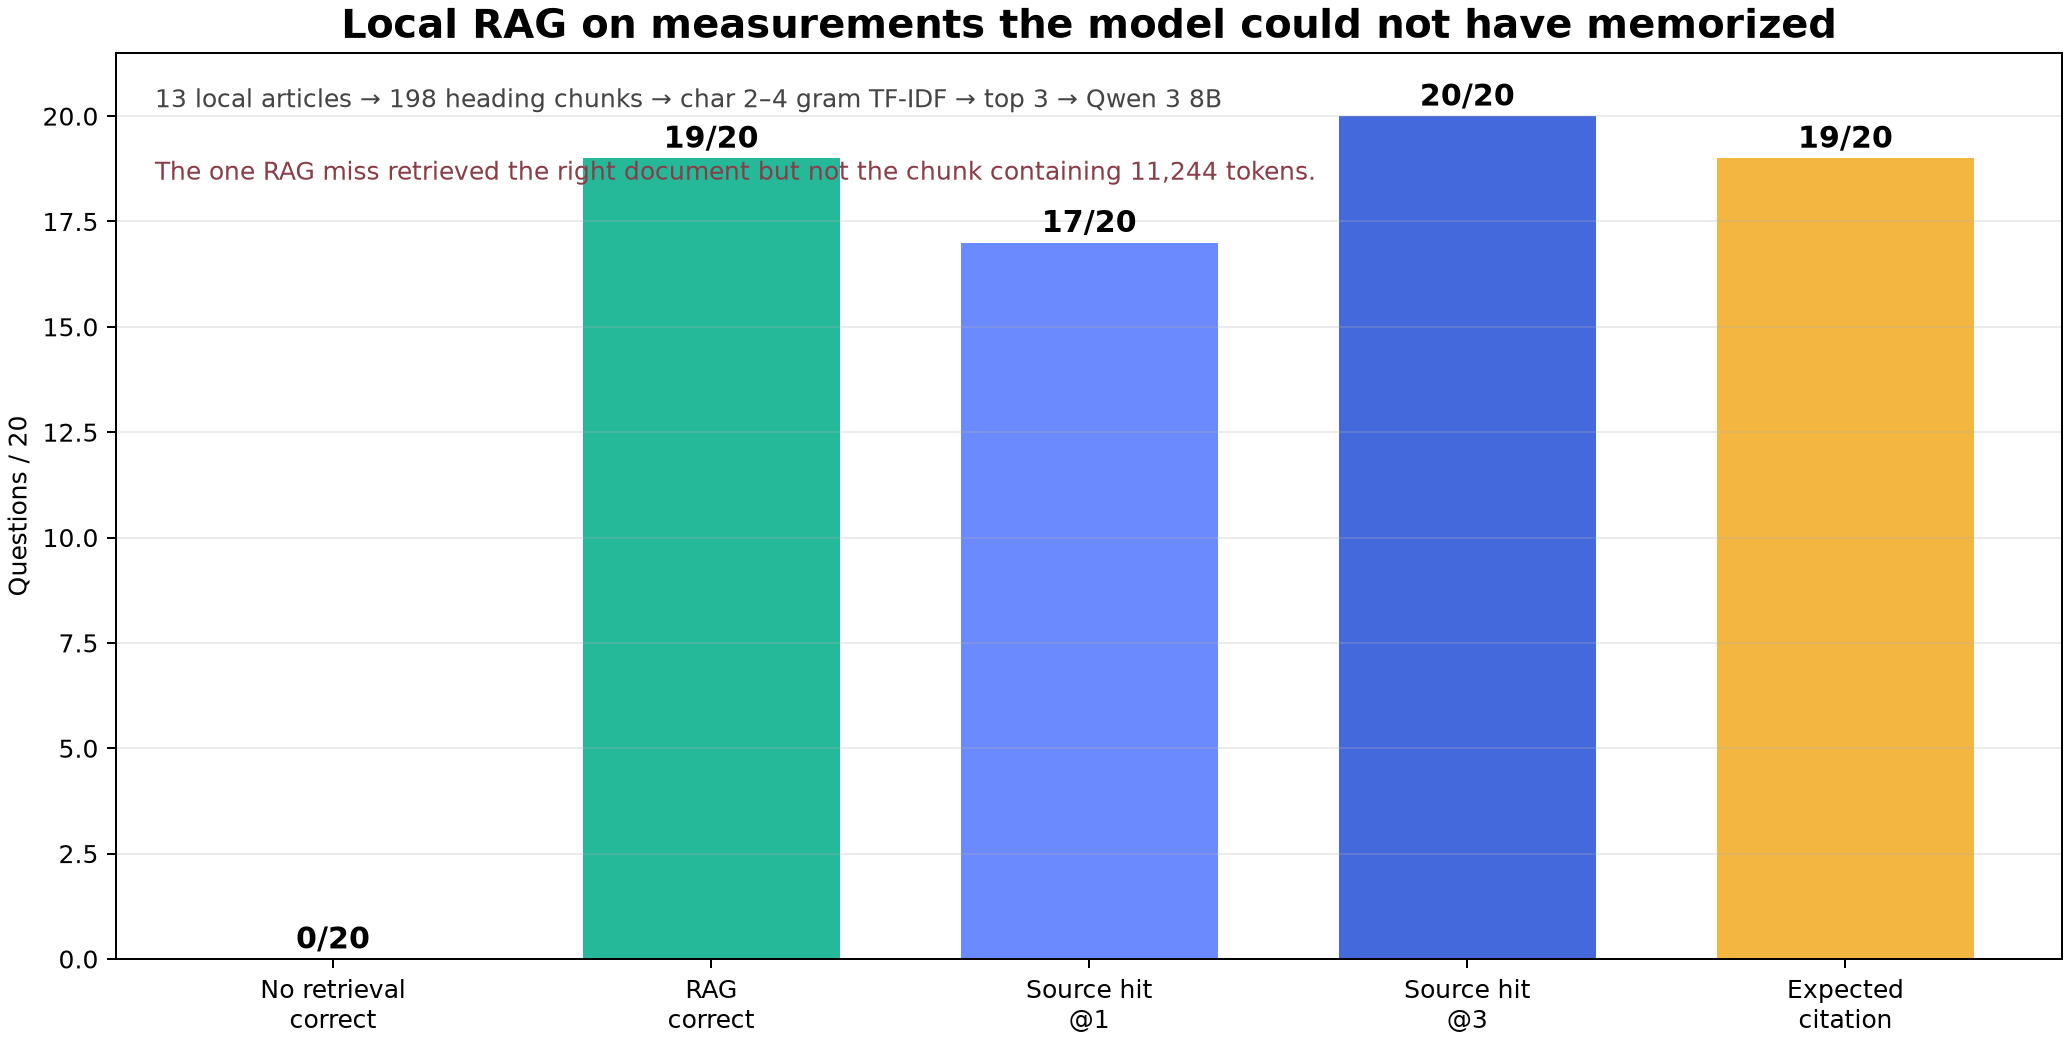
数値の正誤は正規表現で採点しました。検索結果に目的の記事が含まれるかと、回答に必要な数値が出るかを別々に数えています。
RAGとは何を追加する仕組みか
RAGはRetrieval-Augmented Generationの略です。質問を受けてから外部資料を検索し、関連部分をLLMのプロンプトへ追加して回答させます。
user question
    ↓
retriever ──→ top-k chunks
    ↓              ↓
    └──── promptへ結合
                   ↓
              local LLM
                   ↓
          answer + source ID
モデルのパラメータを再学習する追加学習とは違い、文書を差し替えれば新しい情報へ更新できます。反対に、検索で取得しなかった情報はプロンプトに入りません。
RAGの評価を1個の「回答正解率」だけにすると、どこが壊れたか分かりません。今回は次を分けました。
retrieval hit@1 : 正解sourceが1位か
retrieval hit@3 : 正解sourceが上位3件にあるか
answer accuracy : 必要な数値を回答したか
citation check  : 期待source IDを引用したか
latency         : generationに何秒かかったか
モデルが知らない20問を作る
質問には、このPCで測って記事に記録した値を使いました。
12BモデルのGPU peak使用量は何GiBだった?
context 16384条件で実際のprompt token数はいくつ?
code生成でQwen 3 8Bは初回と修正後に何問合格した?
batch 8192のpeak allocatedは約何MiB?
HOG+SVMとCNNのtest accuracyをそれぞれ答えて。
一般的な「日本の首都」や「逆伝播とは」を使いません。既存知識で正答すると、検索が効いたのか判別できないからです。
20問には正解出典と受理する数値パターンを事前に固定しました。例えば12BのTruthfulQA 両順序正解率なら73.0を要求します。ファイルサイズのように回答が3.1095 GiBから3.11 GiBへ丸められても意味が同じ場合は、両方を受理しました。
最初の動作確認回では、3.11や4.64まで誤答にするほどパターンが厳しすぎると分かりました。意味が変わらない丸めを許すパターンに直し、20問をすべて再実行しています。
検索対象文書は13記事、198 チャンク
対象は、これまで作ったローカル LLM、PyTorch、FashionMNISTなどのMarkdown 13本です。
13 documents
198 heading chunks
各## 見出しをチャンク境界にしました。固定長で800文字ごとに切る方法より、1つの話題を保ちやすいからです。画像記法を除き、1 チャンクの上限を3,500文字にしました。
parts = re.split(r"(?=^##\s+)", text, flags=re.M)

for i, part in enumerate(parts):
    chunks.append({
        "id": f"{path.name}#{i}",
        "source": path.name,
        "text": clean[:3500],
    })
出典 IDにファイル名とチャンク番号を持たせると、LLMの引用元を元文書へ戻せます。実運用では見出し名、URL、更新日、アクセス権限も付加情報へ入れます。
日本語を2〜4文字に分けて検索する
最初の検索器にはscikit-learnのTfidfVectorizerを使いました。
vectorizer = TfidfVectorizer(
    analyzer="char_wb",
    ngram_range=(2, 4),
    min_df=1,
    sublinear_tf=True,
)
日本語は英語のように空白で単語が分かれません。単語単位の分割をそのまま使うと分割が粗くなるため、2~4文字の連続部分を特徴量にしました。Qwen 3 8B、batch 8192、GPU peakのような英数字も部分一致します。
TF-IDFは、文書内で多い語の出現頻度と、検索対象文書全体で珍しい語の逆文書頻度を組み合わせます。全記事に出る「実験」より、特定記事に出るTruthfulQAや8192を強く扱えます。
検索文ベクトルと198 チャンクの疎なベクトルの内積を取り、スコア上位3件を選びました。
qvec = vectorizer.transform([question])
scores = (matrix @ qvec.T).toarray().ravel()
top_idx = np.argsort(scores)[::-1][:3]
ベクトルをL2正規化する既定設定なので、内積はコサイン類似度として解釈できます。
プロンプトは「資料だけ」「無ければ無い」と指定
RAG プロンプトです。
提供資料だけを根拠に質問へ簡潔に答えてください。
最後に根拠のchunk IDを角括弧で1つ以上引用してください。
資料に無ければ「資料内に記載なし」と答えてください。

資料:
[article_...md#4]
...

質問: ...
比較用の検索なしプロンプトにも「分からなければ不明」「推測で数値を作らない」と入れました。両条件はtemperature 0、乱数シード 42、think:false、num_predict:120で揃えています。
検索なしでは20問とも正解しませんでした。このPCの測定値はモデルの事前学習に含まれないため、記事を渡す効果を確認できます。
RAGは19/20へ改善した
成功例です。
質問:
12BモデルのGPU peak使用量は何GiBだった?

回答:
9.7GiB [article_ollama_4b_8b_12b.md#4]
この質問では期待出典は検索順位 2でした。順位 1は別の量子化記事でしたが、top 3を全て渡したため正答できました。
別の例です。
質問:
code生成で4Bの修正後合格数はいくつ?

回答:
7/10 [article_llm_codegen_pytest.md#1]
これも期待出典は順位 2です。hit@1が17/20でも回答が19/20なのは、top-kを3にした効果です。
記事は当たったのに、数値の段落を取り逃した
失敗した質問です。
context 16384条件で実際のprompt token数はいくつ?
検索順位 1は正しいarticle_ollama_context_4k_8k_16k.mdでした。しかし選ばれた3 チャンクは#2、#15、#10で、11,244が書かれたチャンクを含みませんでした。
LLMの回答は次です。
資料内に記載なし
正解には届きませんでしたが、資料にない数値を作って答えることはありませんでした。少なくともこの質問では、「資料内に無ければそう答える」という指示に従っています。
一方、「正しい文書が1位だから検索成功」とだけ集計すると、この失敗を見落とします。LLMが読む単位は文書ではなく渡されたチャンクです。記事単位の一致と根拠部分の一致を分ける必要があります。
答えのある段落まで拾うには
この失敗では、記事を探すところまではできています。前後の段落も渡す、上位3件を5件に増やす、見出しと記事名を各チャンクへ付ける、といった変更が候補です。ただし、この実験では改善するかどうかをまだ測っていません。
渡す文章を増やせば無関係な箇所も増えます。件数を増やしただけで直ったとせず、11,244のある段落が実際に入り、回答も変わったかを確かめる必要があります。
引用先の本文も確かめる
想定した出典を引用した回答は19/20でした。ただ、出典IDが書かれているだけでは、その文章が回答を裏付けているとは限りません。
今回は数値と出典IDを照合しています。自由記述の回答なら、引用先にその主張が書かれているか、回答の一部だけに根拠が付いていないかも本文を読んで確かめます。
平均0.06秒の増加をどう読むか
平均実経過時間は検索なし0.316秒、RAG 0.376秒でした。約0.06秒増です。
この値は検索計算を含む処理全体の待ち時間ではなく、スクリプトがOllama generate リクエストを送ってから応答を受け取る時間です。TF-IDF検索は小規模検索対象文書で非常に短く、今回は個別計測していません。
RAG プロンプトはtop 3 チャンク分長いため入力文の処理が増えます。検索対象文書が100万チャンクになればインデックス検索やネットワーク、ストレージも効きます。この13記事の値を大規模システムへ外挿できません。
再現手順
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments
/opt/ai-lab/venv/bin/python -u work/ai_lab/experiment_local_rag.py
/opt/ai-lab/venv/bin/python work/ai_lab/plot_local_rag.py
生成されるファイルは次のとおりです。
work/ai_lab/experiment_local_rag.py
work/ai_lab/results/local_rag.json
work/ai_lab/plot_local_rag.py
work/figures/local-rag-tfidf-qwen3.png
JSONには全20問について、期待パターン、期待出典、top 3 チャンク本文とスコア、検索なし回答、RAG回答、正誤、引用元、実経過時間を保存しています。集計値だけでなく、唯一の失敗を再調査できます。
