環境: RTX 5070 Ti 16GB / WSL2 / Ollama 0.32.15 / EmbeddingGemma / Qwen 3 8B
記事13本を検索するRAGの検索部分を、TF-IDFからEmbeddingGemmaへ替えてみました。同じ20問を使うと、回答の正解数は19問から16問へ減りました。
今回探しているのは、バッチ数やVRAMなどの具体的な測定値です。文章の意味が近くても、欲しい数字が書かれた箇所とは限りません。検索結果を並べて、改善した質問と取りこぼした質問を確認します。
今回はTF-IDFが勝った
| 指標 | TF-IDF | EmbeddingGemma |
|---|---|---|
| 正解出典が1位 | 17/20 | 17/20 |
| 正解出典が上位3件以内 | 20/20 | 19/20 |
| 記事単位のMRR | 0.925 | 0.9125 |
| 平均検索時間 | 1.03 ms | 496.2 ms |
| インデックス作成 | 0.189秒 | 12.45秒 |
| 同じQwen 3 8BのRAG正解 | 19/20 | 16/20 |
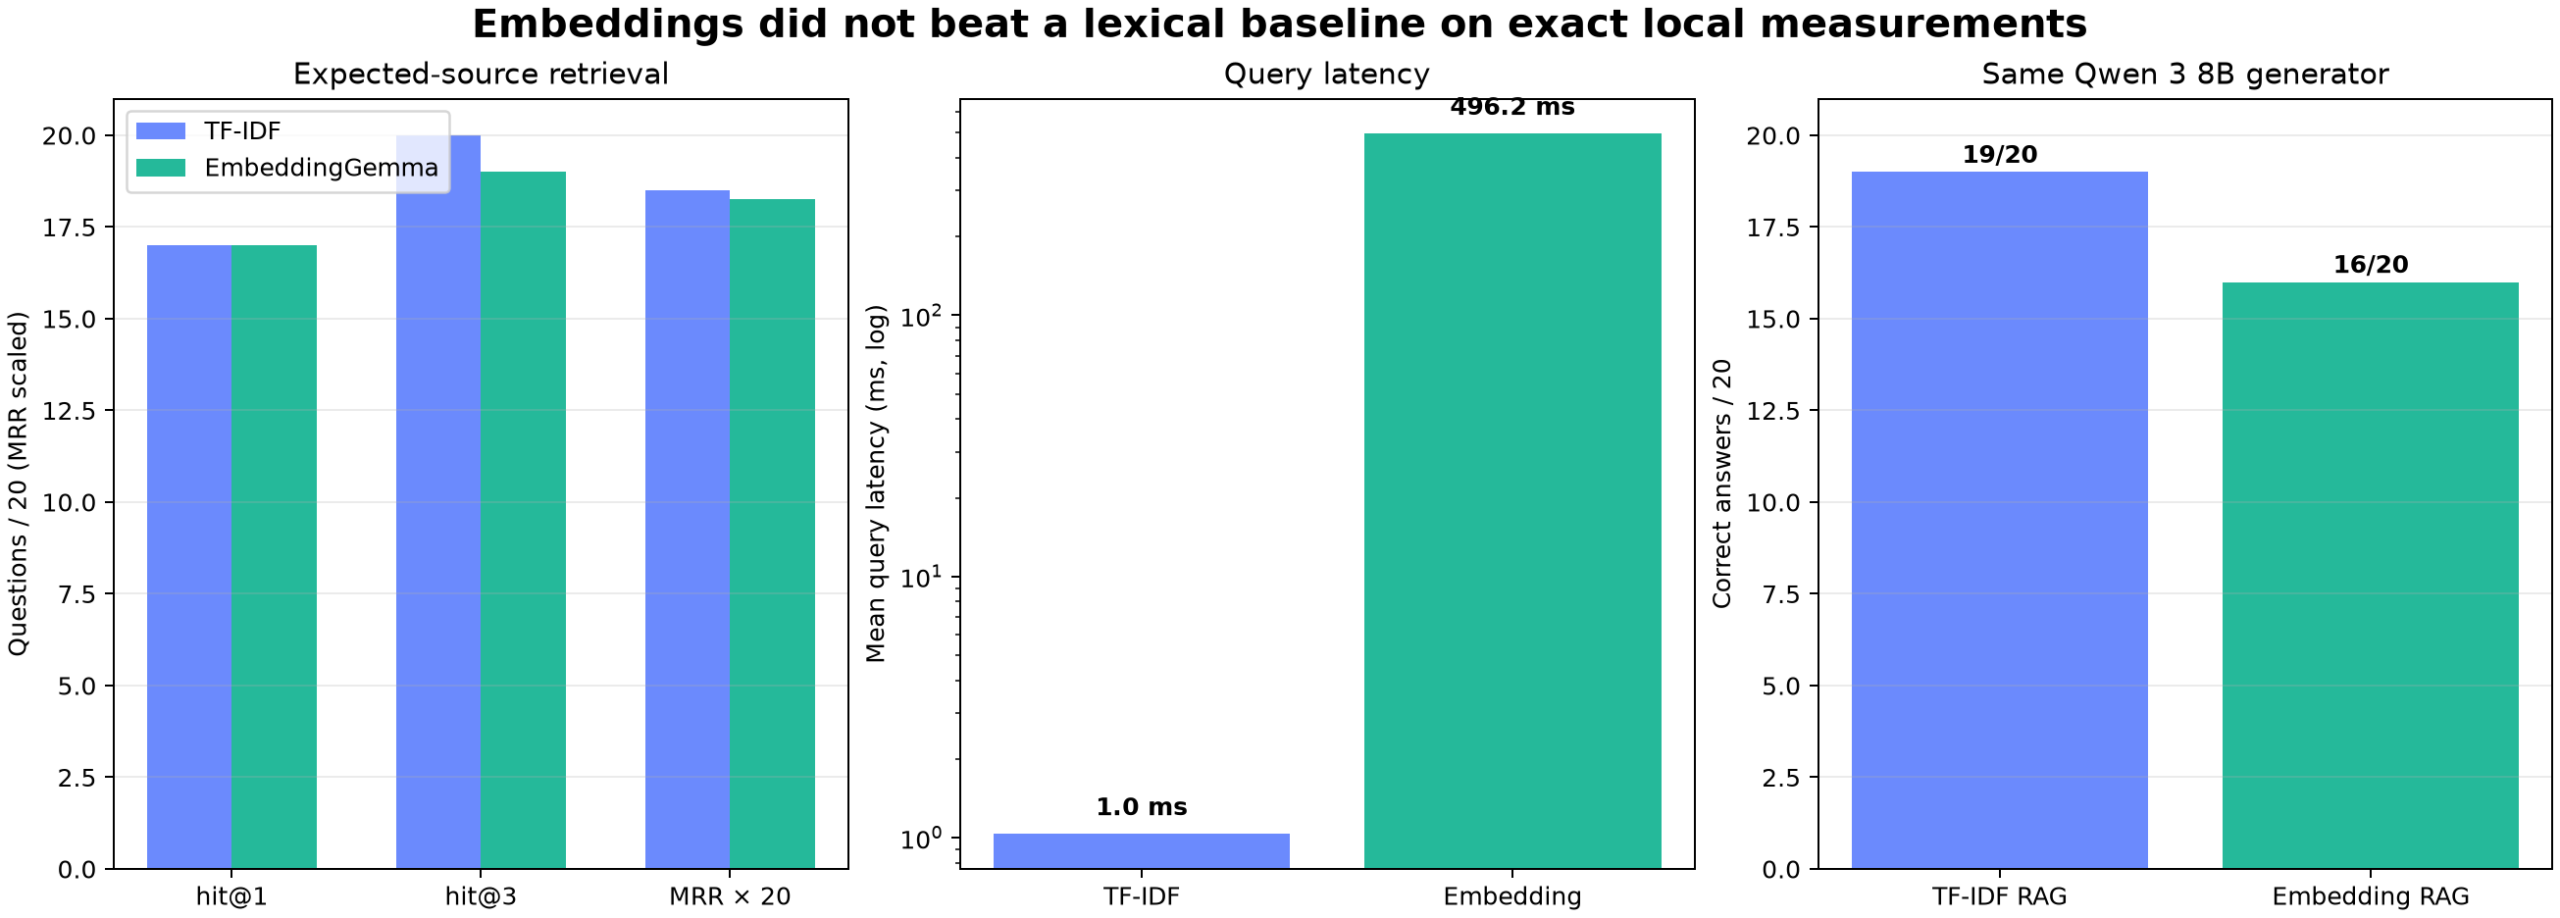
検索の上位に目的の記事が入った数は近いのに、回答の正解数には3問の差が出ました。記事の中でどの段落を選んだかを調べます。
前回と同じ評価集合を使う
比較で最も大切なのは、検索器以外の条件を変えないことです。
documents       13
heading chunks 198
questions       20
top-k            3
generator       Qwen 3 8B Q4
temperature      0
seed            42
質問は、このPCで測った未知の数値です。
12BモデルのGPU peak使用量は何GiBだった?
Digitsの小型NNではCPUとCUDAのどちらが何倍速かった?
augmentationありDataLoaderで0 workerのthroughputはいくつ?
TF-IDF用と埋め込み用で質問やチャンクの大きさを変えると、公平な比較になりません。今回は前回のPython モジュールからARTICLE_NAMES、QUESTIONS、文章の分割関数、採点関数を読み込みしました。
埋め込みは文章をベクトルへ変える
埋め込みモデルは、文章を固定長の実数ベクトルへ写像します。今回、Ollamaへ次のリクエストを送りました。
{
  "model": "embeddinggemma",
  "input": ["検索対象の文章"],
  "truncate": true
}
/api/embedの応答を実測すると、1入力につき768個の浮動小数点数が返りました。
embedding shape = (number of chunks, 768)
検索対象文書 198 チャンクを16件ずつ13バッチで変換しました。ダウンロードしたモデルデータは621 MBです。ここでの621 MBはpull時の表示であり、実行時のVRAM使用量やパラメータ数ではありません。
コサイン類似度を計算する
文書ベクトルと検索文ベクトルをL2正規化します。
arr /= np.maximum(
    np.linalg.norm(arr, axis=1, keepdims=True),
    1e-12,
)
単位ベクトル同士なら、内積がコサイン類似度です。
scores = document_embeddings @ query_embedding
top_idx = np.argsort(scores)[::-1][:3]
コサイン類似度はベクトルの向きを比べ、長さの影響を除きます。値が大きいほど埋め込み空間で近いと見なします。ただし「近い」が何を意味するかはモデルの学習目的に依存します。
TF-IDFは文字列の一致を数える
比較の基準は単語へ分けず、連続する文字を使う文字n-gramです。
TfidfVectorizer(
    analyzer="char_wb",
    ngram_range=(2, 4),
    sublinear_tf=True,
)
例えば検索文にCUDA peak allocatedがあれば、その連続文字を含むチャンクが強くなります。意味の言い換えには弱い反面、モデル名、バージョン、数値、関数名をそのまま探す課題では強力です。
実装と計算の性質も違います。
| 方式 | 表現 | インデックス |
|---|---|---|
| TF-IDF | 出現した文字列を次元に持つ疎なベクトル | 検索対象文書統計から計算 |
| 埋め込み | 768次元の密なベクトル | ニューラルネットワークで推論 |
198 チャンク程度なら両方ともメモリ上に置けます。大規模化するとTF-IDFは転置インデックス、埋め込みは近似最近傍探索用のインデックスが一般的です。
検索結果はほぼ同点、TF-IDFがわずかに上
期待出典記事が最初に現れる順位を測りました。
                 hit@1   hit@3   MRR
TF-IDF           17/20   20/20   0.9250
EmbeddingGemma   17/20   19/20   0.9125
MRRはMean Reciprocal Rankです。正解出典が順位 1なら1、順位 2なら1/2、順位 4なら1/4を与え、20問で平均します。上位へ来るほど高くなります。
差は20問で1件なので、一般的な優劣を断定する規模ではありません。しかし「埋め込みへ変えれば自動的に改善する」という仮説は、この課題では支持されませんでした。
埋め込みが改善した質問
次の質問ではTF-IDFの期待出典が順位 2、埋め込みは順位 1でした。
12BモデルのGPU peak使用量は何GiBだった?
TF-IDF top 1はQ4/Q8の量子化記事でした。GPU、peak、GiBが強く一致したためです。EmbeddingGemmaは4B・8B・12B比較記事を1位へ上げました。
RAG回答も正解です。
12BモデルのGPU peak使用量は約9.7GiBだった。
[article_ollama_4b_8b_12b.md#4]
この質問では、GPUやpeakなどの文字列一致よりも、「12B モデルのメモリ使用量の測定」という意味の近さが順位に効いた可能性があります。
埋め込みが落とした質問
次の質問では、TF-IDFの期待出典は順位 1、埋め込みは順位 4でした。
Digitsの小型NNではCPUとCUDAのどちらが何倍速かった?
埋め込み top 3にはFashionMNIST CNNのCPU/GPU比較とNumPy NN記事が入り、期待したPyTorch Digits記事は外れました。意味的にはどれも「小さなニューラルネット、CPU/GPUの速度比較」に近い文書です。
幸いFashionMNIST記事の比較表にDigitsの4.38倍が再掲されていたため、回答自体は正解しました。
CPUはCUDAに対して約4.38倍速かった。
[article_fashion_cnn_cpu_gpu.md#7]
想定した出典とは違いますが、別出典が同じ測定値を支持しています。これは評価設計上の重要点です。正解出典を1ファイルに限定すると、重複した正しい根拠を誤って罰する場合があります。
出典記事の一致でも根拠を含む部分を外す
Embedding RAGが不正解だった4問のうち、代表例です。
質問:
code生成で4Bの修正後合格数はいくつ?

retrieval:
article_llm_codegen_pytest.md#2
article_llm_codegen_pytest.md#8
article_llm_codegen_pytest.md#12

回答:
資料内に記載なし
出典記事は順位 1です。しかし7/10がある#1を選べませんでした。記事単位のhit@1は成功でも、根拠となる段落の検索は失敗です。
DataLoader質問も同様でした。
augmentationありDataLoaderで0 workerのthroughputはいくつ?
期待出典は順位 2に入りましたが、上位チャンクには8,830 images/sがありません。LLMは資料内に記載なしを返しました。
RAGを調査するときは記事名だけでなく、top-kの本文を保存しなければ原因を特定できません。
回答正解は19/20対16/20
検索した上位3 チャンクを同じQwen 3 8Bへ渡しました。
TF-IDF RAG       19 / 20
Embedding RAG    16 / 20
出典記事の一致@3の差は1問ですが、回答正解は3問差です。出典記事の中でどの見出しを取ったかが効いたためです。
Embedding RAGの期待出典引用は18/20、平均生成時間は0.640秒でした。前回TF-IDF RAGは0.376秒でしたが、プロンプトに入ったチャンクの文字量が同じとは限らないため、generator 速度の厳密な比較にはしません。
検索の待ち時間は1.0 ms対496 ms
このPCでの平均値です。
TF-IDF transform + sparse score   1.03 ms
Ollama EmbeddingGemma API       496.2 ms
この実装では埋め込みが約480倍の時間を要しました。ただしTF-IDFは同じPython プロセス内で検索し、埋め込みはOllamaへのHTTP リクエストとニューラルネットワークの実行を含みます。モデルが読み込み済みかどうかや、まとめて処理する量、GPU処理の実行順も異なるため、検索方式そのものの速度差とは言えません。
この検索文を1件ずつAPIへ送る構成では、埋め込みによって約0.5秒の待ち時間が増えました。
インデックス作成もTF-IDF 0.189秒、埋め込み 12.45秒でした。検索対象の文書ベクトルは文書更新時に一度計算してキャッシュできます。検索文のベクトルはリクエストごとに必要です。
数値を探す20問での比較
質問は型番や設定値を含むものが多く、TF-IDFが文字列の一致を拾いやすい内容でした。自然な言い換えや複数記事をまたぐ質問で同じ差が出るかは、ここでは測っていません。
EmbeddingGemmaにはモデル固有の入力形式を調整せず、Ollamaの既定モデルへ文章をそのまま渡しました。チャンクの長さやタイトルの付け方も含め、埋め込み検索を十分に調整した結果ではありません。
また、正解出典は質問ごとに1記事を指定しています。同じ数値が別の記事にも載っている場合は、そちらを検索して答えても記事単位の採点では外れます。検索順位の数字だけでなく、取り出した本文を見る必要がありました。
再現手順
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
ollama pull embeddinggemma

cd ~/ai-experiments/work/ai_lab
/opt/ai-lab/venv/bin/python -u experiment_embedding_search.py
/opt/ai-lab/venv/bin/python plot_embedding_search.py
生成されるファイルは次のとおりです。
work/ai_lab/experiment_embedding_search.py
work/ai_lab/results/embedding_search.json
work/ai_lab/plot_embedding_search.py
work/figures/tfidf-vs-embeddinggemma.png
JSONには両検索器の順位とtop 3 ID、埋め込み側のチャンク全文とスコア、検索時間、Qwen回答、正誤、引用元を保存しました。
