PyTorch 2.13.0+cu130
GPU: RTX 5070 Ti 16 GB / WSL2 Ubuntu 26.04
FashionMNISTのCNNで、一度に学習させる画像の枚数を32枚から8192枚まで増やしました。速くなったのは主に256枚までで、そこから先はGPUメモリの増え方が目立ちます。
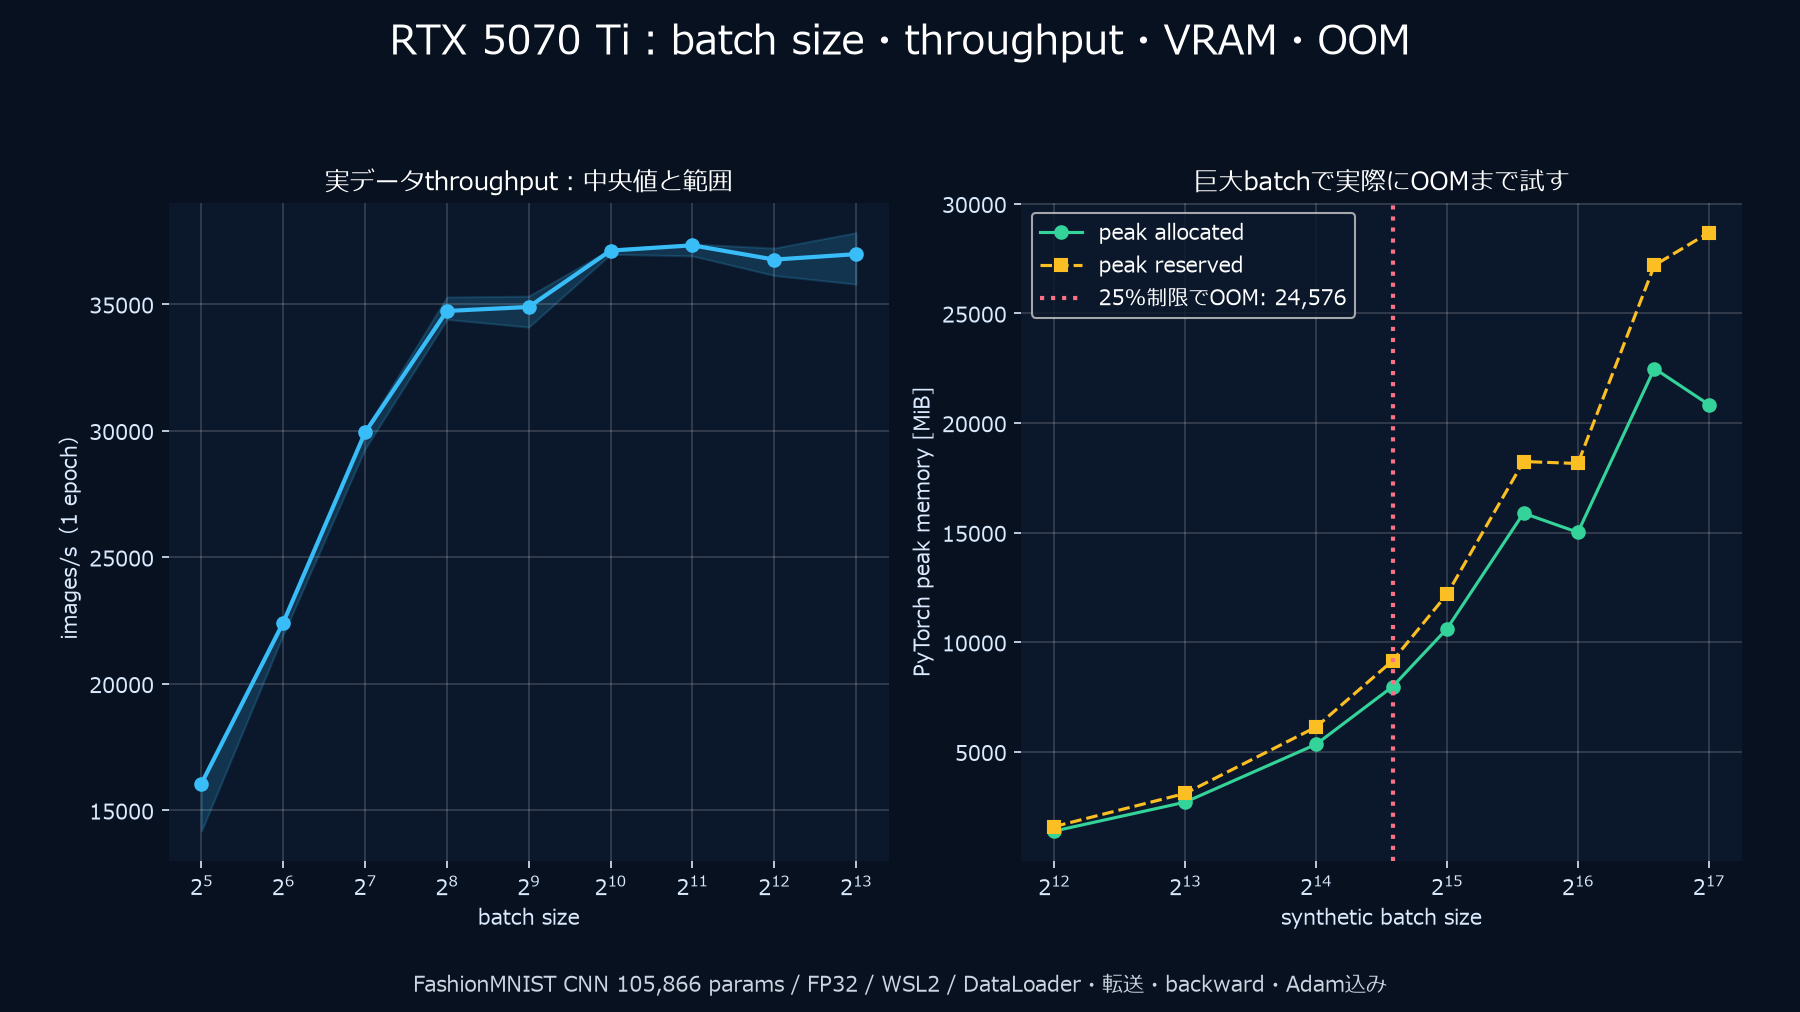
256枚ならピーク106 MiBで最高速度の約93%に届きました。8192枚は約6.5%速いものの、メモリは約25倍です。さらに大きな合成入力も試し、WSL 2で急に遅くなる領域と、メモリ不足エラーが出たときの挙動を確認しました。
どこで頭打ちになったか
バッチ 32
16,062 images/s / 1エポック 3.735秒 / ステップ 1.99 ms / allocated 70.7 MiB
バッチ 256
34,738 images/s / 1.727秒 / ステップ 7.35 ms / allocated 106.2 MiB
バッチ 1024
37,124 images/s / 1.616秒 / ステップ 27.39 ms / allocated 399.3 MiB
バッチ 2048(今回の最高中央値)
37,332 images/s / 1.607秒 / ステップ 53.57 ms / allocated 728.9 MiB
バッチ 8192
36,983 images/s / 1.622秒 / ステップ 202.80 ms / allocated 2,704.3 MiB
- バッチ 32→256では処理速度が約2.16倍になりました。
- 256→2048は約7.5%しか増えません。
- 256は最大値の約93.1%を、allocated 106 MiBで得られました。
- 8192は256より約6.5%高速ですが、allocatedは約25.5倍です。
- WSL2では自然条件でPyTorch
reservedが物理VRAMを超えても処理が続き、バッチ 32,768→49,152で約19.9万→5.7万 images/sへ急落しました。 - 可視メモリの25%というallocator上限を明示すると、バッチ 16,384は成功し、24,576で実際のCUDA OOMになりました。
バッチサイズを大きくすると何が変わるのか
バッチサイズをBとすると、1回のforward/backwardでB個の入力を並列処理します。バッチを大きくする主な利点は次の2つです。
- GPUへ渡す1回の仕事を大きくし、カーネル launchなどの固定費を相対的に小さくする
- 大きな行列・畳み込みとして計算し、GPUの演算器やメモリ bandwidthを使いやすくする
一方で、中間出力は入力ごとに保存するため、おおむねバッチサイズに応じてVRAM消費が増えます。また1エポックあたりの最適化器更新回数は減ります。
60,000画像なら、バッチ 32は1,875ステップですが、8192は8ステップです。同じ「1エポック」でも最適化の軌跡は同じではありません。今回の目的は計算性能とメモリの測定なので、最終精度の比較とは分離します。
実験モデルと測定範囲
モデルは前の記事と同じ105,866パラメータのCNNです。
input 1×28×28
  → Conv 1→16 → ReLU → MaxPool
  → Conv 16→32 → ReLU → MaxPool
  → Linear 1568→64 → ReLU
  → Linear 64→10
条件は次の通りです。
- FashionMNIST学習データ60,000枚
- FP32、TF32は
ieee指定で無効 - Adam、学習率 0.001
num_workers=0、pin_memory=True- バッチ:32、64、128、256、512、1024、2048、4096、8192
- 各バッチを3回、順序は昇順→降順→昇順
- 毎回同じ初期重み、並べ替え乱数シード 42
- 同じバッチ配列の形で合成1ステップをウォームアップし、測定外
- DataLoader、CPU→GPU転送、順伝播、逆伝播、Adam更新を含む
- CUDAの非同期実行を考慮して前後に
synchronize()
torch.cuda.synchronize()
started = time.perf_counter()

for images, labels in loader:
    images = images.cuda(non_blocking=True)
    labels = labels.cuda(non_blocking=True)
    optimizer.zero_grad(set_to_none=True)
    loss = loss_function(model(images), labels)
    loss.backward()
    optimizer.step()

torch.cuda.synchronize()
seconds = time.perf_counter() - started
順伝播だけのmicrobenchmarkではありません。研究室で実際に学習スクリプトを回したときの待ち時間へ近づけるため、データ供給と最適化器も含めました。
処理速度は256付近から頭打ちになった
実データ3回の中央値です。
| バッチ | images/s | エポック秒 | allocated MiB |
|---|---|---|---|
| 32 | 16,062 | 3.735 | 70.7 |
| 64 | 22,425 | 2.676 | 75.7 |
| 128 | 29,936 | 2.004 | 85.9 |
| 256 | 34,738 | 1.727 | 106.2 |
| 512 | 34,896 | 1.719 | 232.7 |
| 1024 | 37,124 | 1.616 | 399.3 |
| 2048 | 37,332 | 1.607 | 728.9 |
| 4096 | 36,768 | 1.632 | 1,386.0 |
| 8192 | 36,983 | 1.622 | 2,704.3 |
ステップ数は順に1,875、938、469、235、118、59、30、15、8でした。ステップ待ち時間の中央値は1.99 msから202.80 msへ増えています。reservedを含む全未集計値は再現用JSONへ保存しました。
32→256では、ステップ時間は約3.7倍になりましたが、1ステップの画像数は8倍です。そのためエポック全体は約2.16倍速くなりました。
ところが256以降、処理速度は約3.5~3.7万images/sで頭打ちです。バッチを倍にするとステップ時間もほぼ倍になり、エポック時間が縮まらなくなりました。
バッチ 256以降は処理速度がほぼ横ばいでした。バッチを大きくするとVRAM使用量と1ステップの時間は増えますが、エポック時間はほとんど縮まりません。
実用上のsweet spotは最大値とは限らない
今回の最高中央値はバッチ 2048の37,332 images/sでした。しかしバッチ 256も34,738 images/sで、最高値の93.1%です。
その差は1エポックあたり約0.12秒です。一方、allocatedは106.2 MiBと728.9 MiBで約6.9倍違います。
空いたVRAMは、より大きいモデル、高解像度入力、データ拡張、別プロセス、推論serverなどへ使えます。またバッチを小さくすると、1エポックあたりの重み更新回数が増えます。最高処理速度の一点だけを選ぶのではなく、速度・メモリ・収束を合わせて選ぶべきです。
16GBを超えたのに、なぜ自然OOMにならなかったのか
次に、DataLoaderを外し、同じCNNへ合成画像を1 バッチだけ入力しました。これは巨大バッチでメモリ境界を見る試験です。
自然条件ではバッチ 131,072までOutOfMemoryErrorになりませんでした。PyTorchのピーク値は次のようになりました。
- バッチ 32,768:allocated 10,613 MiB、reserved 12,186 MiB、約199,072 images/s
- バッチ 49,152:allocated 15,887 MiB、reserved 18,244 MiB、約56,761 images/s
- バッチ 98,304:allocated 22,488 MiB、reserved 27,196 MiB、約20,498 images/s
- バッチ 131,072:allocated 20,842 MiB、reserved 28,684 MiB、約24,173 images/s
torch.cuda.mem_get_info()が報告したtotalは16,302.6 MiBです。それなのにPyTorchの論理的なピーク counterはそれを超えました。同時にバッチ 32,768→49,152で処理速度は約71%低下しています。
PyTorchのピーク counterは物理VRAMへの常駐量と同じではありません。 OOMせず動いても、高速とは限りません。
このPCはWindowsのWDDM経由でWSL2へGPUを公開しています。メモリ virtualizationや退避が関係した可能性は高いものの、この実験だけでどのpageがどこへ置かれたかまでは証明できません。NVIDIA公式のCUDA on WSL User Guideも、WSLではGPU機能とメモリ利用に固有の制約があると説明しています。
実際のCUDA OOMを安全に再現する
自然OOMを求めてシステムメモリまで使い切るのは、安全な実験ではありません。そこでPyTorch caching allocatorへ、可視メモリの25%を上限として設定しました。
torch.cuda.set_per_process_memory_fraction(0.25, 0)
公式のset_per_process_memory_fractionによると、許容量はtotal visible memory × fractionで、プロセスがそれを超えるallocationを試すとallocatorがOOMをraiseします。
今回の許容量は約3.98 GiBでした。
- バッチ 8,192:成功、ピーク allocated 2,703 MiB
- バッチ 16,384:成功、ピーク allocated 3,803 MiB
- バッチ 24,576:
torch.OutOfMemoryError - OOM時の追加要求:588 MiB
- OOM時:PyTorch allocated約3.15 GiB、reserved but unallocated約444 MiB
ここでOOMが起きたのは、可視メモリの25%に設定したallocator上限に達したためです。バッチ 24,576はこの制限下での結果で、RTX 5070 Tiの物理限界ではありません。
OOM メッセージにも検算が必要
今回のexception メッセージには、正しい上限3.98 GiBや追加要求588 MiBとともに、プロセス使用量が非現実的な17179869184.00 GiBという値も含まれました。
16GB GPUでこの値はあり得ません。WSL2、PyTorch 2.13 nightly相当、プロセス fractionを組み合わせた動作確認表示上の問題と考えられますが、原因は未確定です。
例外メッセージを丸ごと信じず、次を合わせて保存しました。
torch.cuda.mem_get_info()のfree / totalmax_memory_allocated()max_memory_reserved()- 設定したプロセス fraction
- バッチサイズ
- PyTorch / CUDA / ドライババージョン
error メッセージの数値は、単位と桁を確認し、ハードウェア仕様やtorch.cuda.mem_get_info()、PyTorchのメモリ counterと照合します。
OOMからプロセスを回復させる
OOMをcatchしても、失敗した計算グラフやTensorへの参照が残っているとメモリは解放されません。
try:
    loss = torch.nn.functional.cross_entropy(model(images), labels)
    loss.backward()
    optimizer.step()
except torch.OutOfMemoryError as exc:
    print(exc)
finally:
    del model, optimizer, images, labels, loss
    gc.collect()
    torch.cuda.empty_cache()
empty_cache()だけでは、参照中のactive Tensorを解放しません。まずPython側の参照を外す必要があります。今回のスクリプトはOOMをcatchした後もJSONと図を正常に書き出し、プロセスを終了できました。
実際の学習なら、OOM後に次を試します。
- バッチサイズを半分にする
- FP16/BF16 AMPを使う
- 勾配累積で小バッチを複数ステップまとめる
- 入力解像度・sequence lengthを下げる
- 中間出力 checkpointingを使う
- 不要なTensorや損失 historyがGPU上に残っていないか調べる
勾配累積はOOM対策だが同じ計算ではない
たとえばmicro バッチ 64を4回累積すれば、最適化器から見たeffective バッチは256です。
accumulation_steps = 4
optimizer.zero_grad(set_to_none=True)

for step, (images, labels) in enumerate(loader, start=1):
    loss = loss_function(model(images.cuda()), labels.cuda())
    (loss / accumulation_steps).backward()

    if step % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
ただしBatchNormのstatistics、dropout mask、最後の端数バッチなどにより、巨大バッチを一度に処理する場合と完全には同じにならないことがあります。今回のCNNにはBatchNormを入れていませんが、一般化するときには注意が必要です。
再現方法
以下のコマンドでは、作業フォルダーを ~/ai-experiments と表記します。実際の保存先に合わせて読み替えてください。フォルダー内の work/ 以下の配置はそのまま使います。
cd ~/ai-experiments/work/ai_lab

/opt/ai-lab/venv/bin/python experiment_fashion_batch_oom.py \
  --repeats 3 \
  --data-dir /opt/ai-lab/data \
  --output results/fashion_batch_oom.json \
  --figure ../../outputs/fashion-batch-throughput-oom.png
JSONには27回の実データ学習、自然条件の巨大バッチ試験、controlled OOMの全測定値とexception メッセージを保存しています。
256枚でも十分速かった
このCNNでは、バッチ256から先は速度の伸びが小さくなりました。ほかの処理にもGPUメモリを使いたいなら、最高速度のために8192枚へ増やす利点は小さそうです。
さらに大きな入力では、エラーが出る前に処理速度が崩れました。WSL 2では「メモリ不足にならなかった」だけでは余裕があると判断できません。バッチ数を変えたら、使用量と1ステップの時間も一緒に確認したいところです。
