Google AI Pro(Google OneのAIプラン)には、Google Colabで使える月200コンピューティングユニット(CCU)が付いてきます。この200 CCUでGPUを何時間動かせるかは固定ではなく、選んだGPUの1時間あたり消費レートで変わります。
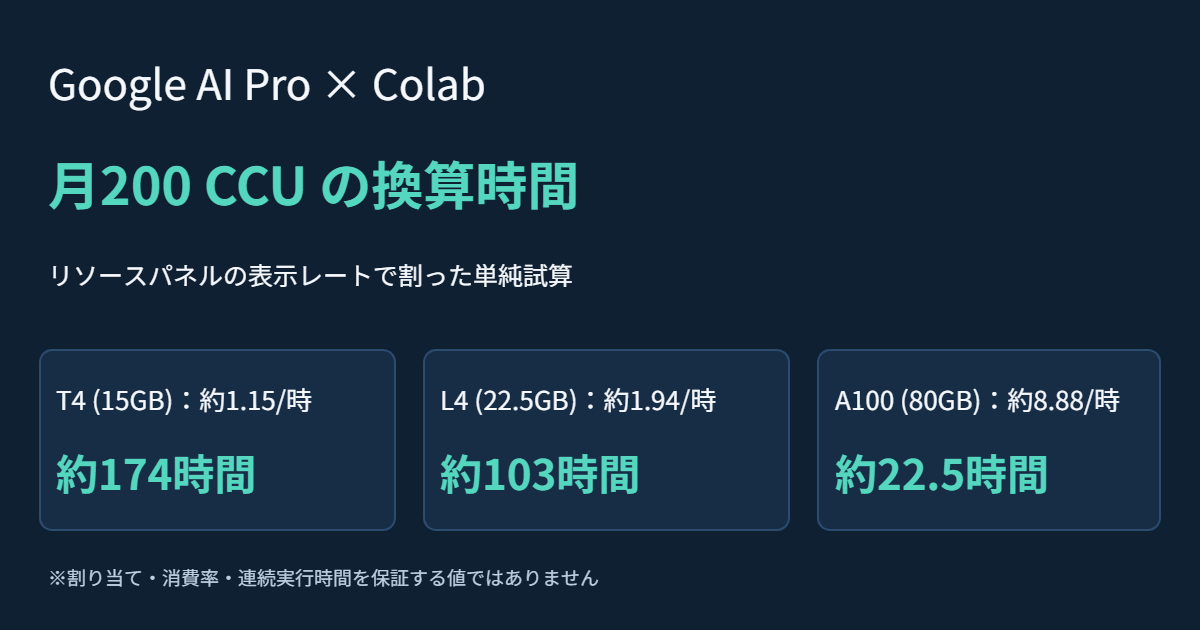
実際にColabでT4 GPU、L4 GPU、A100 GPUへ順番に接続して右上のリソースパネルを見たところ、1時間あたりの使用率はTesla T4が約1.15、NVIDIA L4が約1.94、NVIDIA A100-SXM4-80GBが約8.88でした。月200 CCUをこのレートで単純に割ると、T4なら約174時間、L4なら約103時間、A100なら約22.5時間になります。
ただし、A100はいつでもつながるわけではありません。深夜にA100 GPUを選んだときは空きがなく自動的にNVIDIA L4へ切り替わり、翌朝やり直したときに80GB版のA100へ接続できました。
T4・L4・A100の表示レートと200 CCUの換算時間
各ランタイムへ接続したときのリソースパネルの表示値と、200 CCUをその表示レートで割った単純試算です。メモリやディスクの単位はColab画面の表記(GB)をそのまま載せています。
| 選んだ設定 | 実際の割当GPU | システムRAM上限 | GPU RAM | 表示使用率(1時間あたり) | 月200 CCU単純試算(実測稼働ではない) |
|---|---|---|---|---|---|
T4 GPU(ハイメモリなし) |
Tesla T4 |
12.7 GB | 15.0 GB | 約1.15 | 約173.9時間(約174時間) |
L4 GPU(ハイメモリ有効) |
NVIDIA L4 |
53.0 GB | 22.5 GB | 約1.94 | 約103.1時間(約103時間) |
A100 GPU(1回目・深夜) |
NVIDIA L4(代替接続) |
53.0 GB | 22.5 GB | (L4として接続) | — |
A100 GPU(2回目・朝、ハイメモリ有効) |
NVIDIA A100-SXM4-80GB |
167.1 GB | 80.0 GB | 約8.88 | 約22.5時間(200 / 8.88) |
これは短い確認セルを動かした時点での画面表示をまとめたもので、固定の料金表や速度ベンチマークではありません。T4とL4、1回目のA100選択時の記録はobservations.jsonに残しています。T4ではPyTorchの6条件実験を最後まで動かし、L4とA100ではGPU名とメモリを確認する短いセルだけを実行してすぐに切断しました。
GPUが変わると、VRAMだけでなくシステムRAMの上限も大きく変わります。T4では12.7 GBでしたが、L4では53.0 GB、80GB版のA100では167.1 GB(ディスク235.7 GB、別にlocal-scratchが368.0 GB)になっていました。
A100を選んでもL4につながることがある
1回目にA100 GPUを選んで接続したときは、「選択した GPU タイプは使用できませんでした。現在 L4 に接続しています。」という通知が出て、torch.cuda.get_device_properties(0).nameもNVIDIA L4でした。
翌朝にもう一度A100 GPUを選んで接続すると、今度はフォールバックなしでつながり、確認コードでは次の出力が返りました。
Python: 3.13.16
PyTorch: 2.14.1+cu130
CUDA available: True
GPU: NVIDIA A100-SXM4-80GB
Total memory (bytes): 85094825984
Capability: 8 0
メニューでA100を選べても、混雑状況によってはL4へ切り替わります。そのとき1時間あたりの消費レートも約8.88ではなくL4側の値になるため、重い処理を始める前に「今どのGPUがつながっているか」をコードとリソースパネルの両方で見ておく必要があります。
月200 CCUが付く条件とリセットの周期
公式ヘルプとFAQで確認しておきたい点は次の5つです。
- Google One公式ヘルプの「Google Colabを使用する」節によると、Google AI Proには月200 CCUが含まれており、日本も対象です。条件として、18歳以上であること、ファミリープランの管理者であること、無料トライアル期間中ではないことが挙げられています。
- Colab公式FAQによると、対象のGoogleアカウントでColabを開けば特典は自動で適用されます。別申し込みは不要で、Colabの「設定」→「Subscription」から確認できます。
- 月200 CCUの付与日は全員一律の毎月1日ではなく、自分のGoogle AIプランの権利開始日に基づく月次周期です。Colab単体の定期購入や追加購入分がある場合は、それぞれの周期で同じ残量へ足されます。
- 同FAQのResource Limits節にあるとおり、GPUの空きや割り当て、アイドル時の切断、ランタイムの最大寿命は動的に変わります。割り算で出した「月174時間・103時間・22.5時間」は月の延べ時間の目安であり、1回の接続でそのまま連続稼働できる時間ではありません。
- Google Developers Blogの発表では、上位のAI Ultra向けの特典としてバックグラウンド実行やPremium GPUに触れられています。AI Proの特典を「ブラウザーを閉じても無制限に動く」ものとは扱えません。
GPUの確認から使い終わって切断するまで
CCUを無駄に減らさないために、接続から終了まで次の順で操作しています。
- Google AI Proを契約したアカウントでGoogle Colabを開き、「ノートブックを新規作成」を選ぶ。
- 「ランタイム」→「ランタイムのタイプを変更」で
T4 GPUやL4 GPU、A100 GPUを選んで保存する。 - 最初のセルで次のPythonコードを実行し、実際に割り当てられたGPU名とバージョンを確かめる。CPUランタイムのまま動かすと
CUDA available: False、GPU: Noneになります。
import platform, torch
print('Python:', platform.python_version())
print('PyTorch:', torch.__version__)
print('CUDA available:', torch.cuda.is_available())
print('GPU:', torch.cuda.get_device_name(0) if torch.cuda.is_available() else None)- 画面右上の「RAM / ディスク」表示を押すか、「ランタイム」→「リソースを表示」を開き、「利用可能なコンピューティングユニット数」と「使用率: 1時間あたり約…」を見る。手元の残りCCUを表示レートで割れば、そのGPUであと何時間使えるかの目安が分かります。
- 結果のJSONや必要なファイルを保存したら、すぐに右上の接続メニューから「ランタイムを接続解除して削除」→「確認」で終了する。特にA100(約8.88/時)は放置すると1時間で約9 CCU減るため、計算が終わったらすぐランタイムを削除します。なお、ランタイムを削除すると仮想マシン内の一時ファイルは消えるので、必要なファイルの退避を先に行います。
Colabで足りる実験と、手元のGPUでやる実験
T4ランタイム上で実際に動かしたPyTorchの検証は、PyTorchのmodel.eval()とno_grad・inference_modeの比較記事にまとめました。公開ノートブック(eval_grad_modes_colab.ipynb)を開けば、コミット4529519e799cef59cba1962ac37ea2123a941625のコードをSHA256固定で読み込んでそのまま実行できます(実行結果のJSONはcolab.json)。
PyTorchのAPI仕様を確かめたり、80GBのVRAMが必要な処理を一時的に試したりするならColabが手軽です。一方、Windows 11やWSL 2のドライバー問題、手元のRTX 5070 TiでのVRAM解放やローカルLLMの速度測定はColabでは代わりになりません。手元のGPU環境を作る手順はWSL 2でPyTorchからGPUを使う手順を参照してください。