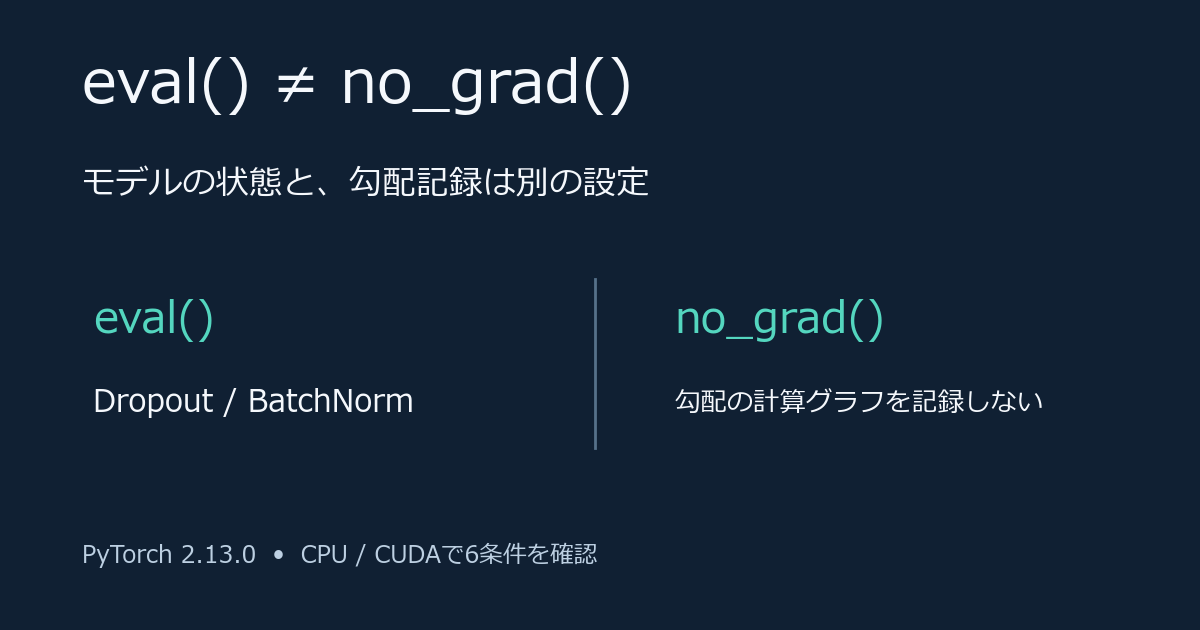
PyTorchで推論するとき、model.eval()を呼んだだけでは勾配の記録は止まりません。小さなモデルで試すと、model.eval()にした後でも、出力テンソルにはrequires_grad=Trueとgrad_fnが付いたままでした。
model.eval()が切り替えるのは、DropoutやBatchNormといった層の動作モードです。勾配の計算グラフを作らないようにするには、torch.no_grad()かtorch.inference_mode()を一緒に使います。反対に、no_grad()やinference_mode()だけを書いてもmodel.trainingは変わらないため、train状態のまま入るとDropoutのマスクやBatchNormの統計更新が動き続けます。
今回は速度やメモリ量の比較ではなく、どの指定で何が切り替わるかを確かめました。環境はWSL 2上のPython 3.12.14、PyTorch 2.13.0+cu130(CPUとRTX 5070 Ti)と、Google ColabのTesla T4です。追加のデータセットや学習済み重みは使いません。WSL 2とPyTorchの導入はWSL 2でPyTorchからGPUを使う手順、不要になったテンソルやキャッシュの扱いはdel・detachとempty_cacheの実測記事にまとめています。
6つの組み合わせで何が切り替わるか
試したモデルはLinear(8, 8) → BatchNorm1d(8) → ReLU() → Dropout(p=0.5) → Linear(8, 2)です。乱数シードを42に固定し、6条件すべてに同じ初期重みを入れた別々のモデルを用意しました。
入力は32×8の固定テンソルで、input.requires_grad=Falseにしています。モデル側の重みは既定のrequires_grad=Trueです。入力がFalseでも、途中の線形層やBatchNorm層の重みがTrueなので、通常モードでは出力にAddmmBackward0のgrad_fnが付きます。
各条件で同じ入力を続けて2回流したのは、時間の平均を取るためではありません。Dropoutで2回の出力が変わるか(torch.equal(out1, out2))と、BatchNorm1dのnum_batches_trackedが何回増えるかを見るためです。
| モデル状態 | 勾配モード | 出力に勾配記録 | 2回出力一致 | BNカウンター増分 |
|---|---|---|---|---|
train |
通常 | あり (AddmmBackward0) |
不一致 (False) |
+2 (0→2) |
train |
no_grad |
なし (None) |
不一致 (False) |
+2 (0→2) |
train |
inference_mode |
なし (None) |
不一致 (False) |
+2 (0→2) |
eval |
通常 | あり (AddmmBackward0) |
一致 (True) |
+0 (0→0) |
eval |
no_grad |
なし (None) |
一致 (True) |
+0 (0→0) |
eval |
inference_mode |
なし (None) |
一致 (True) |
+0 (0→0) |
スクリプト(ai_lab/experiment_eval_grad_modes.py)では、このほかにmodel.training、torch.is_grad_enabled()、torch.is_inference_mode_enabled()も確認しています。CPU(cpu.json)とCUDA(cuda.json)のどちらで動かしても、この表の結果は同じでした。
上3行(train)と下3行(eval)を比べると、2回の出力が揃うかとBatchNormのカウンターが進むかは、trainかevalかだけで決まっています。trainのままno_gradやinference_modeに入っても、Dropoutは毎回違う要素を落とし、BatchNormのカウンターは0から2へ増えます。
反対に、出力へ勾配の記録が付くかどうかは、通常モードかno_grad・inference_modeかだけで決まります。PyTorch公式のAutograd解説にあるとおり、model.eval()と勾配の停止は別のスイッチです。
no_gradとinference_modeの差が出る場所
6条件の表だけなら、torch.no_gradとtorch.inference_modeは同じに見えます。差が出るのは、ブロックの中で作ったテンソルを外へ持ち出し、後ろの学習する層へ渡したときです。
スクリプトの後半では、それぞれのブロック内で4×8の特徴テンソル(torch.randn(4, 8, device=device) * 2)を作り、ブロックを抜けた後で新しいnn.Linear(8, 1)へ入れてloss.sum().backward()を呼んでみました。
| 試した条件 | is_inference() |
backward() 成功 |
重み勾配の格納 | 出た例外 |
|---|---|---|---|---|
no_grad_direct |
False |
True |
True |
None |
inference_mode_direct |
True |
False |
False |
RuntimeError |
inference_mode_cloned_outside |
False(元はTrue) |
True |
True |
None |
torch.no_grad()の中で作ったテンソルは、普通のテンソル(is_inference() == False)です。特徴を作った側の計算グラフは持ちませんが、外でnn.Linear(8, 1)へ渡せば、その線形層の重みとバイアスの勾配はそのまま計算できます。なお、no_grad()の中では通常の演算結果がrequires_grad=Falseになりますが、requires_grad=Trueを明示した作成関数などは別です。
一方、torch.inference_mode()の中で作ったテンソルはinference tensor(is_inference() == True)になります。今回のnn.Linear(8, 1)は重みの勾配を計算するために入力テンソルを保存しようとするので、ブロックの外でhead_inf(inf_features)を実行した時点で止まりました。
RuntimeError: Inference tensors cannot be saved for backward.あらゆる演算で無条件に出るエラーではありませんが、今回の線形層のように逆伝播用に入力を保存する層へそのまま渡すとここで引っかかります。ブロックを出た後でinf_features.clone()を呼ぶと普通のテンソル(is_inference() == False)になるため、後ろのnn.Linear(8, 1)の勾配を計算できました。ただし、clone()で動くようになるのは後ろの層の学習だけで、inference_mode()の中で計算した上流の層の勾配が復活するわけではありません。
推論だけか、特徴を取り出して学習するかで書き分ける
推論結果を得るだけで、その出力を後ろの学習に使わないなら、model.eval()とtorch.inference_mode()を並べます。
model.eval()
with torch.inference_mode():
logits = model(inputs)重みを止めたバックボーンから特徴テンソルを取り出し、外側の分類ヘッドだけを学習するときは、backbone.eval()とtorch.no_grad()を組み合わせます。inference_mode()を使うなら、外へ出た後でclone()してからヘッドへ渡します。
backbone.eval()
with torch.no_grad():
    features = backbone(inputs)

loss = trainable_head(features).sum()
loss.backward()
手元のPCとGoogle Colabで再現する
手元のPython環境で動かす場合は、公開リポジトリをcloneして実行します。すでに同じフォルダーがある場合はgit pullで更新できます。
git clone https://github.com/matrizea/yuyuyuroom-ai-experiments.git
cd yuyuyuroom-ai-experiments
python ai_lab/experiment_eval_grad_modes.py --device cpu --output ai_lab/results/eval_grad_cpu.json
python ai_lab/experiment_eval_grad_modes.py --device cuda --output ai_lab/results/eval_grad_cuda.json
手元にNVIDIA GPUがない場合は、Google Colabの標準環境でも同じコードを試せます。Google Colab用の公開ノートブックでは、コミット4529519e799cef59cba1962ac37ea2123a941625のスクリプトをSHA256ハッシュで確認してから読み込み、CPUとCUDAの両方を実行します。
ColabのTesla T4(Python 3.13.16、PyTorch 2.14.1+cu130)で動かした結果はcolab.jsonに置いています。WSL 2とはPythonやPyTorchの版が違い、浮動小数点の値までビット単位で同じになるとは限りませんが、6条件の切り替わり方と特徴再利用3ケースの結果はすべて一致しました。
Colabで動かすときは、「ランタイム」→「ランタイムのタイプを変更」でT4 GPUを選んでからセルを実行してください。CPUのままでも動き、出力のcuda_availableとgpuで実際にどちらで動いたか分かります。