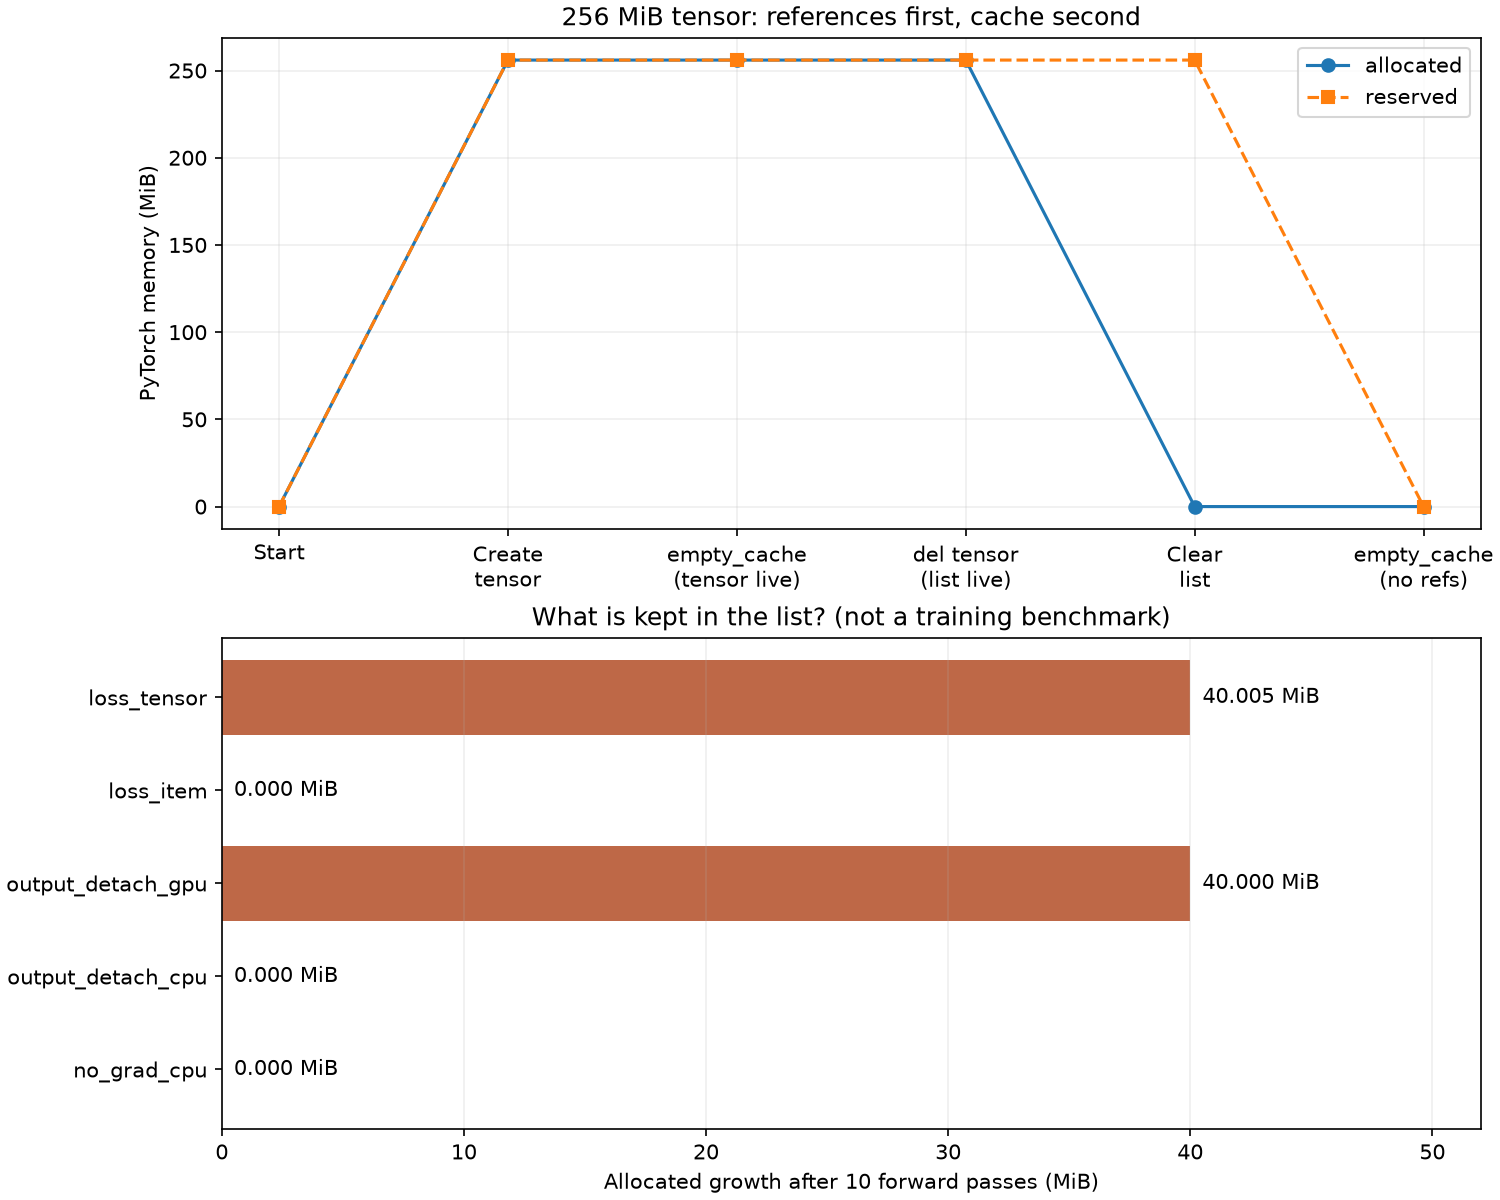
torch.cuda.empty_cache()を呼んでも、まだ使っているテンソルは消えません。256 MiBのテンソルで試すと、変数をdelした後もリストに同じテンソルが残っていれば、使用量は256 MiBのままでした。
リストを空にすると使用中のメモリが0 MiBになり、その後のempty_cache()で再利用用に確保していた領域も0 MiBになりました。
名前を消したつもりでも、どこかで持っている。ここが厄介です。
まずallocatedとreservedを分けて見る
PyTorchは、使い終わったGPUメモリを毎回返さず、次の計算で使い回すために取っておきます。この再利用用の仕組みがキャッシュです。
| 確認する値 | 意味 |
|---|---|
allocated |
このPythonプロセスで、テンソルが使用中のGPUメモリ |
reserved |
PyTorchが管理する領域全体。使用中と再利用待ちを含む |
nvidia-smiの使用量 |
GPU全体やプロセスの使用状況。PyTorchのテンソルだけを数えた値ではない |
どちらも単位はバイトなので、1024**2で割るとMiBになります。1 MiBは1,048,576バイトです。
困っている処理と同じPythonプロセスに、次の表示を入れてみてください。別のターミナルで新しくPythonを起動しても、元のプロセスのテンソル使用量は測れません。
import torch

torch.cuda.synchronize()
print("allocated:", torch.cuda.memory_allocated() / 1024**2, "MiB")
print("reserved :", torch.cuda.memory_reserved() / 1024**2, "MiB")
synchronize()はGPUへ依頼済みの処理が終わるのを待つ命令です。ここでは、途中の状態を読み取らないために使います。学習の毎ステップへ無条件に入れる必要はありません。
allocatedが下がってreservedだけが残るなら、使い終わった領域をキャッシュしている可能性があります。allocated自体が下がらないときは、モデル、入力、出力、保存リストなど、まだ生きているテンソルを先に探します。
PyTorch公式のメモリ管理説明でも、empty_cache()が解放するのは未使用キャッシュであり、使用中のテンソルではないと説明されています。
256 MiBのテンソルを消してみる
測定に使ったのはWindows 11上のWSL 2、RTX 5070 Ti 16 GB、Python 3.14.4、PyTorch 2.13.0+cu130です。PyTorchに同梱されたCUDAランタイムは13.0、Windows側のNVIDIAドライバーは610.88。メモリ管理方式はnativeでした。
必要なのは、CUDAが動くPyTorch環境と1 GiB以上の空きGPUメモリです。環境の準備がまだなら、WSL 2でPyTorchからGPUを使う手順を先に確認してください。Pythonのリストとdelを知っていると読みやすいですが、追加のモデルやデータセットは不要です。準備済みの環境なら実行は1分以内を目安にでき、管理者権限や再起動も要りません。
新しいPythonプロセスで、次を実行します。
import gc
import torch

def show(label):
    torch.cuda.synchronize()
    used = torch.cuda.memory_allocated() / 1024**2
    reserved = torch.cuda.memory_reserved() / 1024**2
    print(f"{label}: allocated={used:.0f}, reserved={reserved:.0f} MiB")

torch.cuda.empty_cache()
show("開始")
x = torch.ones((8192, 8192), device="cuda", dtype=torch.float32)
show("作成")
torch.cuda.empty_cache()
show("参照ありでempty_cache")

saved = [x]
del x
gc.collect()
torch.cuda.empty_cache()
show("delしてもリストに残る")

saved.clear()
gc.collect()
show("最後の参照を外す")
torch.cuda.empty_cache()
show("キャッシュも返す")
float32は1要素4バイトなので、8192×8192×4バイトで256 MiBです。モデルを学習せず、大きさの分かる配列だけを置くことで、どの操作でメモリが減ったかを追います。
| 操作後 | 使用中 | 確保済み |
|---|---|---|
| 開始 | 0 MiB | 0 MiB |
| テンソル作成 | 256 MiB | 256 MiB |
参照がある状態でempty_cache() |
256 MiB | 256 MiB |
del x後。リストには残っている |
256 MiB | 256 MiB |
saved.clear()で最後の参照を外す |
0 MiB | 256 MiB |
その後にempty_cache() |
0 MiB | 0 MiB |
「使用中」がallocated、「確保済み」がreservedです。同じ手順を3回行い、この値は3回とも一致しました。既にモデルを読み込んだプロセスでは開始値が0とは限らず、確保されるキャッシュ量も環境によって変わります。見るところは、最後の参照を外した前後の差です。
del xは「この名前から参照しなくする」操作です。リスト内の要素まで消してはくれません。gc.collect()も、使っているオブジェクトを強制的に捨てる命令ではありません。上のコードでは回収を明示的に促していますが、生きた参照をなくす代わりにはなりません。
lossの記録にも計算グラフが付いてくる
学習中の損失をグラフにしたくて、次のように保存することがあります。
loss_history.append(loss)
lossが自動微分の対象なら、ただの数値ではありません。どの演算から作られたかという計算グラフにつながっています。逆伝播に必要な中間データが残っていれば、小さな損失値の保存から、そのデータも保持されます。
そこで、1024×1024の入力にtorch.sigmoid(x * 2)を計算し、その平均を損失として10回保存しました。入力は勾配を記録するrequires_grad=Trueです。残りやすい状況を作るため、ここでは逆伝播のbackward()は呼んでいません。
| リストに保存するもの | 10回後のGPU使用量の増分 |
|---|---|
lossをそのまま |
40.005 MiB |
loss.item() |
0 MiB |
output.detach() |
40.000 MiB |
output.detach().cpu() |
0 MiB |
no_grad()内で計算して出力をCPUへ保存 |
0 MiB |
表は各回の一時変数を消した後のallocatedです。入力自体の4 MiBは増分から除いています。各条件3回で同じ増分となりました。計算中のピーク使用量や速度の比較ではありません。
損失の数値だけを記録するなら、Pythonの数値へ取り出せば十分です。
loss_history.append(loss.item())
ただし、これをlossそのものの置き換えにしてはいけません。loss.item()からは逆伝播できません。学習には元のlossを使い、ログへ入れる値だけを取り出します。また、GPU上の数値をCPUへ取り出す処理には待ち時間が生じ得るため、大量のログを毎ステップ記録する場合は速度も別に確認してください。
通常の学習でbackward()を呼ぶと、逆伝播用の中間データは原則として解放されます。今回の40 MiB増加が、あらゆる学習ループで同じように起こるわけではありません。検証処理で勾配記録を切り忘れた場合や、逆伝播前の損失を複数回ためる処理では、保存しているものを確認する価値があります。
detachだけではGPUから移動しない
detach()は自動微分のつながりを切りますが、CPUへの移動ではありません。公式仕様では、元のテンソルとデータ領域を共有するとされています。
今回の出力は1個4 MiBです。output.detach()を10個リストへ入れると、計算グラフを切っても出力データだけで40 MiBがGPUに残りました。
後でCPU上で集計するなら、次のように保存します。
outputs.append(output.detach().cpu())
GPUの使用量は増えなくなりましたが、データがなくなったわけではありません。今度はCPU側のメモリを使います。出力をすべて保存する必要がなければ、必要な件数だけ残す、合計値だけ更新するなど、保存量自体を制限するほうが扱いやすくなります。
学習ではなく推論・検証だけなら、最初から勾配を記録しない方法もあります。
with torch.no_grad():
    output = torch.sigmoid(x * 2)
    outputs.append(output.cpu())
no_grad()は逆伝播用の記録を作らないための指定です。テンソルを無条件に解放する機能ではなく、GPU上の出力をリストにためれば、その出力分は残ります。モデルで使うeval()はDropoutなどの動作モードの切り替えで、勾配記録を止める指定とは別です。学習を続けたい区間にno_grad()を入れると必要な勾配を作れなくなるので、推論・検証区間に限って使います。
再起動する前に確認する場所
allocatedが計算のたびに増えるなら、まず結果を保存するリスト、辞書、クラスの属性を見ます。delした名前以外から同じテンソルを参照していないか、損失や出力を丸ごとためていないかを確認します。
Notebookではセルを実行し直しても、カーネルというPythonプロセス自体は動き続けます。原因を切り分けるときは、この再現コードを新しいPythonプロセスで実行すると、以前の変数が残った状態と区別しやすくなります。カーネル再起動は途中の計算状態も失うため、保存が必要な結果を退避してから行います。
allocatedは下がったのにreservedが高い場合、未使用領域を同じPyTorch処理が再利用できる状態かもしれません。別のGPUアプリへ領域を返したいときにempty_cache()を使います。学習ループの毎回に追加しても、生きたテンソルを減らす対策にはなりません。
両方が低いのにnvidia-smiでは多く見えるなら、別のPythonプロセスやアプリも確認します。この測定値は現在のプロセスのPyTorch管理分なので、GPU全体の使用量とは一致しません。他人の処理や用途不明のプロセスを止めず、まず自分の処理かを確認してください。
最初の1回からメモリ不足になる場合は、保存リストの蓄積とは別の問題かもしれません。バッチサイズとGPUメモリの実測では、一度に処理する枚数を増やしたときの使用量を扱っています。速度も落ちている場合の確認には、PyTorch profilerで待ち時間を切り分ける手順を使えます。
再現コード
測定コードと未丸めのバイト数はGitHubのCUDAメモリ実験に置いています。既存のCUDA対応PyTorch環境を有効にしたWSLのターミナルで実行してください。
git clone --depth 1 https://github.com/matrizea/yuyuyuroom-ai-experiments.git ~/ai-experiments
cd ~/ai-experiments
python -c "import torch; print(torch.__version__); print(torch.cuda.is_available())"
python ai_lab/experiment_cuda_memory_lifetime.py --output ai_lab/results/cuda_memory.json
同じフォルダーを既に使っている場合は、重ねてcloneせず、そのチェックアウトを利用します。未保存の変更があるリポジトリへ無条件に更新をかけないでください。
3回の確認を通ると、最後に次の行が出ます。
PASS: all checks passed in 3 repetitions
CUDA unavailableと出る場合は、この実験以前に、現在のPythonからCUDAが使えていません。環境を消さず、pythonの実体とCUDA対応PyTorchを確認します。Less than 1 GiB freeなら、空き容量が足りないため実験を始めず終了しています。自分のGPU処理を片付けてから再実行してください。
実験用の追加データは不要で、JSONは小容量です。リポジトリには別記事の再現用モデルも含まれるため、取得用には数十MB程度のディスク空きを見込んでください。PyTorch本体を新規導入する場合のダウンロードと容量はこれに含みません。
