Ollamaの/api/generateをstream: falseで呼ぶと、出力トークン数の上限(num_predict)に当たって途中で切れても、最後まで出し切って止まっても、返ってくるdoneはどちらもtrueになります。doneだけ見ていると、回答が途中で切れたことに気付けません。
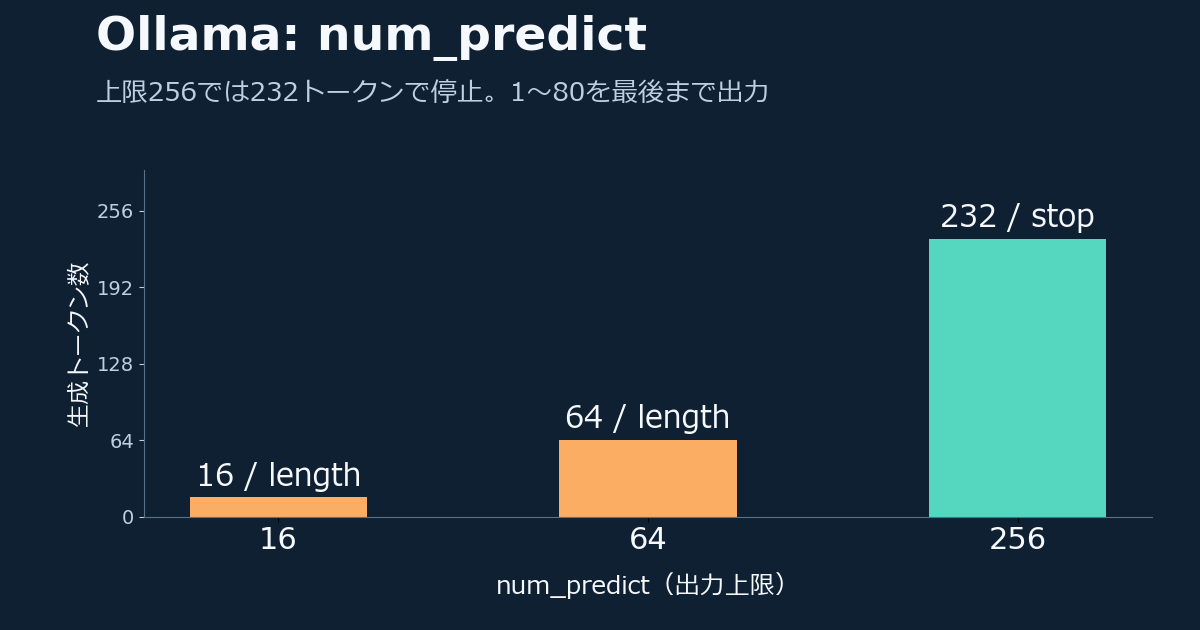
そこで「1から80までの整数を、小さい順に半角スペースで区切って書いてください。数字とスペース以外は書かないでください。」というプロンプトを固定し、num_predictを16・64・256に変えて比べてみました。16と64は上限到達を示すdone_reason: "length"で止まり、256にしたときだけ232トークン(done_reason: "stop")で80まで出力できました。
| 項目 | 条件 |
|---|---|
| 実行環境 | WSL 2 / Python 3.12.14 / Ollama 0.32.15 |
| モデル | gemma3:4b-it-q4_K_M(gemma3 / 4.3B / Q4_K_M) |
| 固定した指定 | temperature: 0, seed: 42, num_ctx: 4096, stream: false, keep_alive: "5m" |
モデルの正確なパラメータ数などを含む応答データはresult.jsonに残しています。Ollamaの導入や接続確認はOllamaの環境構築と不具合確認の記事、Gemma 3 4Bの量子化による違いはQ4_K_MとQ8_0の比較記事を参照してください。
上限16・64・256トークンで試した結果
測定スクリプト(ai_lab/experiment_ollama_output_limit.py)では、最初にnum_predict: 1のウォームアップを1回だけ別枠(warmup)で実行し、そのあと16 → 64 → 256を3巡(計9回)繰り返しました。
本計測の9回は、すべて入力トークン数がprompt_eval_count: 41、完了フラグがdone: trueでした。3巡とも出力文字列、生成トークン数、終了理由はまったく同じです。
上限 (num_predict) |
生成トークン (eval_count) |
終了理由 (done_reason) |
文字数 | 1..80一致 |
|---|---|---|---|---|
16 |
16 | length |
16 | false(8個で中断) |
64 |
64 | length |
64 | false(25個・末尾途切れ) |
256 |
232 | stop |
231 | true(80個一致) |
OllamaのGenerate API仕様では、doneはその応答で生成が終わったことを示すフラグです。上限に当たって切れたかどうかを見分けるには、done_reasonが"length"になっていないかと、eval_countが指定したnum_predictに張り付いていないかを見ます。
64トークンでは末尾が「24 2」で切れた
返ってきたresponseの文字列をそのまま並べると、切れ方がよく分かります。
num_predict: 16の出力全文:"1 2 3 4 5 6 7 8 "(末尾の空白まで16文字、整数は8個)num_predict: 64の出力全文:"1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 2"(64文字、末尾は"21 22 23 24 2")num_predict: 256の出力(途中省略):"1 2 3 ... 78 79 80\n"(改行を含め全文231文字、1から80まで80個)
num_predict: 64では、24の後ろに"2"が1文字出たところで64トークンに達して止まっています。この文字列から正規表現r"-?\d+"で数字を拾うと、最後の"2"も1個として数えられるため25個になりますが、中身は途中で切れた未完の列です。
また、16と64ではトークン数(eval_count)と文字数がたまたま同じでしたが、256では232トークンで231文字、整数の数は80個でした。トークン数は文字数とも単語数とも一致しません。
num_predict: 256の結果からは、もう2つ分かることがあります。
num_predictは上限なので、必ず256トークン出るわけではありません。今回は上限に達する前の232トークンで止まり、done_reasonは"stop"になりました。done_reason: "stop"は「上限で切れずに止まった」という意味だけで、中身が合っている保証ではありません。今回のスクリプトでは、取り出した整数列が1から80まで順番どおりか(matches_1_to_80)を別にチェックしています。これは今回の数字並べ課題に対する判定なので、別の質問ではその用途に合う確認が必要です。
num_ctxを広げてもnum_predictが小さいと止まる
OllamaのModelfile仕様にあるとおり、num_ctxは入力と出力を合わせたコンテキスト窓の広さで、num_predictは1回の応答で出す最大トークン数です。
今回は全条件でnum_ctx: 4096にしており、入力は41トークンしかありません。コンテキスト窓にたっぷり空きがあっても、num_predictが小さければそこで出力は止まります。なお、今回は短い入力だけで試しており、長文入力やthinkingモデルの検証はしていません。num_ctx側の増やし方とVRAM使用量はOllamaのコンテキスト4K・8K・16K比較記事で扱っています。
APIの指定例と再現コマンド
スクリプトやアプリから/api/generateを呼ぶときは、optionsにnum_predictとnum_ctxを入れておき、応答のdone_reasonとeval_countを一緒に記録すると切り分けやすくなります。
{
  "model": "gemma3:4b-it-q4_K_M",
  "prompt": "1から80までの整数を、小さい順に半角スペースで区切って書いてください。数字とスペース以外は書かないでください。",
  "stream": false,
  "keep_alive": "5m",
  "options": {
    "temperature": 0,
    "seed": 42,
    "num_ctx": 4096,
    "num_predict": 256
  }
}
再現スクリプトはモデルの自動ダウンロードやサーバー設定の変更をしません。先にOllamaを起動し、モデルが入っているか確認します。
ollama list
# まだ入っていない場合のみ
ollama pull gemma3:4b-it-q4_K_M接続先URLは引数--base-urlか環境変数OLLAMA_HOSTで渡します。http://またはhttps://から始まるURLを入力してください。すでにリポジトリがある場合はgit pullで更新できます。
git clone https://github.com/matrizea/yuyuyuroom-ai-experiments.git
cd yuyuyuroom-ai-experiments
read -r -p 'Ollamaサーバーの接続先URL: ' OLLAMA_HOST
export OLLAMA_HOST
python ai_lab/experiment_ollama_output_limit.py --output ai_lab/results/ollama_output_limit.json実行すると、16・64・256の3巡分のeval_count、done_reason、matches_1_to_80が一覧表示され、指定したパスへJSONが保存されます。