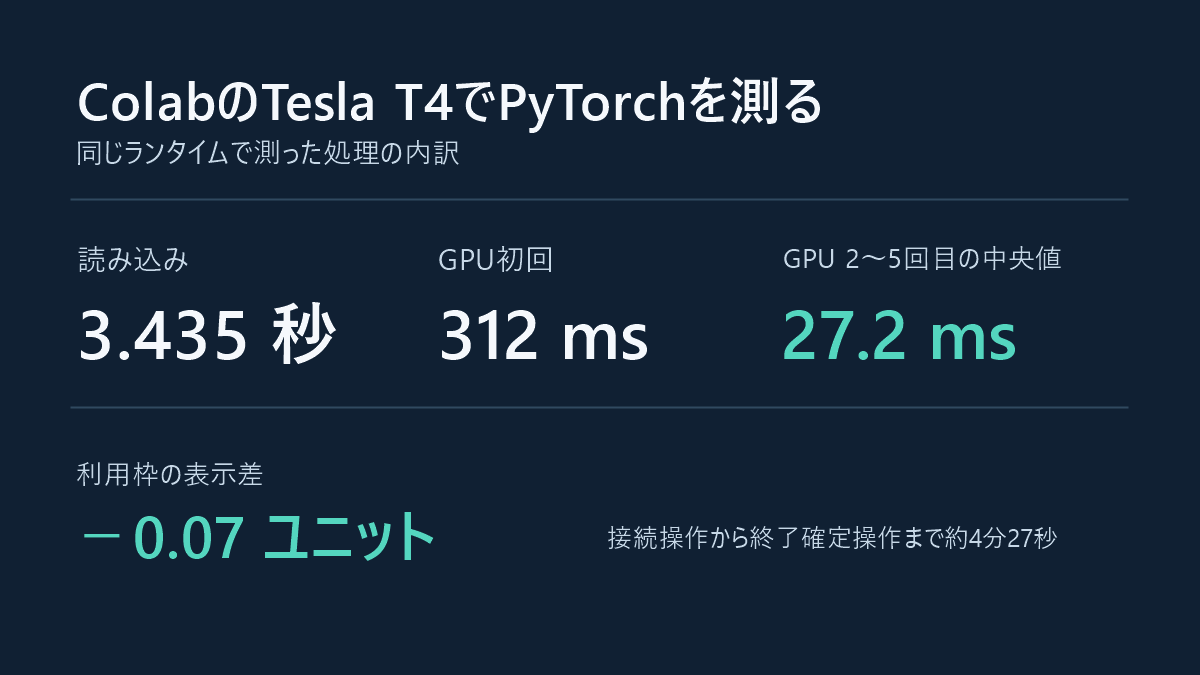
Google Colabは、ブラウザー上でPythonを実行できるノートブック環境です。Google AI Proの利用枠でTesla T4を選び、短いPyTorchの検証を実行しました。接続ボタンを押してから終了を確定するまで約4分27秒で、終了後に利用枠の表示が0.07コンピューティングユニット減りました。
セルの中ではPyTorchなどの読み込みに3.435秒、最初のGPU(Graphics Processing Unit、並列計算を行う演算装置)実行に312ミリ秒かかりました。同じGPUで2回目以降を測ると、4回の中央値は27.2ミリ秒でした。
最初にかかる時間と、繰り返すときの時間
実行環境はTesla T4、Python 3.13.16、PyTorch 2.14.1+cu130です。CUDA(Compute Unified Device Architecture)はNVIDIAのGPU向け並列計算基盤で、+cu130はCUDA 13.0向けのビルドを示します。勾配の記録を調べた記事と同じ実験コードを読み込みました。追加のパッケージやデータセットは使っていません。
time.perf_counter()で各工程の経過時間を測りました。コードの取得時にはSHA-256(Secure Hash Algorithm 256-bit、内容の一致を確かめるためのハッシュ関数)を照合しています。最初にtorch.cuda.init()でGPUの実行環境を初期化し、CPU(Central Processing Unit、中央処理装置)で1回、続けて同じGPUで5回実行しました。GPUの各試行では集計の前にtorch.cuda.synchronize()で処理の完了を待ちました。
| 工程 | 秒 |
|---|---|
| PyTorchなどの読み込み | 3.43484 |
| 実験コードの取得・照合・読み込み | 0.19553 |
| GPUの初期化と同期 | 0.33227 |
| CPUでの実行(1回) | 0.15995 |
| GPUでの実行(1回目) | 0.31157 |
| GPUでの実行(2〜5回目) | 0.02735、0.02706、0.02621、0.02886 |
各試行で動作確認の6項目が通り、テンソルの再利用3条件も元の検証と同じ結果になりました。明示的な初期化を済ませた後でも、1回目は2〜5回目の中央値の約11.5倍かかりました。この差の内訳は測っていません。CPUは1回、GPUは同じ環境での繰り返しなので、この表からCPUとGPUの一般的な速度差は判断できません。
利用枠の表示が変わったのは切断後
接続前と解放後の残高を、Colabのリソース画面で読みました。接続できたことを画面で確認したのは接続操作から約40秒以内です。稼働中に管理画面で確認できたセッションは1件で、表示の使用率は約1.15コンピューティングユニット/時でした。結果を取ってランタイムを解放すると使用率は0になり、小数第2位までの残高表示が接続前より0.07減りました。
約4分27秒は開始と終了の操作時刻の差です。コードの実行前後に操作や画面確認をした時間も含みます。0.07はセッション前後の表示から読んだ差で、セルを1回動かす単価や課金の内部値には換算できません。稼働中は残高の表示が変わらなかったので、短い検証でも切断後にリソース画面を見直すと差を確認できました。選べるGPUや利用条件は変わります。Colabの利用制限と、GPUごとの表示使用率を調べた記録も参照できます。
同じ測定を試す
元の公開ノートブックを開き、ランタイムのタイプでT4を選びます。引き続き同じノートブックで測る場合も、初回の計測は新しいランタイムで下のセルを先に実行します。セルは固定したコミットから元の公開コードだけを取得し、計測値を画面に出します。最後にランタイムを解放し、リソース画面で残高を読み直します。
import json, time
from time import perf_counter
start = perf_counter()
import hashlib, platform, urllib.request, torch
import_seconds = perf_counter() - start
start = perf_counter()
url = 'https://raw.githubusercontent.com/matrizea/yuyuyuroom-ai-experiments/4529519e799cef59cba1962ac37ea2123a941625/ai_lab/experiment_eval_grad_modes.py'
source = urllib.request.urlopen(url, timeout=30).read()
assert hashlib.sha256(source).hexdigest() == '904d4f9461eca6aee2c9855faf20d9e0631a0629aa66d6bf6608f3871e7e2fe6'
probe = {'__name__': 'eval_probe'}
exec(compile(source, 'experiment_eval_grad_modes.py', 'exec'), probe)
source_seconds = perf_counter() - start
start = perf_counter()
torch.cuda.init()
torch.cuda.synchronize()
init_seconds = perf_counter() - start
gpu = torch.cuda.get_device_name(0)
records = []
for name, count in [('cpu', 1), ('cuda', 5)]:
    device = torch.device(name)
    for rep in range(count):
        start = perf_counter()
        modes = probe['run_six_mode_combinations'](device)
        reuse = probe['run_tensor_reuse_subexperiment'](device)
        if name == 'cuda':
            torch.cuda.synchronize()
        records.append({'device': name, 'seconds': perf_counter() - start, 'passes': sum(r['self_check_passed'] for r in modes), 'reuse_backwards': [r['backward_succeeded'] for r in reuse]})
print('COLAB_TIMING ' + json.dumps({'gpu': gpu, 'python': platform.python_version(), 'torch': torch.__version__, 'imports_s': import_seconds, 'source_s': source_seconds, 'cuda_init_s': init_seconds, 'runs': records}))