このPCでは、CPUはdynamic INT8、RTX 5070 TiはFP16を第一候補にします。CPUのINT8は容量と時間を減らせましたが、深度の正解値(Ground Truth、GT)として実測値を使うと、画素ごとの誤差がわずかに増えました。4bitはさらに小さくなる一方、GPUではFP16より速くならず、実測GTに対する誤差も増えています。
Depth Anything V2 SmallをFP32、INT8、INT4へ変換し、Core i7-14700FとRTX 5070 Tiで動かしました。CPUのdynamic INT8はFP32の275.0 msから198.8 msへ短縮。一方、学習済みモデルを保存・実行する形式であるONNXの同じファイルをCUDAへ渡すと59.36 msかかり、FP32の12.89 msより遅くなっています。整数化した演算の一部がCPUに残っていました。
FP8も同じGPU・実行環境で追加比較しました。FP16から容量は約43%減りましたが、推論時間は6.45 msから45.50 msへ延び、NYUv2の実測GTに対する誤差も小さく増えています。GPUがFP8に対応していても、この実行経路ではFP16を選ぶ結果になりました。
CPUではINT8が198.8 ms、INT4は小さいが速いとは限らない
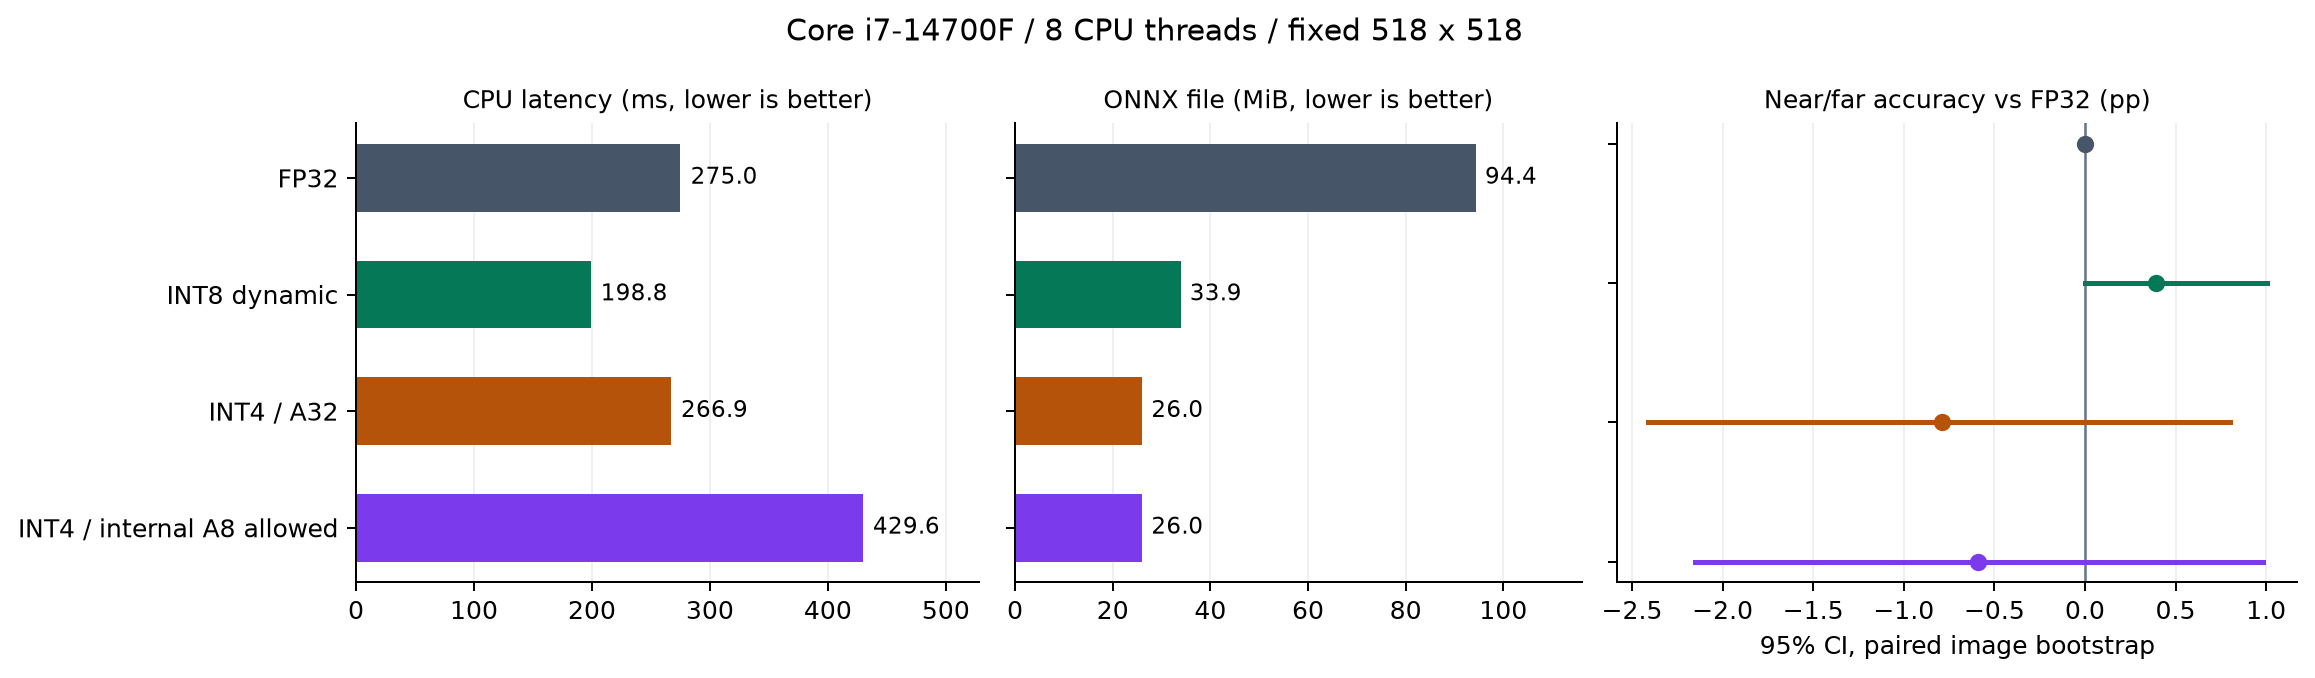
まずは同じ4つのONNXを、CPUの8スレッドで比較しました。入力は518×518画素、一度に処理する枚数(batch size)は1。時間はモデルの読み込み後の推論呼び出しで、画像読込や前後処理は含みません。
画像はOpenCVのCUBIC補間で518×518へ直接リサイズしています。切り抜きはせず、縦横比も変わります。縦横比を保つ公式の通常前処理とは違うため、以下はこの固定入力条件での比較です。
| モデル | ONNX容量 | CPU推論の中央値 | GT近遠正答率 | FP32の正答から悪化 / 改善 |
|---|---|---|---|---|
| FP32 | 94.36 MiB | 275.0 ms | 476/507、93.89% | ― |
| dynamic INT8 | 33.89 MiB | 198.8 ms | 478/507、94.28% | 0 / 2ペア |
| INT4、途中の値はFP32 | 26.02 MiB | 266.9 ms | 472/507、93.10% | 11 / 7ペア |
| INT4、内部INT8近似を許可 | 26.02 MiB | 429.6 ms | 473/507、93.29% | 10 / 7ペア |
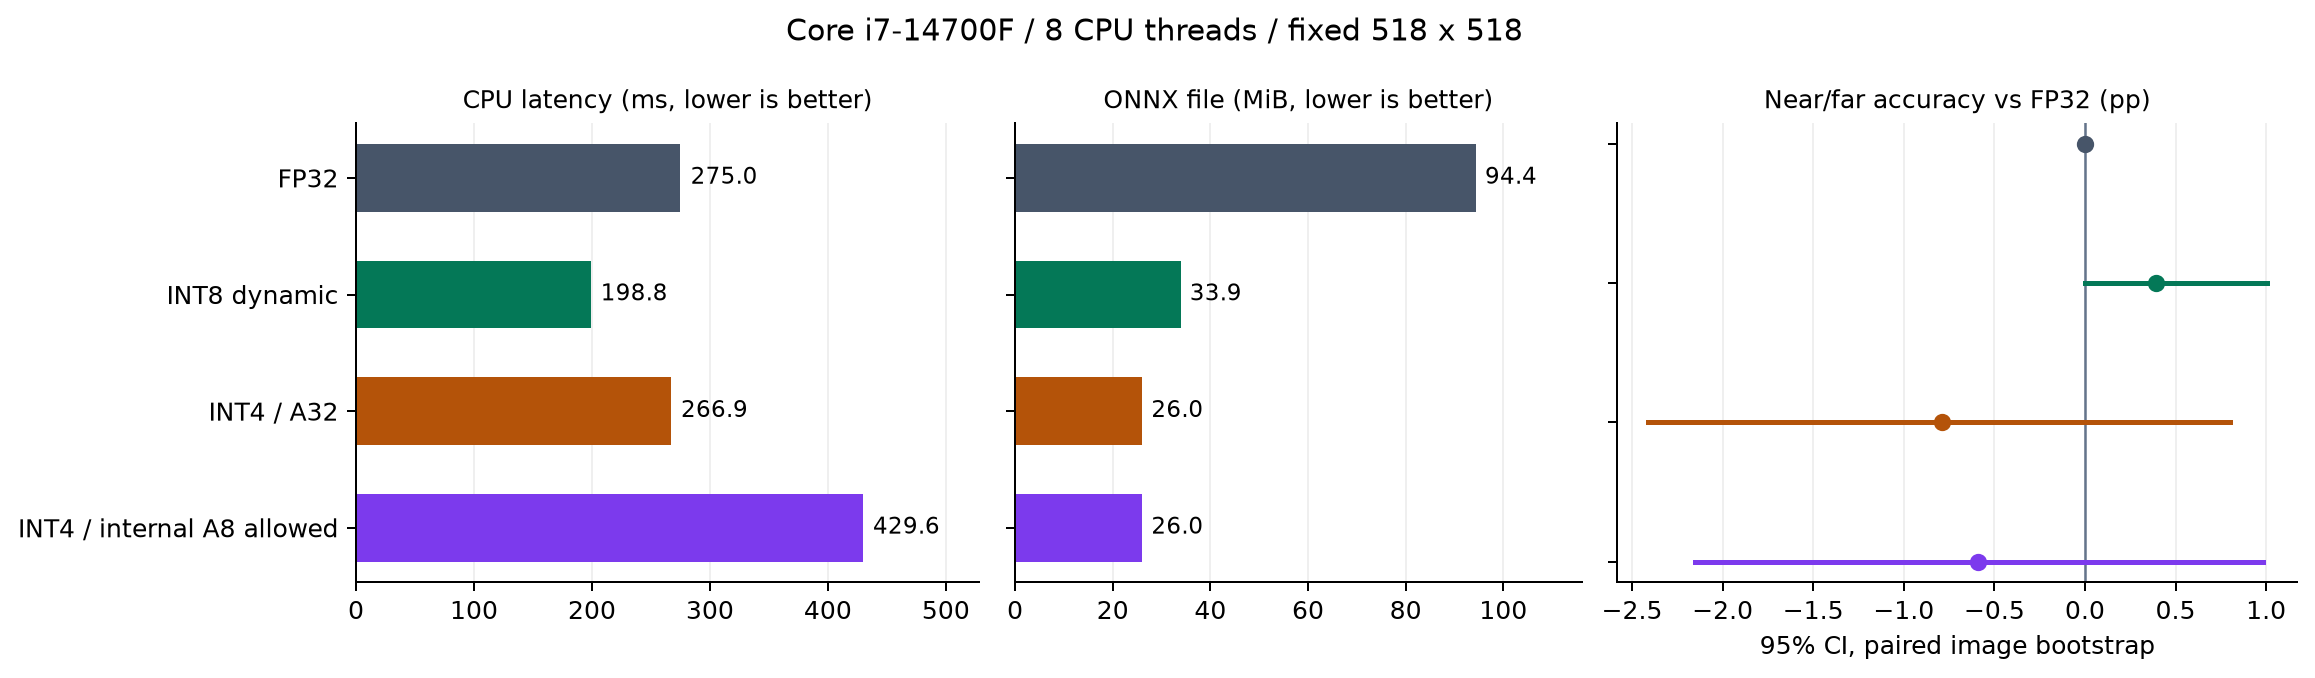
dynamic INT8は容量が約64%減り、推論は約1.38倍の速さになりました。INT4へ下げるともう少し小さくなりますが、高速化の効果はほぼ消えています。内部のINT8近似を許可した版は、むしろ遅くなりました。ファイル名のint4_fastは設定を区別するコード名で、速さの保証ではありません。
正答率に使ったのは、作者のDA-2Kから選んだ256画像です。8カテゴリから各32画像をseed42で抽出し、2点のうちどちらが近いか、507ペアを判定しました。メートルで距離を当てる問題ではありません。
INT8の正答が2ペア増えましたが、これだけで精度が上がる手法とは言えません。FP32との差は+0.39ポイント、対応のある95%信頼区間は[0.00, +1.00]ポイントです。INT4の2設定も区間に0を含みました。数百枚で見分けられない小さな差は残りますし、同じ正答率でも答えが入れ替わったペアがあります。
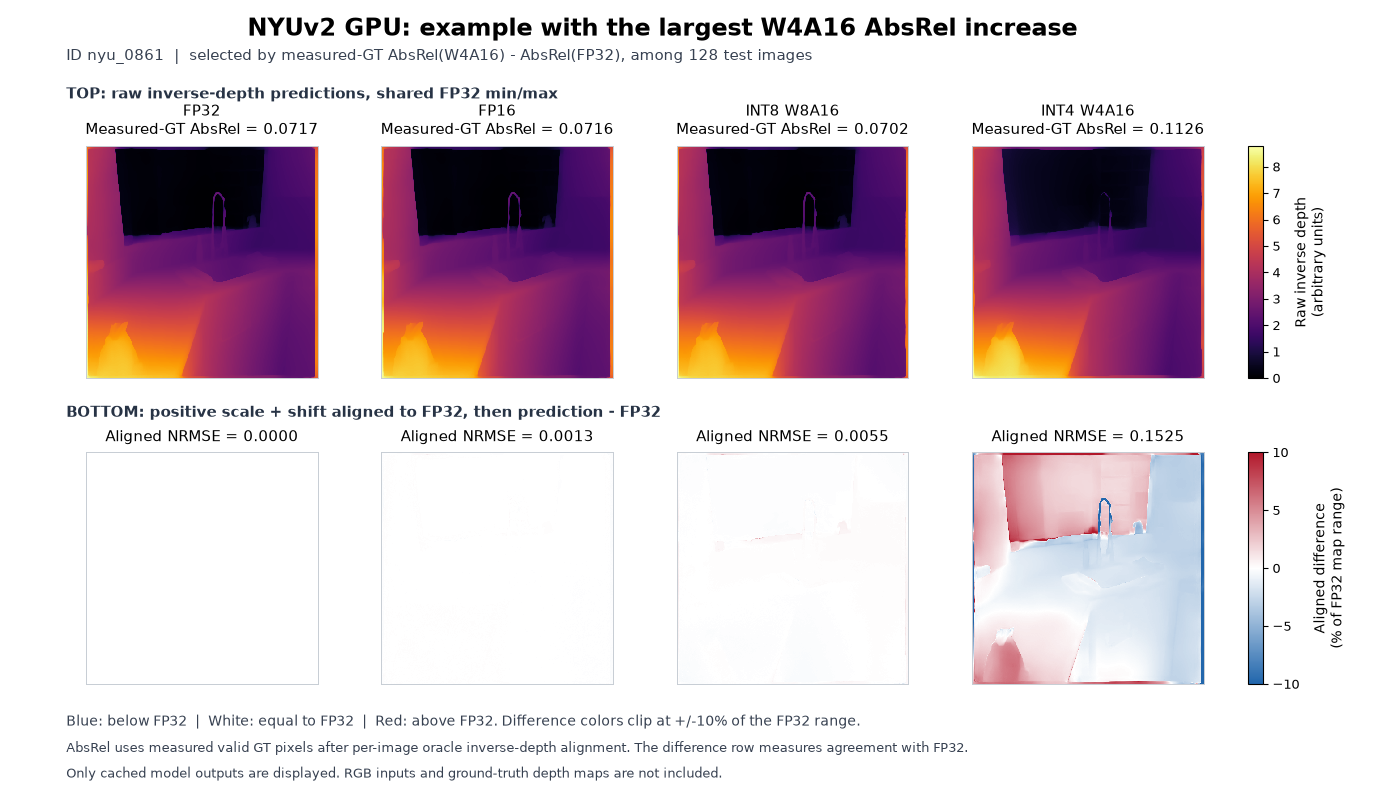
また、GTの正答を維持しても深度画像が同じとは限りません。暗い室内と明るい窓が写った画像では、INT8でもFP32との差が大きくなりました。全画像の平均だけでなく、使う写真で細部を見る必要があります。
GPUでは、まずFP16を比較に入れる
次はRTX 5070 Tiです。CPU版をそのまま流すだけでなく、途中の浮動小数点計算をFP16へ変えた版も用意しました。
W8A16は、対象の重みを8bit、途中の浮動小数点値を16bitにした構成。W4A16は対象重みが4bitです。ここでのWとAは、それぞれ重みと計算途中の値を表す目印です。モデル全体が一律に整数演算になるという意味ではありません。
| モデル | ONNX容量 | CPU上の入出力を使う時間 | 入出力をGPU上へ置く時間 |
|---|---|---|---|
| FP32 | 94.36 MiB | 12.89 ms | 12.56 ms |
| FP16 | 47.26 MiB | 6.47 ms | 6.12 ms |
| dynamic INT8 | 33.89 MiB | 59.36 ms | 62.00 ms |
| INT4、途中の値はFP32 | 26.02 MiB | 13.48 ms | 13.11 ms |
| INT4、内部INT8近似を許可 | 26.02 MiB | 13.54 ms | 13.12 ms |
| W8A16 | 28.28 MiB | 6.44 ms | 6.13 ms |
| W4A16 | 18.15 MiB | 6.48 ms | 6.12 ms |
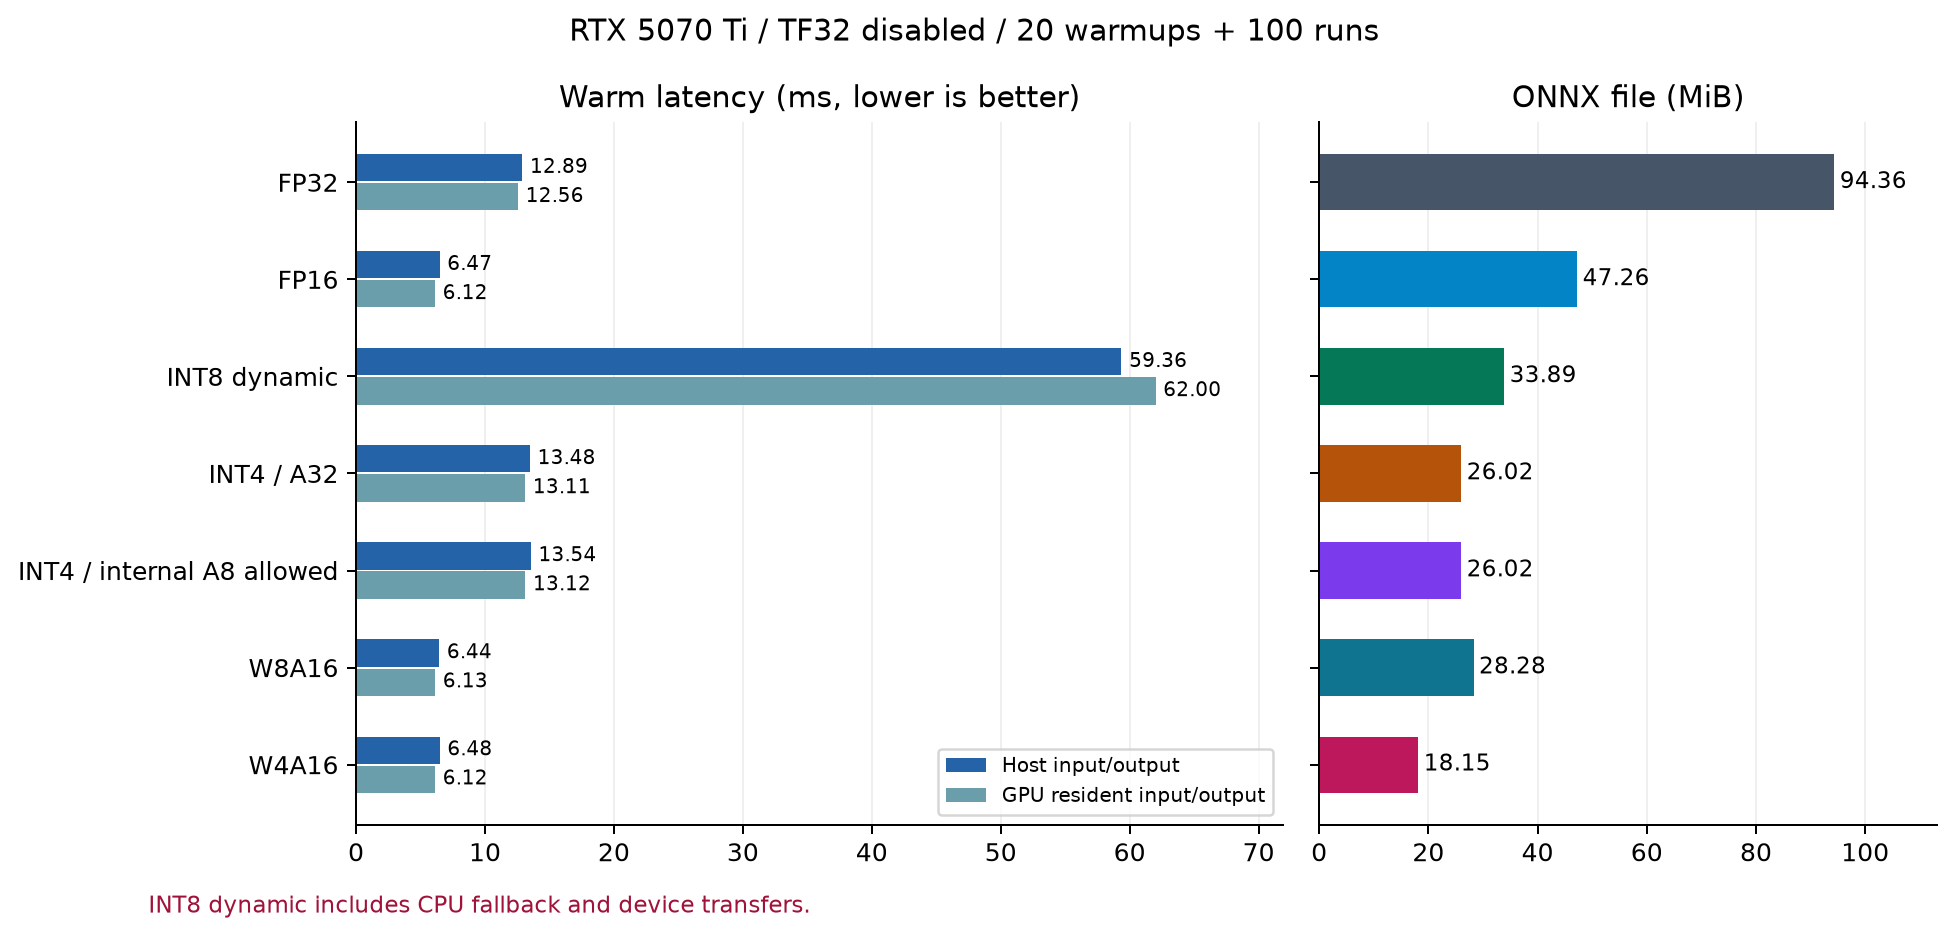
FP16、W8A16、W4A16は約6.4 msへまとまりました。数十マイクロ秒の差で、この3つの速度順位を決めるのは無理があります。今回のGPUで整数化する理由は、FP16よりさらに容量を減らしたいかどうかです。W4A16は18.15 MiBまで小さくなりました。
時間は20回ウォームアップした後の100回の中央値で、TF32は無効にしました。TF32はFP32の行列計算を別の精度・経路で速くする設定です。今回はFP32との比較に混ぜないため、ONNX Runtimeのuse_tf32=0を指定しています。モデル読込、初回呼び出し、画像の前後処理は、この表には含めていません。
入出力をGPU上へ置く方は、I/O BindingでCUDA上の入力と出力を指定し、完了を待って計測しました。単にGPU処理をキューへ入れるまでの時間ではありません。
CUDAが使えても、全演算がGPUとは限らない
dynamic INT8が遅い理由を探るため、時間の計測とは別にONNX Runtimeの実行記録を取りました。
その結果、DynamicQuantizeLinearとMatMulIntegerが各48個、CPU上で実行されていました。残りのGPU演算との間を行き来するので、小さくなった重みだけを見ても処理全体は速くなりません。Provider一覧にCUDAExecutionProviderがあることと、すべての演算がCUDAへ割り当てられたことは別でした。
providers=[
    ("CUDAExecutionProvider", {"use_tf32": 0}),
    "CPUExecutionProvider",
]
後ろのCPU Providerは、CUDAが扱えない演算の受け皿にもなります。これを含む実行はGPU専用のINT8推論とは呼べません。配布コードでは、実行記録から演算名とProviderを数え、results_gpu/benchmark.jsonへ保存しています。
W8A16/W4A16など、ほかの比較モデルの計算演算はCUDAへ割り当てられていました。ただし、MatMulNBitsという演算があるだけで、ネイティブのINT4/INT8 Tensor Coreを使ったとまでは分かりません。内部で重みを戻してFP16の行列計算へ渡す経路もあり得ます。ここで確認したのは配置と所要時間です。
近遠判定で見えなかった差を、画素ごとのGTで調べる
DA-2Kは2点の順序を調べるための正解データです。窓の奥行きや壁の起伏が変わっても、その2点の順序が同じなら正答のままです。そこで、画素ごとの正解深度を持つNYUv2とMPI Sintelでも比較しました。
先に、ここで測る「精度」をはっきりさせます。V2 Smallの通常版が返すのは、値が大きいほど近い相対的な逆深度です。出力の21や1.6に、そのままメートルを付けられません。V2論文も、倍率と切片に自由度のある逆深度を予測すると説明しています。
今回は各画像のGTを使い、予測の倍率と切片をGTの逆深度へ最小二乗で合わせました。倍率は負にならないようにします。正解を見ながら整合した後の形の評価なので、未知の写真から絶対距離を当てられた、という結果ではありません。この条件は全モデルで共通です。
実測GTと補完GTでは、量子化後の順位が変わった
NYUv2は公式テスト654画像からseed42で128画像を抽出しました。Kinectの実測値をRGBへ投影したrawDepthsと、欠損を補完したdepthsが別々にあります。実測の有効画素は約69.10%、補完した方は100%でした。補完された残りの画素まで、センサーが独立に測った値ではありません。
AbsRelは、各画素で「距離の差の絶対値÷正解距離」を求めたときの平均です。まず各画像の有効画素で平均し、次に128画像の値を平均しました。表には100倍せず、そのまま載せています。小さい方が誤差は少なくなります。有限な0 < depth < 10 mを全モデル共通の有効画素(mask)にし、元画像480×640を切り抜かず評価しました。
| CPUのモデル | 実測GTのAbsRel ↓ | 補完GTのAbsRel ↓ |
|---|---|---|
| FP32 | 0.051792 | 0.088964 |
| dynamic INT8 | 0.052307 | 0.088124 |
| INT4、途中の値はFP32 | 0.055520 | 0.087340 |
| INT4、内部INT8近似を許可 | 0.055582 | 0.087484 |
実測GTで見ると、CPUのINT8はFP32からAbsRelが約0.000515増えました。撮影場所(scene)単位で再抽出した95%信頼区間は[+0.000090, +0.000935]で、0を含みません。近遠判定で「正答から誤答へ変わったペアが0組」でも、画素ごとの誤差は増えていました。容量と速度の利点に対して、この小さな誤差増を許容できるかがCPU側の判断になります。
GPUのFP16系も、同じ128画像で比べます。
| GPUのモデル | 実測GTのAbsRel ↓ | 補完GTのAbsRel ↓ | 実測GTのδ1 ↑ |
|---|---|---|---|
| FP32 | 0.051792 | 0.088964 | 97.56% |
| FP16 | 0.051757 | 0.088932 | 97.57% |
| W8A16 | 0.051731 | 0.089035 | 97.57% |
| W4A16 | 0.055508 | 0.087291 | 97.28% |
δ1は、予測と正解の大きい方を小さい方で割った比が1.25未満になる画素の割合です。こちらは高い方がよく、表では100倍して%にしています。
FP16とW8A16の実測GTの数値はFP32にごく近いものでした。わずかに誤差が下がっていますが、別の写真でも改善するかは分かりません。W4A16では実測GTのAbsRelが約0.003717増え、その差の95%信頼区間は[+0.001938, +0.005596]でした。一方、補完GTだけを見ると、W4A16の方が低い誤差に見えます。両者はGTの値だけでなく有効画素も違い、倍率と切片もそれぞれの有効画素で別々に合わせています。補完の有無だけでは原因を切り分けられませんが、評価方法によって順位が変わる結果でした。採用判断では実測側を主に見ます。
ここでの信頼区間は、同じ撮影場所の画像をひとまとめにして重複を許して再抽出するbootstrapで求めました。128画像には95のsceneが含まれます。同じ場所の画像は似ているため、画素数の多さだけでは比較の確かさを判断できません。
差が大きかった1枚も載せます。平均だけでなく、4bitで変わった部分を見るための例です。
Sintelでは、距離へ戻すと誤差が膨らんだ
Sintelは合成映像をレンダリングした深度なので、センサーの穴を色から埋めたGTとは違います。23シーケンスから計64画像を選び、有効な約2857万画素を使いました。元画像は436×1024、切り抜きなしです。
元データには背景相当の約1e11という値があるため、有限な0 < depth < 10000 mだけを評価します。全画素の99.97355%を残し、約0.02645%を除きました。この上限は実験側で決めた条件で、公式の標準規則ではありません。背景相当値を除く深度の最大値約3364 mは残っています。配布深度がカメラ軸方向のZか光線方向の距離かは一次資料で確定できず、配布値は変換せず使いました。
この広い距離範囲では、逆深度の整合後に0付近や負になる予測が一部ありました。距離は逆数なので、0へ近づくと値が膨らみます。今回は逆深度の下限を1/10000にし、その画素も落とさず評価しました。下限処理された割合も一緒に記録しています。
| GPUのモデル | 逆深度NRMSE ↓ | δ1 ↑ | 距離へ戻したAbsRel ↓ | 下限処理した画素 |
|---|---|---|---|---|
| FP32 | 0.413164 | 65.47% | 4.9512 | 1.489% |
| FP16 | 0.413102 | 65.45% | 4.9445 | 1.488% |
| W8A16 | 0.412991 | 65.58% | 4.9809 | 1.493% |
| W4A16 | 0.423222 | 67.11% | 4.4796 | 2.915% |
逆深度NRMSEは、整合後の逆深度のRMSEを、GT逆深度の標準偏差で割った値です。逆数へ戻す前の差を見るので、ここでは主にこちらを使います。
W4A16は逆深度NRMSEが0.413164から0.423222へ増えましたが、δ1は上がり、距離側のAbsRelは下がっています。下限処理される画素も約2倍になりました。このAbsRelだけを見て「4bitの方が正確」とは言えません。逆数と下限処理の影響が大きく、指標ごとに違う面を拾っています。
W4A16とFP32の逆深度NRMSE差について、シーケンス単位で再抽出した95%信頼区間は[-0.004198, +0.023870]です。観測値の増加はありましたが、この64画像から全シーンで誤差が増えるとまでは決められません。Sintelは合成映像、NYUv2は屋内実写で、距離範囲も違います。
今回は抽出した画像を正方形入力にし、切り抜きなし、独自の評価範囲とGT整合で測っています。公式標準スコアや論文の順位表とは直接比較できません。
FP8は27.03 MiBになったが、この実装では遅かった
INT8と同じ8bitでも、FP8は浮動小数点です。今回は符号1bit・指数4bit・仮数3bitのE4M3FNを使いました。FP16より刻みは粗くなり、扱う値の範囲に合わせたスケールも必要です。ONNXのFP8解説に、形式ごとの表現範囲がまとまっています。
対象はこれまでと同じ48個の定数重みMatMulです。重みと入力の両方をFP8にするW8A8にし、ほかの部分は既存のFP16モデルの構成を保ちました。外部の入出力はFP32です。前の表のW8A16は整数の8bit重みでしたが、ここでのW8A8は重み・入力ともに浮動小数点の8bitです。
入力のスケールを決める校正には、NYUv2の公式train 795画像からseed43で選んだ64画像・58撮影場所を使いました。公式test 654画像とは画像IDも撮影場所も重複せず、GTの値は校正に使っていません。各層で、重みはテンソル全体の最大絶対値、入力は校正64画像での入力テンソルの最大絶対値からスケールを決める、単純なMax校正です。屋内画像だけで校正しているため、Sintelのように分布が違う画像で使う場合は、この条件も含めて結果を読む必要があります。
実行にはONNX Runtime 1.31.0のGemmFloat8を使いました。FP8の重み・入力をcuBLASLtというNVIDIAの行列計算ライブラリへ渡し、FP16の結果を返す経路です。内部の設定はFP32 compute typeと高速累積(FAST_ACCUM=1)で、計算の全過程をFP32精度に保つ設定ではありません。実行記録では48個のGemmFloat8と他の計算演算がCUDAへ割り当てられ、CPU側の計算は0個でした。GPUの命令単位の追跡までは行っていません。
今回のFP8モデルはONNXの演算仕様の版であるopset 21で作ったため、FP16も同じ版へ公式変換して比較しました。変換前後のFP16出力は、評価用の計192画像すべてで完全一致しました。以下の時間は、このFP16とFP8を交互に測り直した値です。前のGPU表の100回測定とは分けています。
| モデル | ONNX容量 | CPU上の入出力を使う時間 | 入出力をGPU上へ置く時間 |
|---|---|---|---|
| FP16、opset 21 | 47.26 MiB | 6.45 ms | 6.08 ms |
| FP8、48層のW8A8 | 27.03 MiB | 45.50 ms | 45.02 ms |
518×518・batch 1・TF32無効・CPU 8スレッドは共通です。FP16→FP8→FP8→FP16と、FP8→FP16→FP16→FP8を使って3ラウンド測り、各ブロックで20回ウォームアップして100回計測しました。各モデル・入出力方式につき計600回の中央値です。モデル読込や実行記録の取得は含めず、GPU上の入出力も完了を待って計測しています。
容量は減りましたが、CPU上の入出力を使う時間は約7.1倍になりました。3ラウンドともFP8の方が遅くなっています。ORTのGemmFloat8実装には、呼び出しごとの同期、cuBLASLt用資源の生成、一時領域の確保・解放が入っています。45.50 msはこれらの準備も含む時間です。TensorRTなどで層をまとめて最適化した場合のFP8速度は、別の比較になります。
正解深度は前と同じNYUv2 128画像とSintel 64画像です。有効画素の選び方、元解像度への復元、GTによる逆深度の倍率・切片整合、画像ごとの平均も同じです。両モデルに共通する全有効画素で評価しました。
| データとGT | 指標 ↓ | FP16 | FP8 | FP8−FP16の差の95%信頼区間 |
|---|---|---|---|---|
| NYUv2、実測 | AbsRel | 0.051757 | 0.052491 | [+0.000165, +0.001315] |
| NYUv2、補完 | AbsRel | 0.088932 | 0.091257 | [+0.001697, +0.002953] |
| Sintel、レンダリング | 逆深度NRMSE | 0.413102 | 0.415166 | [−0.002063, +0.005614] |
差は正なら誤差増加で、信頼区間は撮影場所・シーケンスをまとめて再抽出したものです。NYUv2の実測GTではAbsRelが約0.000734増え、区間も0を含みません。δ1はいずれも約97.6%でした。大まかな合格画素の割合がほぼ同じでも、誤差の平均には差が出ています。
Sintelの逆深度NRMSEは少し増えましたが、差の信頼区間は0を含みます。距離に戻したAbsRelは4.9445から5.3814、逆深度を下限処理した画素の割合は1.488%から1.727%へ増えました。こちらは先ほど説明した逆数と下限処理の影響もあるので、AbsRelだけで採用を決めず、逆深度側の指標と合わせて見ます。
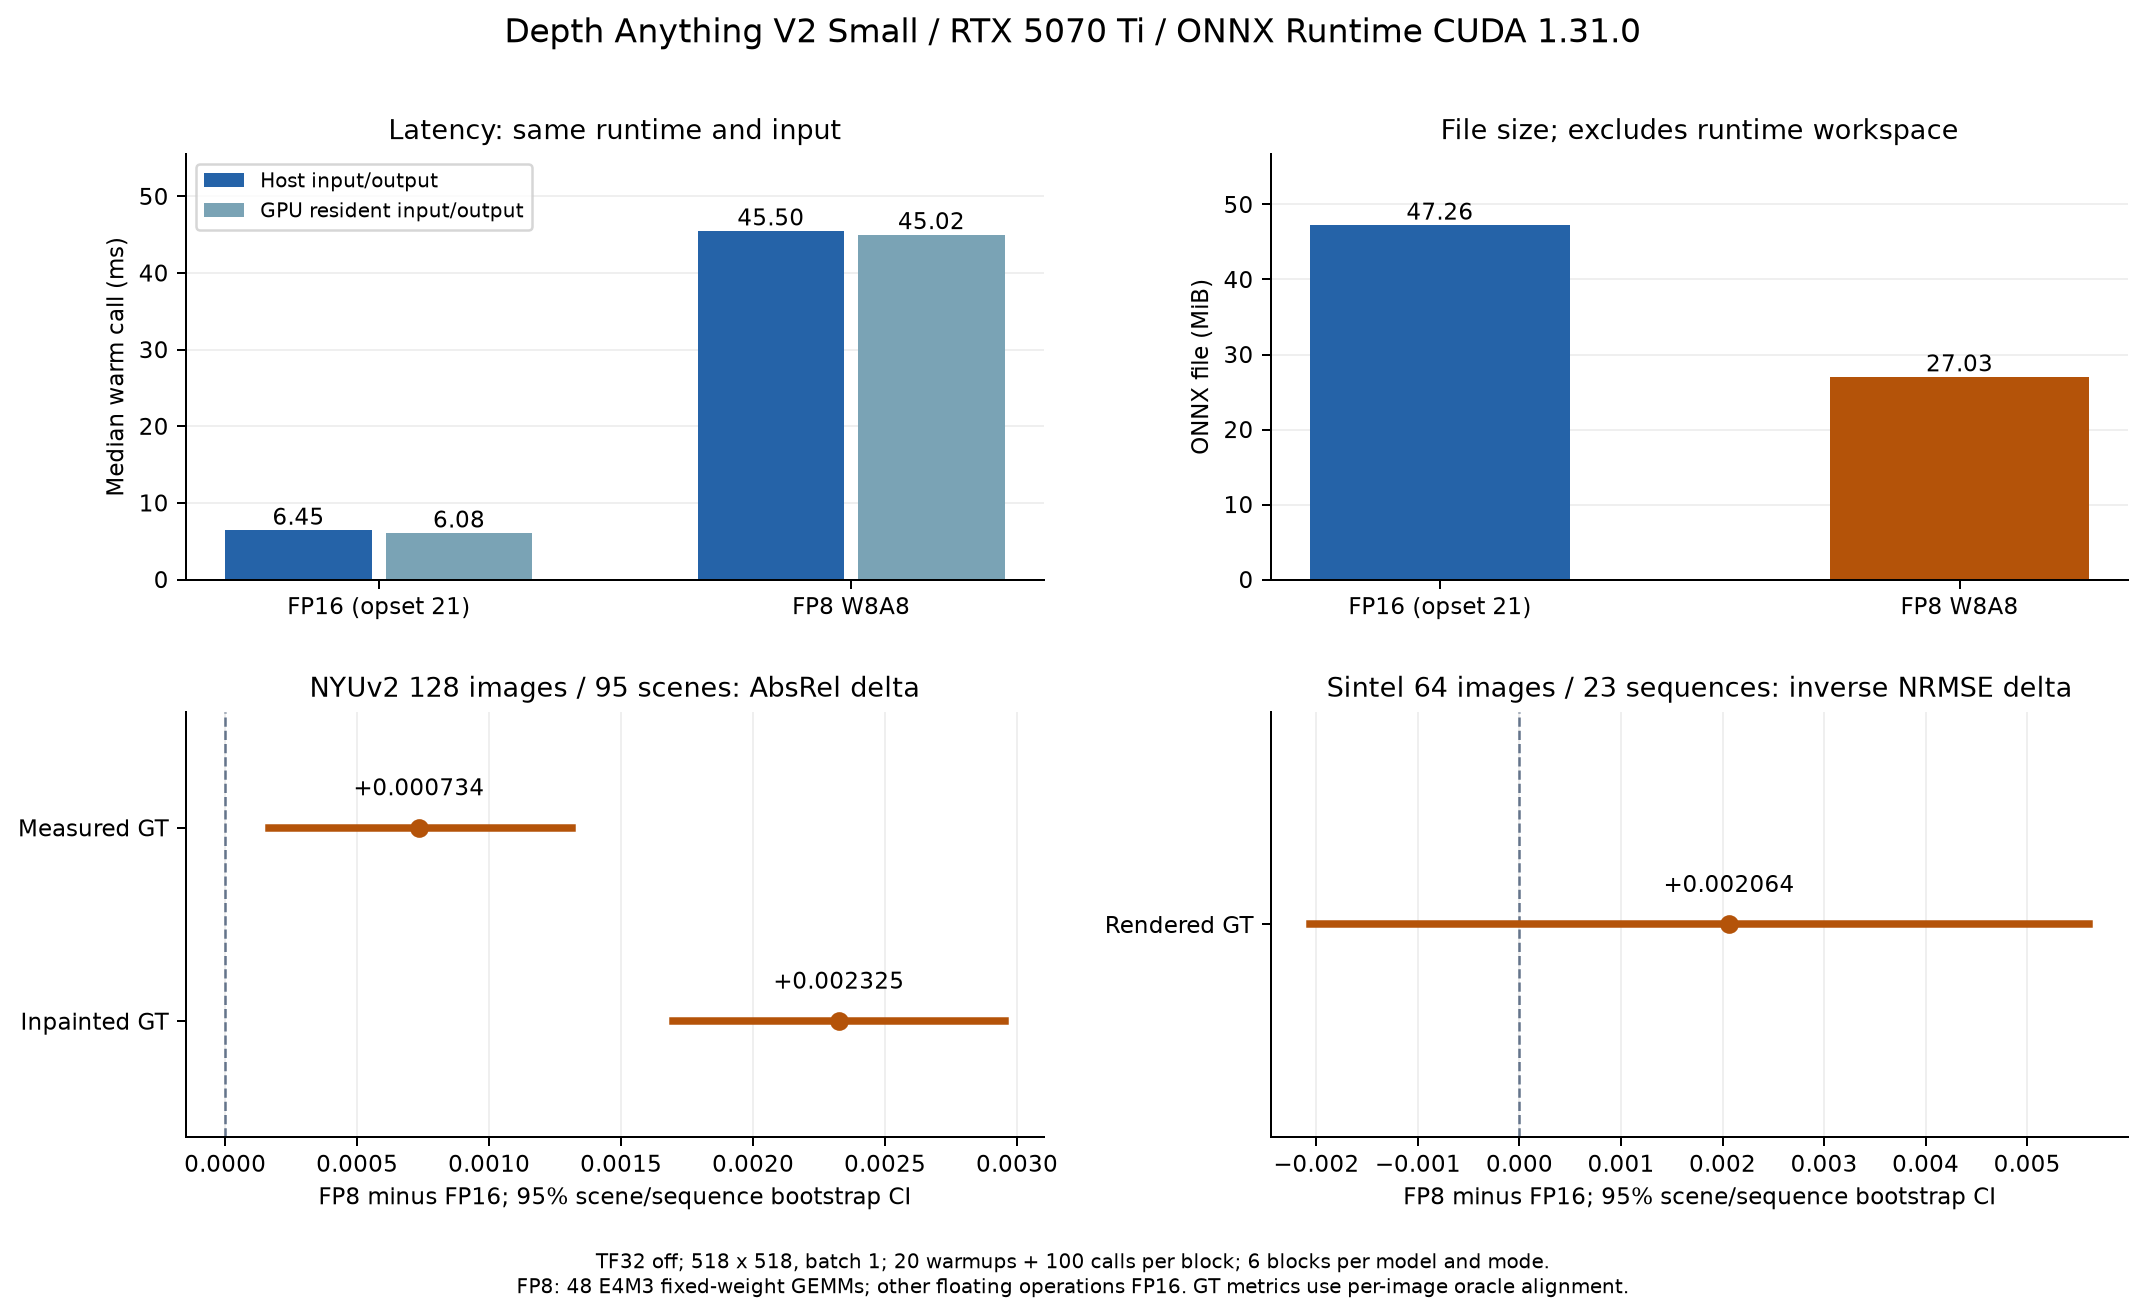
このMax校正・48層W8A8・ORTの構成では、FP16から速度を落としてまでFP8へ変える理由は見つかりませんでした。ファイル容量を優先する場合も、実測GTに対する小さな誤差増を含めて選ぶことになります。
再現コードのREADMEに、データ準備から校正、モデル生成、速度・GT評価までの手順を追加しました。FP16用に用意した環境とデータを使い、追加の依存パッケージなしで実行できます。以下は校正データの準備後に使うコマンドです。
.venv_gpu/Scripts/python.exe scripts/build_fp8_models.py
.venv_gpu/Scripts/python.exe scripts/benchmark_fp8.py
量子化したのは48個の定数重みMatMul
Smallの公式重みをそのまま読み、公式のforwardを変更せずにONNXへ変換しました。seed42の乱数入力でPyTorchとFP32 ONNXを照合したところ、最大絶対差は約0.000004、RMSEは約0.0000013でした。
INT8とINT4で対象にしたのは、入力の片側が固定の重みになっている48個のMatMulです。ONNXに保存された重みなどの定数(initializer)のFP32要素のうち、約85.9%が対象でした。畳み込みや正規化、attention内の可変入力同士の行列積まで、すべて整数にしたわけではありません。
dynamic INT8は出力チャネルごとに重みを符号付き8bitへ写し、途中の値を推論時に符号なし8bitへ写します。静的量子化で使う事前の校正画像は要りません。以前の小型CNNを静的INT8へ量子化した記事とは、この方式もモデルも違います。
INT4は32要素ごとのブロックで対称に量子化し、最も近い値へ丸めました。accuracy_level=1は途中のFP32を保持する設定、4は内部でINT8近似を許可する設定です。ONNX Runtimeの仕様でも、この違いを確認できます。
なお、4bitの版がFP32ファイルのちょうど8分の1にならないのは、対象外の重みや補助のスケール値も保存するためです。保存ファイルが18 MiBでも、推論時のGPUメモリー使用量が18 MiBになるわけではありません。
手元で同じ比較を動かす
実験機はWindows 11、Core i7-14700F、RAM 32 GB、RTX 5070 Ti 16 GB、NVIDIAドライバー610.88です。CPU用はPython 3.12.14、ONNX Runtime 1.31.0、NumPy 2.5.2、PyTorch 2.14.1+cpu。GPU用もPython 3.12.14、ONNX Runtime GPU 1.31.0で、CUDA 13とcuDNN 9のライブラリを別環境へ入れました。パッケージの詳細な版はリポジトリの固定requirementsに残しています。
必要なのはPython 3.12、Git、インターネット接続です。CPUだけでも試せます。GPU比較はCUDA対応GPUとドライバーを追加で使います。環境やデータ、生成物を含む空き容量は20 GB程度を見込みます。通常の実行に管理者権限や再起動は要りませんが、Pythonやドライバーを新たに導入する場合は別です。
コードは記事用リポジトリの実験フォルダーにあります。PowerShellで次のように取得します。
git clone --branch depth-anything-v2-quantization --single-branch https://github.com/matrizea/yuyuyuroom-ai-experiments.git ai-experiments
cd ai-experiments/experiments/depth-anything-v2-quantization
そのフォルダーのREADMEに従って、CPU用の仮想環境と公式モデル実装を用意します。公式実装は、READMEで指定したcommitの版を使います。
.venv/Scripts/python.exe scripts/build_models.py
.venv/Scripts/python.exe scripts/compare_image.py --image "C:/photos/example.jpg" --output-dir results/custom
自分の画像を1枚比べるなら、2行目のパスを替えます。comparison.jpgと数値のJSON、表示加工前の深度配列が出ます。この画像には正解データがないので、確認できるのはFP32との違いです。
No module named depth_anything_v2が出た場合は、READMEの公式リポジトリ取得が抜けていないか確認します。CUDAが使えない場合は、CPU用Pythonを呼んでいないか、GPU用のProvider一覧にCUDAが現れるかを先に見ます。環境全体を入れ直す前に、まず今使っているPythonを確認します。
このPCでは、古いシステム側のVCランタイムが使われると、確認用のimport onnxruntimeだけでも異常終了しました。配布手順ではvenv内のMSVC DLLを先に読むruntime_initを使います。下の確認コマンドにも含めているので、この部分を抜かずに実行します。
再現確認で深いフォルダーへvenvを作ったときには、パッケージ導入でWinError 3も出ました。こちらはWindowsのパス長制限です。短い作業場所へ環境を作り直すと導入できました。エラーの種類が違うので、DLLの先読みだけでは直りません。
.venv_gpu/Scripts/python.exe -c "import sys; sys.path.insert(0,'scripts'); import runtime_init; import onnxruntime as ort; print(sys.executable); ort.preload_dlls(directory=''); print(ort.get_available_providers())"